LLM locales
Los LLM locales son modelos de lenguaje que se ejecutan directamente en tu propio hardware — un portátil, un PC con GPU o un servidor casero — sin nube, sin suscripciones y sin que los datos salgan de tu máquina. Ollama, llama.cpp y LM Studio, junto con las versiones GGUF cuantizadas de Llama, Qwen y Gemma, lo hacen posible incluso en una tarjeta gráfica de hace una década. Aquí está toda nuestra cobertura sobre ejecutar IA en local: guías, pruebas de hardware, cuantización y privacidad.
WebBrain: agente de AI open-source para navegador funciona sin nube y sin suscripción
WebBrain es un agente gratuito con licencia MIT para Chrome y Firefox que lee páginas y automatiza tareas, funcionando de forma local mediante llama.cpp u Ollama.
NVIDIA TensorRT ahora escala la inferencia de AI generativa en múltiples GPU
NVIDIA añadió a TensorRT soporte nativo para múltiples GPU — los modelos de generación de contenido multimedia escalan en producción sin perder las optimizaciones…
7 Mejores Modelos de Codificación para Ejecución Local en 2026: Qwen, DeepSeek y Otros
Una revisión de siete modelos de IA de código abierto para programación que se ejecutan en tu GPU en 2026 — desde variantes ligeras de 7B hasta modelos potentes de…
DeepSeek lanzó DSpark — un framework que acelera la generación con DeepSeek-V4 en un 57–85%
Liquid AI lanzó LFM2.5-230M: 213 tokens/s en Galaxy S25 y soporte para llama.cpp
Agente de IA local en lugar de administrador de sistemas: análisis autónomo de logs de servidor
Claude Code y modelos locales: cero costo para tareas rutinarias de desarrollo
Cómo Construir un Espacio de Trabajo de Agentes en QwenPaw con Habilidades Personalizadas y API de Streaming
Tutorial paso a paso para desplegar QwenPaw — un framework para crear agentes de IA con soporte para múltiples proveedores de modelos, habilidades personalizadas y…
Niteshift de veteranos de Datadog: codificación de IA contra el lock-in de Big Tech
Niteshift, una startup fundada por veteranos de Datadog, recaudó $7 millones para desarrollar una plataforma de agentes de IA que permite a las empresas no depender…
El Ministerio de Transformación Digital registró el primer asistente de IA para funcionarios en el registro de software ruso
Comparación de modelos TTS 2026: de comerciales a abiertos
Ollama en lugar de ChatGPT: ahorramos dinero, privacidad y el planeta
El nuevo CompileIQ de NVIDIA descubre el potencial oculto de los núcleos GPU mediante el ajuste automático de parámetros del compilador
Cómo los investigadores eludieron la protección en modelos de IA: simple y peligroso
Los investigadores descubrieron que las limitaciones integradas en modelos de IA se pueden eludir fácilmente mediante una modificación simple. Esto plantea serias…
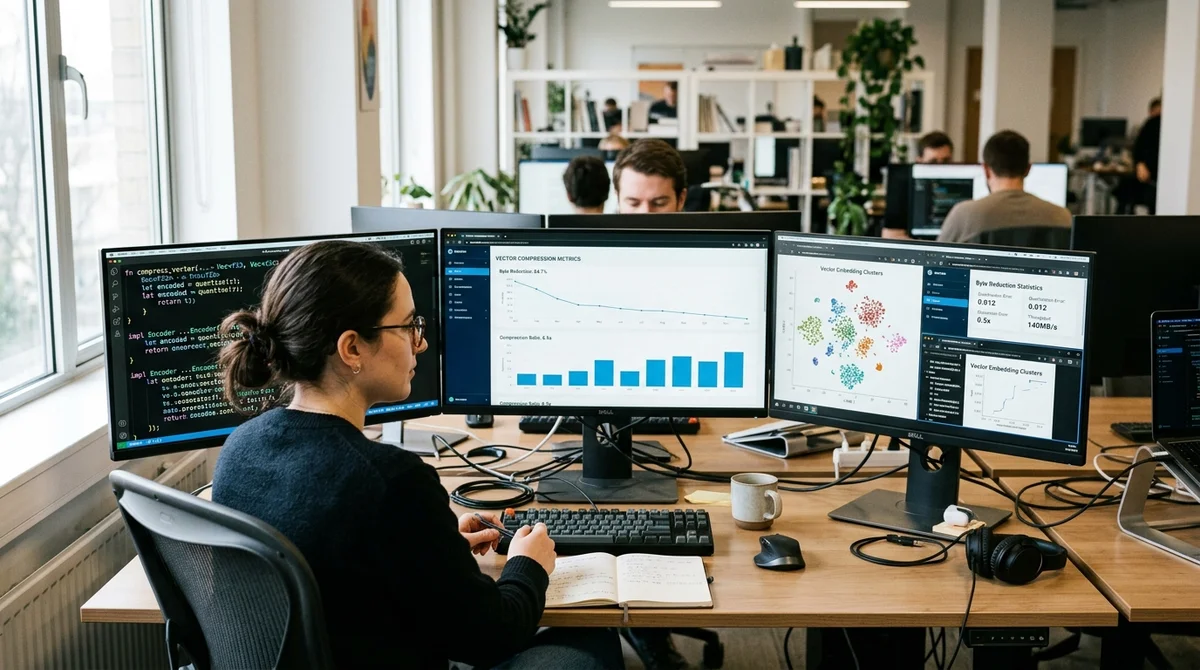
Turbovec: índice vectorial en Rust con el algoritmo TurboQuant de Google Research
Turbovec utiliza el algoritmo TurboQuant de Google para comprimir vectores 16x sin entrenamiento previo, lo que simplifica el despliegue de aplicaciones RAG.