Hugging Face
Hugging Face es el GitHub del aprendizaje automático: la plataforma que aloja millones de modelos abiertos, datasets y demos. Su biblioteca Transformers y sus rankings abiertos la convirtieron en el centro de gravedad de la IA de código abierto. Toda nuestra cobertura sobre Hugging Face está en esta página.
Alibaba libera Qwen3.6-35B-A3B — un modelo MoE multimodal centrado en la codificación orientada a agentes
Hugging Face publicó Ecom-RLVE, un entorno de entrenamiento para agentes de AI de comercio electrónico
Google, Kling y Yandex: dónde generar video con AI gratis en 2026 y con qué límites
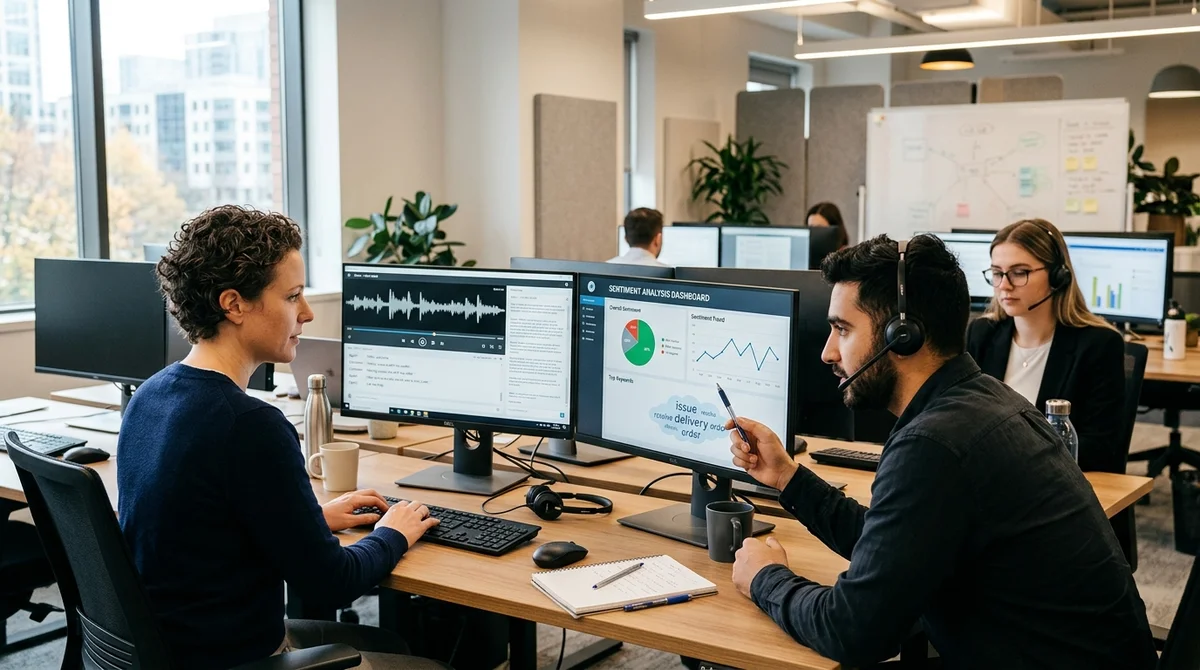
KDnuggets publicó una guía sobre análisis local de llamadas con Whisper, BERTopic y Streamlit
KDnuggets analizó un proyecto open-source que transcribe grabaciones de llamadas de clientes con Whisper, detecta sentimiento y emociones, y luego agrupa los temas…
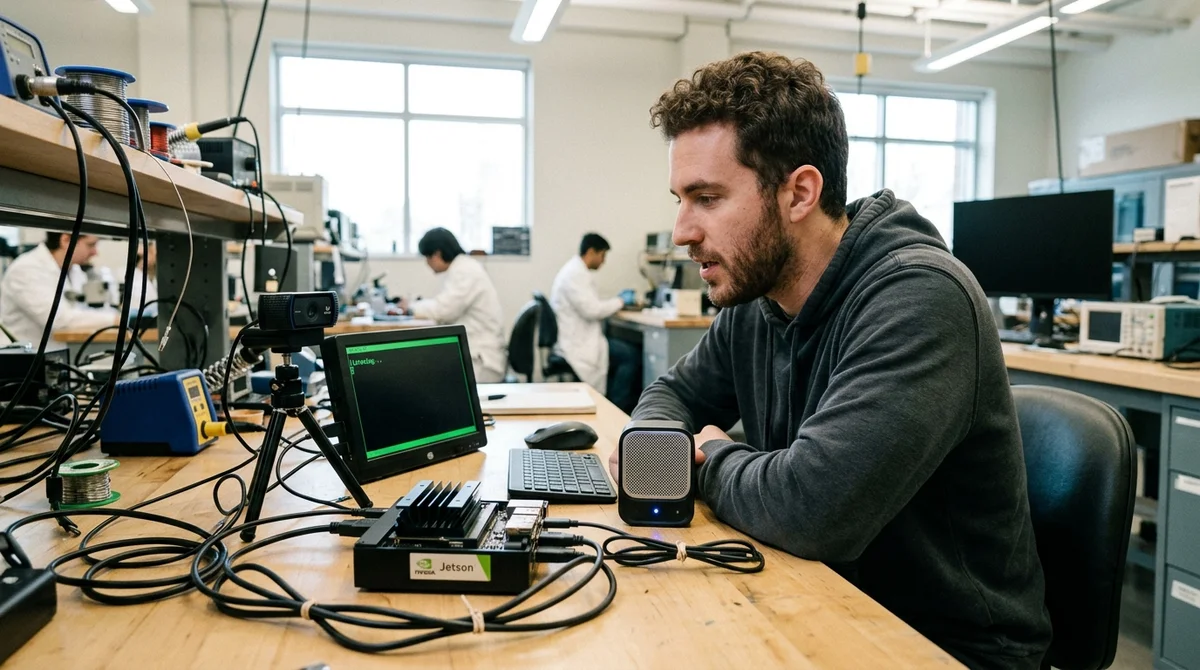
NVIDIA mostró cómo Gemma 4 con voz y cámara web funciona en Jetson Orin Nano Super
NVIDIA publicó una demo en la que Gemma 4 decide por sí sola cuándo activar la cámara web y responde por voz: todo se ejecuta localmente en Jetson Orin Nano Super…
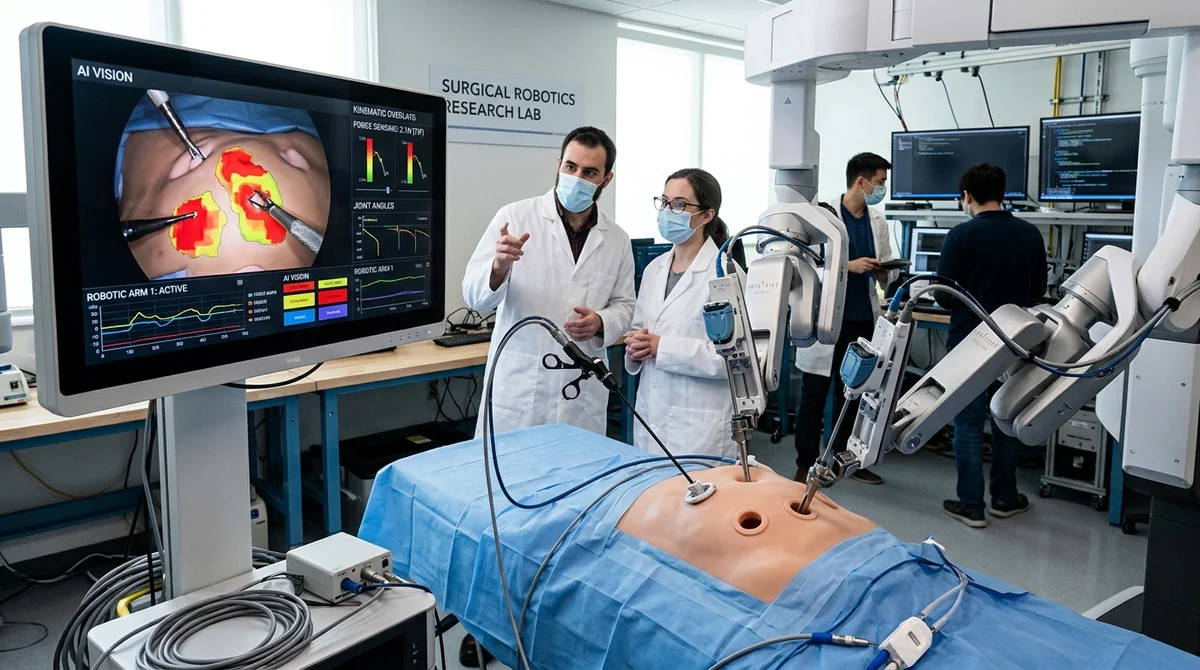
Nvidia presentó el primer dataset abierto y modelos fundacionales de AI para robots médicos
Nvidia y sus socios en Hugging Face abrieron el primer gran dataset para robots médicos y lanzaron dos modelos fundacionales para cirugía, simulación y autonomía…
Hugging Face mostró cómo construir un agente de IA de pronóstico del tiempo en smolagents en 15 minutos
Microsoft GraphRAG y Ollama: cómo se desempeñó el RAG basado en grafos en modelos locales
Meta FAIR Lanza NeuralSet — Paquete Python para Conectar Datos Neurales y Modelos de IA
La Evaluación de Modelos de IA Cuesta Más Que Su Entrenamiento — Una Nueva Barrera para Investigadores
Hugging Face y ModelAudit: la investigación reveló los límites de la protección integrada de modelos ML
Un experimento en modelos de Hugging Face mostró que ModelAudit detecta señales peligrosas adicionales, pero frecuentemente genera ruido, y la precisión de los…
IBM revela cómo construyó Granite 4.1: 15 billones de tokens, contexto de 512K y apuesta por calidad
IBM detalló su enfoque para entrenar Granite 4.1: cinco etapas de preentrenamiento, 15 billones de tokens, ventana de contexto hasta 512K y canales separados de SFT…
SenseTime abre el modelo SenseNova U1 para chips chinos, apostando por velocidad
LlamaIndex ParseBench: cómo probar análisis de documentos a través de Python y Hugging Face
smol-audio de Deep-unlearning: Una colección de notebooks de Colab para ajuste fino de modelos de audio
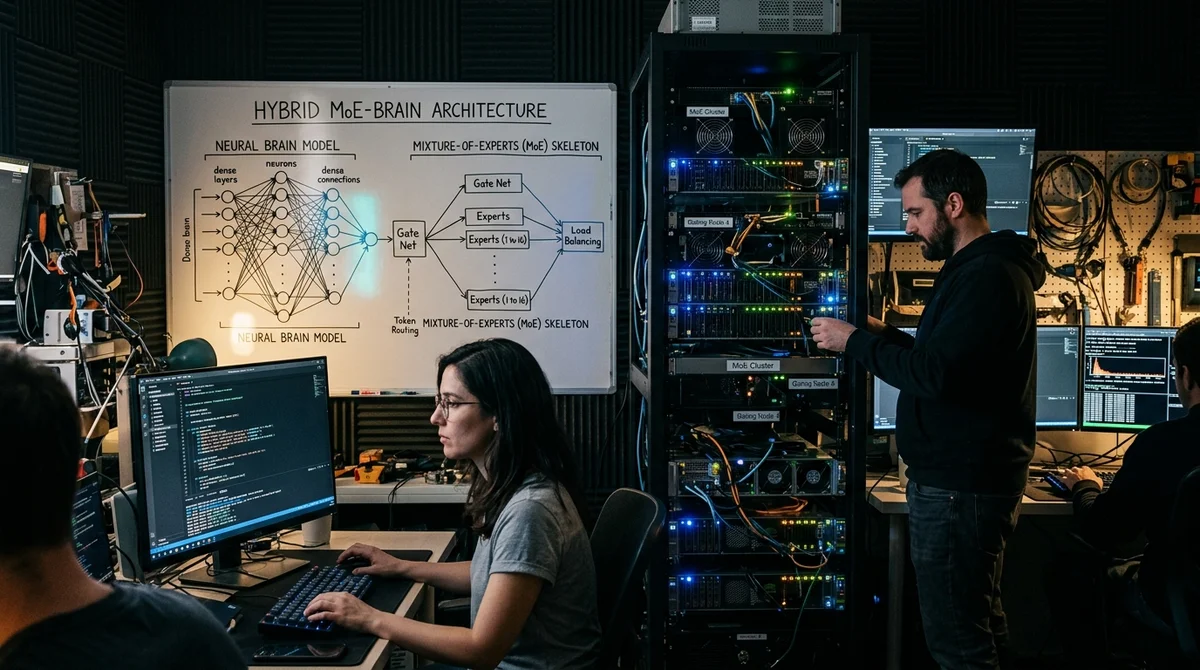
DeepSeek y Gemma: Cómo un Experimento de LLM Híbrido en Kaggle Rompió la Biblioteca Transformers
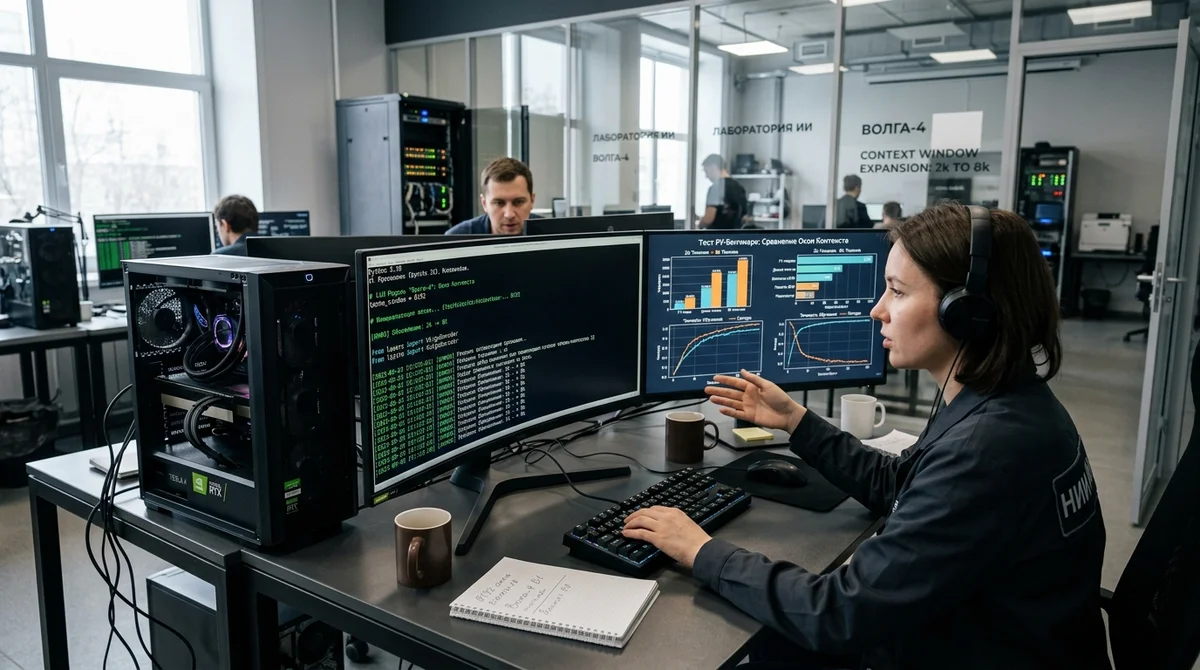
ruGPT3XL Gana Contexto de 8k: Modelo Restaurado Supera Límite de 2k con Pérdidas Mínimas
El autor de la restauración de ruGPT3XL corrigió sparse attention, aumentó el contexto del modelo de 2k a 8k y preservó la calidad en secuencias cortas con…
Arcee AI Lanzó Trinity Large Thinking — Modelo de Razonamiento Abierto para Agentes IA
Arcee AI liberó los pesos de Trinity Large Thinking bajo licencia Apache 2.0 y apuesta por escenarios de agentes largos, razonamiento multietapa y uso seguro de…