Anthropic crea una herramienta que traduce los 'pensamientos' de Claude a lenguaje humano
Anthropic ha presentado Natural Language Autoencoders, un método que transforma las activaciones internas de Claude en explicaciones de texto. La técnica permite ver en tiempo real cómo el modelo procesa la información y toma decisiones, y convierte la caja negra de la red neuronal en un mecanismo transparente. En lugar de adivinar a partir de la respuesta final, los investigadores pueden mirar qué "piensa" el modelo por dentro.
Procesado por IA desde MarkTechPost; editado por Hamidun News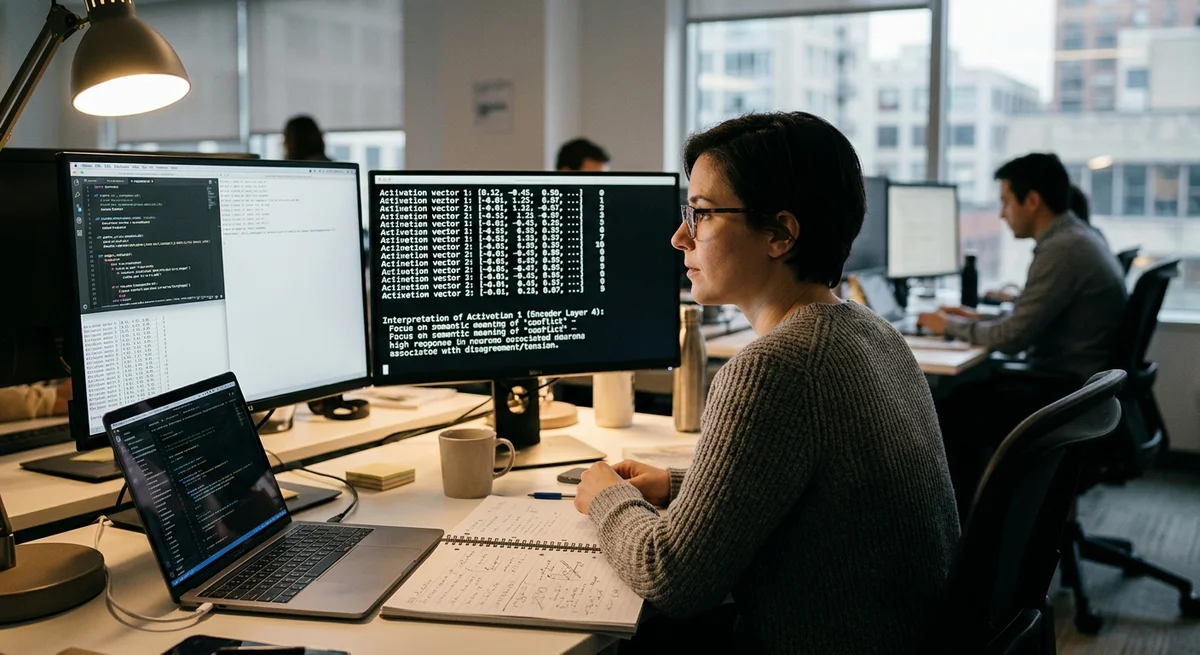
Anthropic ha desarrollado Natural Language Autoencoders, una técnica nueva que traduce las activaciones internas de la red neuronal Claude a explicaciones de texto. Eso significa que ahora se puede ver qué "piensa" el modelo por dentro, en lugar de adivinarlo a partir de la respuesta final.
¿Qué son los Natural Language Autoencoders?
Cuando le escribes un mensaje a Claude, este pasa por una cadena de transformaciones ocultas. El texto se codifica en vectores largos de números llamados activaciones. Es en ese nivel donde el modelo analiza el significado, conecta información y toma decisiones.
El problema es que, para una persona, esos vectores son solo números. Anthropic ha creado una herramienta que toma esas representaciones numéricas y las convierte de nuevo en lenguaje natural: explicaciones comprensibles de lo que ocurrió en cada etapa del procesamiento.
¿Cómo funciona?
Los Natural Language Autoencoders trabajan en dos etapas. Primero, un codificador comprime las activaciones del modelo en una representación compacta. Después, un decodificador despliega esa representación en texto.
La idea central es que las explicaciones en texto resultan mucho más informativas para el análisis que intentar interpretar los vectores en bruto. En lugar de montones de números, se obtienen frases como "el modelo notó que es una pregunta de matemáticas" o "aquí hay que comprobar el contexto del mensaje anterior".
¿Por qué es importante?
La interpretabilidad de los modelos es uno de los principales problemas de la IA. Hasta ahora, las redes neuronales han seguido siendo en su mayoría cajas negras. Con esta herramienta, Anthropic avanza hacia la transparencia:
- Depuración: se puede ver en qué etapa el modelo empezó a equivocarse
- Seguridad: es más fácil detectar comportamientos indeseados a nivel de activaciones
- Entrenamiento: los investigadores comprenden mejor la lógica interna del modelo
- Confianza: la transparencia refuerza la confianza de los usuarios en la IA
¿Qué significa?
Los Natural Language Autoencoders no son solo un proyecto de investigación. Son un primer paso práctico para que los grandes modelos de lenguaje dejen de ser cajas negras. Cuanto mejor entendemos cómo piensan las redes neuronales, mejor podemos controlarlas y mejorarlas. Para los desarrolladores, esto abre nuevas posibilidades de diagnóstico y optimización.
- 1 nov 2026Los modelos locales pierden ante Opus y Codex: 0,21 puntos en un MacBook frente a 1,00 de Codex
- 1 nov 2026Kimi logra un 96,2 % en un test de analítica sobre una base de 1C y se perfila como plan B ante un bloqueo de Claude
- 1 nov 2026OpenAI reescribe las reglas de comportamiento de GPT: cinco valores y una cadena de prioridades
- 1 nov 2026Google admite que AI Mode reduce los ingresos de su buscador: las acciones caen un 15%
Preguntas frecuentes sobre la noticia
¿Qué son los Natural Language Autoencoders?
Cuando le escribes un mensaje a Claude, este pasa por una cadena de transformaciones ocultas. El texto se codifica en vectores largos de números llamados activaciones. Es en ese nivel donde el modelo analiza el significado, conecta información y toma decisiones. El problema es que, para una persona, esos vectores son solo números. Anthropic ha creado una herramienta que toma esas representaciones numéricas y las convierte de nuevo en lenguaje natural: explicaciones comprensibles de lo que ocurrió en cada etapa del procesamiento.
¿Cómo funciona?
Los Natural Language Autoencoders trabajan en dos etapas. Primero, un codificador comprime las activaciones del modelo en una representación compacta. Después, un decodificador despliega esa representación en texto. La idea central es que las explicaciones en texto resultan mucho más informativas para el análisis que intentar interpretar los vectores en bruto. En lugar de montones de números, se obtienen frases como "el modelo notó que es una pregunta de matemáticas" o "aquí hay que comprobar el contexto del mensaje anterior".
¿Por qué es importante?
La interpretabilidad de los modelos es uno de los principales problemas de la IA. Hasta ahora, las redes neuronales han seguido siendo en su mayoría cajas negras. Con esta herramienta, Anthropic avanza hacia la transparencia: Depuración: se puede ver en qué etapa el modelo empezó a equivocarse Seguridad: es más fácil detectar comportamientos indeseados a nivel de activaciones Entrenamiento: los investigadores comprenden mejor la lógica interna del modelo Confianza: la transparencia refuerza la confianza de los usuarios en la IA
¿Qué significa?
Los Natural Language Autoencoders no son solo un proyecto de investigación. Son un primer paso práctico para que los grandes modelos de lenguaje dejen de ser cajas negras. Cuanto mejor entendemos cómo piensan las redes neuronales, mejor podemos controlarlas y mejorarlas. Para los desarrolladores, esto abre nuevas posibilidades de diagnóstico y optimización.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.