Agregadores de LLM: cómo elegir modelos gratuitos que funcionen y no mentir sobre el resultado
Elegir un modelo gratuito de una lista parece sencillo. En la práctica, la mitad de los modelos es inestable, algunos desaparecen del listado del proveedor y la calidad varía. La solución no es un catálogo interminable, sino un backend más inteligente: limpieza de la lista, health checks, fallback entre marcas y un campo `actual_model` honesto en la respuesta.
Procesado por IA desde Habr AI; editado por Hamidun News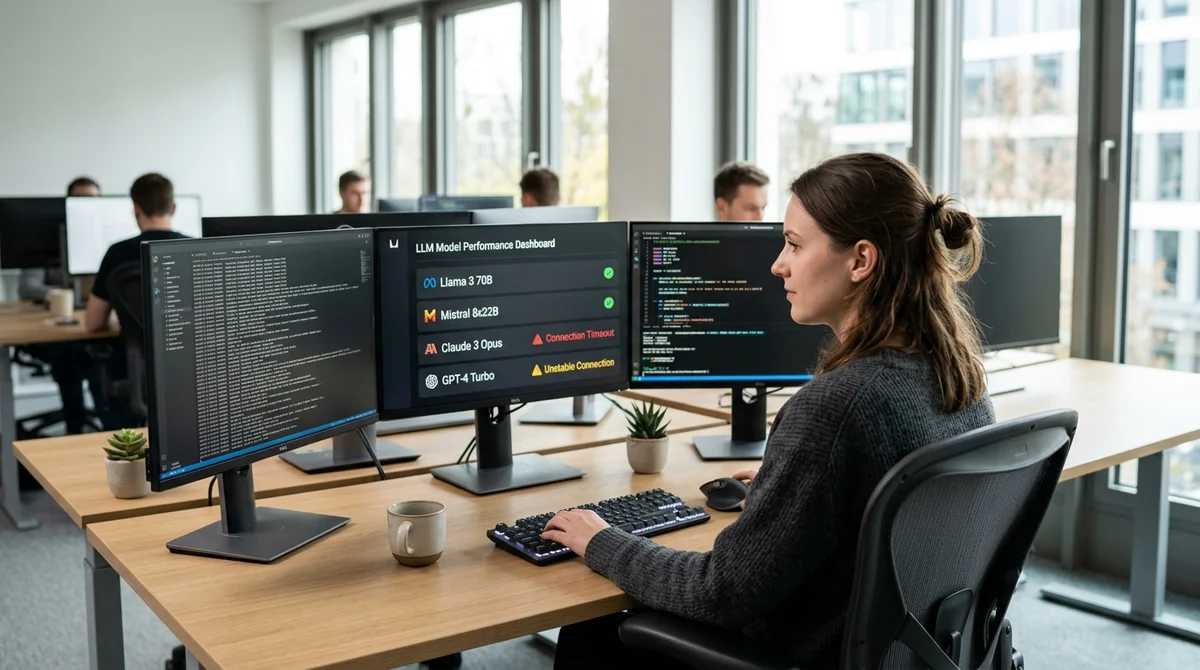
Cuando un proyecto incorpora un selector de LLM, lo más habitual es tomar el camino más obvio: una lista grande de modelos, el usuario elige uno y se envía la solicitud. A corto plazo funciona. A largo plazo empieza a romperse.
Dónde falla el enfoque simple
Los problemas aparecen no en la interfaz, sino en el comportamiento de los proveedores y de los propios modelos:
- Modelos gratuitos inestables — figuran como gratuitos, pero responden de forma irregular y se caen durante el downtime del proveedor
- Modelos que desaparecen — ayer estaban en el listado; hoy el proveedor los eliminó o los cerró a nuevos usuarios
- Caída de calidad — formalmente activo, pero sirve solo para demos o tareas sencillas
- Desajuste entre frontend y backend — la lista de la interfaz está desactualizada uno o dos días, mientras el backend conoce otra realidad
- Errores y redirecciones — se pidió un modelo y llegó un error, o la respuesta vino de un modelo completamente distinto
El mayor problema: la interfaz no sabe qué modelo respondió realmente. El usuario eligió Claude 3.5, pero la respuesta vino de Gemini, y el usuario no se entera. Eso genera confusión: si la calidad de la respuesta no coincide con el modelo elegido, el usuario pierde la confianza.
Un circuito de ingeniería estricto en lugar de un catálogo
La solución no se basa en una lista interminable, sino en el control desde el backend:
Paso 1: limpieza de la lista. El backend recibe la lista en bruto de modelos del proveedor y la filtra: conserva solo las opciones gratuitas adecuadas, descarta las inestables y elimina duplicados. Se pueden añadir health checks, que consultan periódicamente cada modelo para ver si sigue vivo.
Paso 2: un modelo por marca. Aunque OpenAI tenga 5 modelos gratuitos en su listado, al frontend llega uno solo: el más estable. Esto simplifica la elección del usuario y reduce la probabilidad de caer en un mal modelo.
Paso 3: fallback entre marcas. Durante una solicitud real, si el primer modelo devuelve un error, el sistema prueba automáticamente con el segundo y luego con el tercero. El usuario no se entera del fallo; para él solo tarda un poco más.
Paso 4: honestidad en la respuesta. Se devuelve no solo el texto generado, sino también actual_model, el modelo que realmente lo generó. Así la interfaz puede decirle al usuario con honestidad: «Respuesta de GPT 4o mini, porque el modelo principal estaba en downtime».
«El problema no es cómo mostrar con elegancia una lista de modelos.
El problema es cómo construir un sistema que elija modelos gratuitos que funcionen y no mienta sobre el resultado» — esa es la esencia de la tarea.
Esto convierte un catálogo inestable en un circuito predecible. Si un proveedor elimina un modelo, el backend lo detecta en la siguiente comprobación y actualiza la lista en el frontend. Si un modelo se cae, se activa el fallback y el usuario recibe una respuesta de otro proveedor.
Qué significa esto
Elegir un LLM deja de ser una tarea de interfaz y pasa a ser una tarea de ingeniería, con limpieza de datos, health checks, lógica de fallback y seguimiento honesto. Para el producto, eso significa fiabilidad y menos consultas a soporte. Para el usuario, la elección funciona, las respuestas llegan y la interfaz no miente.
- 2 nov 2026El marco AICG de NC State redujo un 50,3% el MAE al evaluar respuestas matemáticas
- 2 nov 2026Revisamos 929 automatizaciones en Alpina: cómo debería ser la formación corporativa en IA en 2026
- 2 nov 2026Interrogué a 6 redes neuronales sobre mí como lo haría un comprador corporativo: Amazon, esoterismo, «Telo Judelo» y 5 agujeros que cerramos en un día
- 2 nov 2026TJ Digital: el 23% de las páginas que cita la IA empiezan con una respuesta directa, frente al 14% de las que no cita
Preguntas frecuentes sobre la noticia
Dónde falla el enfoque simple?
Los problemas aparecen no en la interfaz, sino en el comportamiento de los proveedores y de los propios modelos: Modelos gratuitos inestables — figuran como gratuitos, pero responden de forma irregular y se caen durante el downtime del proveedor Modelos que desaparecen — ayer estaban en el listado; hoy el proveedor los eliminó o los cerró a nuevos usuarios Caída de calidad — formalmente activo, pero sirve solo para demos o tareas sencillas Desajuste entre frontend y backend — la lista de la…
¿Qué se sabe sobre Un circuito de ingeniería estricto en lugar de un catálogo?
La solución no se basa en una lista interminable, sino en el control desde el backend: Paso 1: limpieza de la lista. El backend recibe la lista en bruto de modelos del proveedor y la filtra: conserva solo las opciones gratuitas adecuadas, descarta las inestables y elimina duplicados. Se pueden añadir health checks, que consultan periódicamente cada modelo para ver si sigue vivo. Paso 2: un modelo por marca. Aunque OpenAI tenga 5 modelos gratuitos en su listado, al frontend llega uno solo: el más estable.
¿Qué se sabe sobre Qué significa esto?
Elegir un LLM deja de ser una tarea de interfaz y pasa a ser una tarea de ingeniería, con limpieza de datos, health checks, lógica de fallback y seguimiento honesto. Para el producto, eso significa fiabilidad y menos consultas a soporte. Para el usuario, la elección funciona, las respuestas llegan y la interfaz no miente.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.