5 modelos abiertos pequeños con tool calling: agentes que no necesitan la nube
Los modelos de lenguaje pequeños ya saben llamar funciones y manejar herramientas, una capacidad clave para los agentes de IA descentralizados. En lugar de recurrir a servicios en la nube, ahora es posible ejecutar modelos compactos en local con soporte completo de tool calling y llamadas estructuradas. Los cinco modelos seleccionados son abiertos y compactos. Además, están listos para desplegarse en servidores y dispositivos sin conexión a internet.
Procesado por IA desde KDnuggets; editado por Hamidun News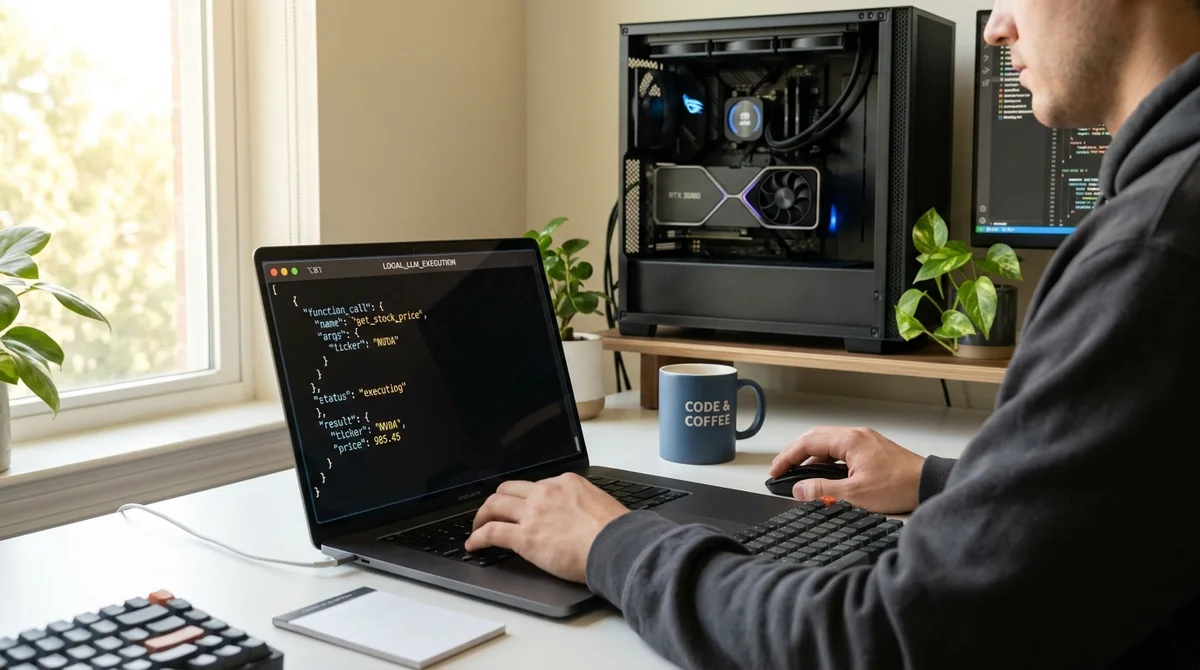
Durante mucho tiempo, los modelos de lenguaje pequeños no podían competir con los servicios en la nube en una habilidad clave: el manejo de herramientas mediante tool calling. Eso está cambiando. Ha surgido una generación de modelos compactos y abiertos que admiten llamadas estructuradas a funciones y, a la vez, siguen siendo lo bastante ligeros para desplegarse en local.
Qué es el tool calling y por qué funciona
El tool calling (llamada a herramientas) es la capacidad de un modelo para invocar directamente funciones externas, scripts o API, en lugar de limitarse a escribir código como respuesta. El modelo recibe una lista de funciones disponibles con su descripción, sus parámetros y sus tipos de datos. Con esa información decide por sí mismo qué función llamar y con qué argumentos.
Esto es crucial para los agentes AGI: pueden gestionar bases de datos, descargar archivos, enviar correos o reservar reuniones, todo sin intervención humana directa. La salida estructurada (respuestas con forma de JSON) garantiza que el modelo devuelva el resultado en un formato correcto y predecible, que el programa pueda parsear y seguir utilizando. Hasta hace poco, solo los modelos grandes (GPT-4, Claude 3) lo hacían de forma estable.
Ahora los modelos pequeños también han aprendido a generar JSON estructurado sin fallos.
Por qué los modelos pequeños ya son competitivos
Los modelos pequeños (de 7B a 13B parámetros) tienen varias ventajas frente a los grandes. Son más baratos de desarrollar y de ejecutar en inferencia, más privados por defecto (no envían datos a la nube) y responden más rápido. No requieren servicios en la nube ni hardware corporativo potente: basta con una GPU de gama media o incluso con una CPU decente.
Si a un modelo pequeño se le añade soporte de tool calling, el resultado es un agente de IA completo que puede ejecutarse en un servidor propio, en un portátil o incluso en un smartphone sin internet. Esto abre la puerta a agentes corporativos privados con garantía de confidencialidad de los datos. Una empresa puede ejecutar un agente dentro de su red segura sin enviar ni una sola petición a la nube.
A esto se suma la flexibilidad de licencias: todos estos modelos son abiertos y pueden usarse con fines comerciales sin pedir permiso.
5 modelos listos para usar
Estos son cinco modelos pequeños que ya hoy admiten tool calling completo:
- Llama 3.1 (Meta): versión base de 8B con buena documentación y ejemplos de tool calling; la más probada y estable de la lista
- Mistral 7B: compacto, muy rápido y con un buen equilibrio entre calidad y tamaño; popular en entornos enterprise
- PhiLM 3 (Microsoft): optimizado específicamente para salida estructurada y tareas de ingeniería; requisitos de memoria mínimos
- OpenChat 3.5: orientado a funciones y manejo de herramientas; benchmarks sólidos en pruebas de tool calling
- Neural Hermes 2.5 (Mistral con fine-tuning): el que mejor resuelve cadenas complejas de llamadas en varios pasos y la gestión de errores
Los cinco pueden descargarse de Hugging Face en unos minutos y ejecutarse en local sin internet. El tiempo de inferencia (respuesta a una petición) va de 50 a 200 milisegundos en una GPU moderna o una CPU rápida.
Qué significa esto para la industria
La era del monopolio de la nube sobre los agentes de IA ha terminado. Ahora incluso las pequeñas startups y las corporaciones pueden construir agentes de IA privados y completos que no son más lentos ni menos inteligentes que sus equivalentes en la nube, como la API de OpenAI o Claude vía cloud. Esto implica que toda la infraestructura de IA se está trasladando poco a poco de la nube a entornos on-premise.
En los próximos meses esperamos un auge de herramientas y frameworks para el despliegue local de agentes (del tipo de LM Studio u Ollama, pero ya con un soporte de tool calling en condiciones). Para los desarrolladores se abre un mercado completamente nuevo: agentes de IA privados para grandes corporaciones, organismos públicos, medicina y fintech. Es decir, todos los ámbitos donde el uso de la nube está prohibido por motivos políticos o legales.
Ahí, los modelos locales son la única vía.
*Meta ha sido declarada organización extremista y está prohibida en la Federación de Rusia.
- 19 nov 2026La IA de OpenAI mejoró en 5 meses el diseño de GPU de AMD hasta un 14% en energía, velocidad y área
- 19 nov 2026Los agentes de OpenAI resuelven por sí solos el 46% de las tareas de investigación de 2–4 horas; en marzo era el 23%
- 18 nov 2026AWS integra Dynamo en HyperPod: Qwen3-235B pasa de 101 a 207 tokens/s por GPU
- 18 nov 2026El nuevo modelo Jev responde en 150 ms frente a los 1,89 s de GPT-6 Astra
Preguntas frecuentes sobre la noticia
¿Qué se sabe sobre Qué es el tool calling y por qué funciona?
El tool calling (llamada a herramientas) es la capacidad de un modelo para invocar directamente funciones externas, scripts o API, en lugar de limitarse a escribir código como respuesta. El modelo recibe una lista de funciones disponibles con su descripción, sus parámetros y sus tipos de datos. Con esa información decide por sí mismo qué función llamar y con qué argumentos.
¿Qué se sabe sobre Por qué los modelos pequeños ya son competitivos?
Los modelos pequeños (de 7B a 13B parámetros) tienen varias ventajas frente a los grandes. Son más baratos de desarrollar y de ejecutar en inferencia, más privados por defecto (no envían datos a la nube) y responden más rápido. No requieren servicios en la nube ni hardware corporativo potente: basta con una GPU de gama media o incluso con una CPU decente.
¿Qué se sabe sobre 5 modelos listos para usar?
Estos son cinco modelos pequeños que ya hoy admiten tool calling completo: Llama 3.1 (Meta): versión base de 8B con buena documentación y ejemplos de tool calling; la más probada y estable de la lista Mistral 7B: compacto, muy rápido y con un buen equilibrio entre calidad y tamaño; popular en entornos enterprise PhiLM 3 (Microsoft): optimizado específicamente para salida estructurada y tareas de ingeniería; requisitos de memoria mínimos OpenChat 3.5: orientado a funciones y manejo de…
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.