OpenAI presenta MRC, un protocolo de red para entrenar IA en clústeres de 100.000 GPU
OpenAI ha publicado a través del Open Compute Project la especificación de MRC, un nuevo protocolo de red para entrenar modelos de gran tamaño. Divide el tráfico de un mismo intercambio en cientos de rutas, esquiva los fallos con más rapidez y simplifica la arquitectura de red. Según la compañía, MRC ya funciona en sus mayores clústeres con NVIDIA GB200. Permite resistir caídas de enlaces e incluso reinicios de switches sin detener el entrenamiento.
Procesado por IA desde OpenAI Blog; editado por Hamidun News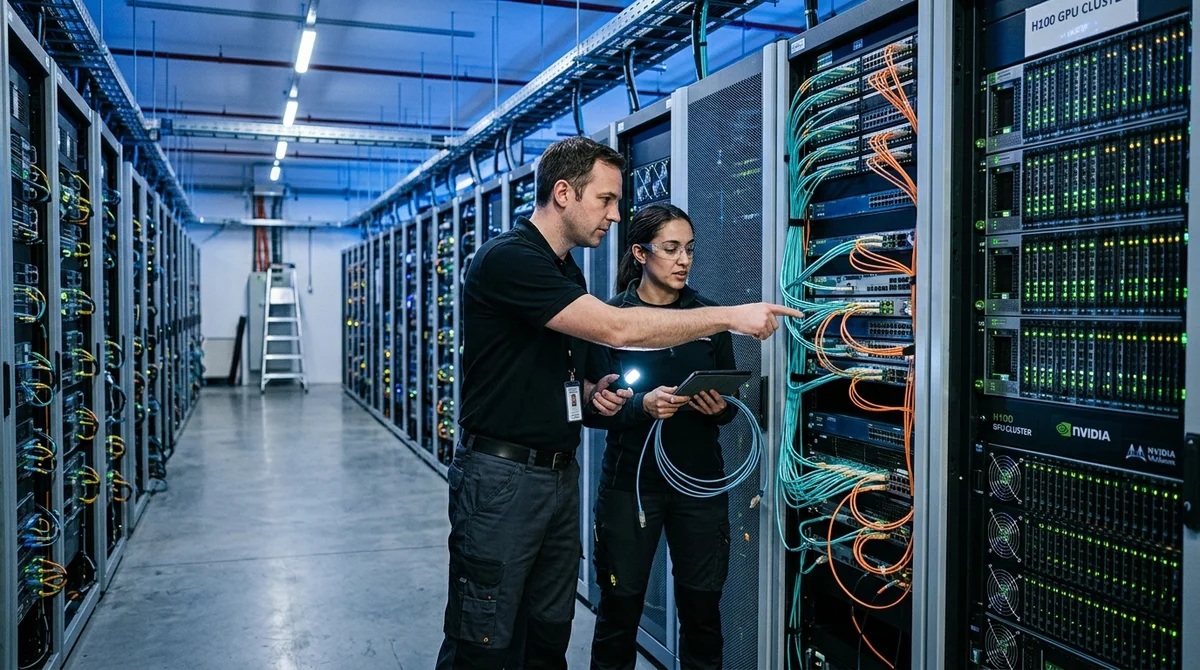
OpenAI ha presentado MRC, un nuevo protocolo de red para los superordenadores en los que se entrenan los grandes modelos de IA. Según la compañía, ya está desplegado en todos sus clústeres más grandes basados en NVIDIA GB200, incluido el centro de OCI en Abilene y los sistemas Microsoft Fairwater, y ayuda a mantener el rendimiento incluso cuando fallan enlaces y switches.
Por qué hacía falta MRC
El entrenamiento de modelos frontier no depende solo de las GPU, sino también de la red que las conecta. En cada paso del entrenamiento se producen millones de intercambios de datos, y basta con que un solo paquete o un solo flujo llegue bastante más tarde que el resto para que parte de los aceleradores se queden ociosos. En clústeres pequeños estos retrasos todavía son asumibles, pero en sistemas del tamaño de Stargate el problema se vuelve estructural: cuantos más nodos, mayor es la probabilidad de congestión, de jitter en la latencia y de fallos de hardware.
Para OpenAI esto ya no es un asunto de ingeniería secundario. La compañía afirma que más de 900 millones de personas usan ChatGPT cada semana, lo que convierte la infraestructura de cómputo en la capa base del servicio. Por eso, durante los dos últimos años, el equipo ha rediseñado la pila de red junto a AMD, Broadcom, Intel, Microsoft y NVIDIA. El objetivo no era solo lograr más velocidad, sino un comportamiento predecible bajo carga y ante averías parciales.
Cómo funciona la red
La idea clave de MRC es dejar de tratar la interfaz de red como un único gran tubo de 800 Gbit/s. En su lugar, OpenAI la divide en varios canales más pequeños: por ejemplo, ocho líneas de 100 Gbit/s, cada una conectada a su propio switch. El resultado es una red multiplano en la que el mismo tráfico puede circular por muchas rutas independientes. Con esta configuración, según los cálculos de OpenAI, se puede montar una red de unas 131.000 GPU con solo dos niveles de switches Ethernet, mientras que el esquema clásico de 800 Gbit/s exigiría tres o cuatro niveles.
Ahí entra en juego el propio protocolo, que amplía la pila RoCE habitual para el entrenamiento de IA. En lugar de enviar todo un intercambio por una sola ruta, MRC «pulveriza» los paquetes de una misma transferencia por cientos de caminos a la vez. Los paquetes pueden llegar desordenados, pero no es un problema: cada uno indica directamente su dirección final en memoria, y el receptor coloca los datos en su sitio a medida que llegan. Así, la red aprovecha de forma más uniforme los canales disponibles y soporta mucho mejor las congestiones locales.
- Un intercambio se reparte entre muchas rutas paralelas a través de distintos planos de red
- Ante señales de congestión, el protocolo retira la ruta problemática y la sustituye por otra
- Si se pierde un paquete, MRC asume rápidamente un fallo y reenvía los datos
- Si un paquete se pierde por congestión en el lado del receptor, entra en juego el packet trimming: se reenvía solo la cabecera para solicitar explícitamente la retransmisión
OpenAI subraya que MRC puede esquivar fallos de red en la escala de microsegundos, mientras que a una fábrica de red tradicional reconfigurar las rutas podía llevarle segundos o incluso decenas de segundos. Esto es especialmente importante en el entrenamiento síncrono, donde cada paso de cómputo no lo marca la transferencia media, sino la más lenta del clúster. Con este equilibrio, varias tareas pueden compartir un mismo clúster con menos riesgo de interferir entre sí.
Qué cambia en la operación
Otro cambio importante es el abandono del enrutamiento dinámico habitual en favor del source routing basado en SRv6. En una red convencional, los propios switches recalculan las rutas mediante protocolos como BGP, lo que añade complejidad y nuevos tipos de fallos. En MRC, el emisor codifica la ruta del paquete en la dirección IPv6, y los switches se limitan a ejecutar ese recorrido paso a paso con tablas estáticas. La idea parece radical, pero según OpenAI es precisamente lo que simplifica el plano de control y elimina la necesidad de corregir constantemente la lógica de red a mano.
Para OpenAI, la práctica pesa más que la teoría, y aquí la compañía aporta cifras concretas. Explica que sus redes de entrenamiento se componen de millones de enlaces y que, en ejecuciones reales, entre los switches tier-0 y tier-1 pueden producirse múltiples cortes breves cada minuto sin un impacto medible en el preentrenamiento síncrono. Durante el entrenamiento de uno de los modelos frontier recientes para ChatGPT y Codex, los ingenieros tuvieron que reiniciar cuatro switches tier-1, y no fue necesario coordinarse con los equipos que en ese momento dirigían el entrenamiento.
Si en una interfaz de red de ocho puertos cae uno, el ancho de banda se reduce como máximo en un octavo, pero la tarea sigue en marcha en lugar de caerse por completo.
Qué significa
MRC demuestra que la carrera por los modelos más potentes se desplaza cada vez más hacia la infraestructura. OpenAI no se limita a acelerar el entrenamiento en sus clústeres: también lleva el protocolo al Open Compute Project para intentar convertir su propia solución de ingeniería en un estándar del sector. Si otros laboratorios y proveedores de nube adoptan este enfoque, los grandes clústeres de IA serán más baratos, más fáciles de operar y más resistentes a los fallos, sin necesidad de ajustar la red a mano de forma constante.
- 1 nov 2026OpenAI reescribe las reglas de comportamiento de GPT: cinco valores y una cadena de prioridades
- 1 nov 2026Google admite que AI Mode reduce los ingresos de su buscador: las acciones caen un 15%
- 31 oct 2026Un autor sometió su guion a un jurado de IA: el veredicto costó 850.000 tokens
- 31 oct 2026Anthropic: unificar subagentes en un solo bucle duplicó la velocidad de las tareas de un cliente
Preguntas frecuentes sobre la noticia
¿Qué se sabe sobre Por qué hacía falta MRC?
El entrenamiento de modelos frontier no depende solo de las GPU, sino también de la red que las conecta. En cada paso del entrenamiento se producen millones de intercambios de datos, y basta con que un solo paquete o un solo flujo llegue bastante más tarde que el resto para que parte de los aceleradores se queden ociosos. En clústeres pequeños estos retrasos todavía son asumibles, pero en sistemas del tamaño de Stargate el problema se vuelve estructural: cuantos más nodos, mayor es la probabilidad de congestión, de jitter en la latencia y de fallos de hardware. Para OpenAI
Cómo funciona la red?
La idea clave de MRC es dejar de tratar la interfaz de red como un único gran tubo de 800 Gbit/s. En su lugar, OpenAI la divide en varios canales más pequeños: por ejemplo, ocho líneas de 100 Gbit/s, cada una conectada a su propio switch. El resultado es una red multiplano en la que el mismo tráfico puede circular por muchas rutas independientes. Con esta configuración, según los cálculos de OpenAI, se puede montar una red de unas 131.000 GPU con solo dos niveles de switches Ethernet, mientras que el esquema clásico de 800 Gbit/s exigiría tres o cuatro niveles. Ahí entra en
¿Qué se sabe sobre Qué cambia en la operación?
Otro cambio importante es el abandono del enrutamiento dinámico habitual en favor del source routing basado en SRv6. En una red convencional, los propios switches recalculan las rutas mediante protocolos como BGP, lo que añade complejidad y nuevos tipos de fallos. En MRC, el emisor codifica la ruta del paquete en la dirección IPv6, y los switches se limitan a ejecutar ese recorrido paso a paso con tablas estáticas. La idea parece radical, pero según OpenAI es precisamente lo que simplifica el plano de control y elimina la necesidad de corregir constantemente la lógica de re
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.