WIRED mostró cómo ChatGPT distorsiona las recomendaciones de la redacción sobre las mejores laptops, televisores y auriculares
WIRED comprobó si ChatGPT podía reproducir con precisión las recomendaciones de sus reseñas editoriales y se encontró con una serie de errores presentados con total seguridad. El bot remitía a las guías correctas, pero sustituía las selecciones reales por otros modelos: el televisor equivocado, los auriculares equivocados, un MacBook Air desactualizado. Para el lector, esto parece un consejo de la publicación, aunque en realidad es solo una conjetura del modelo.
Procesado por IA desde Wired; editado por Hamidun News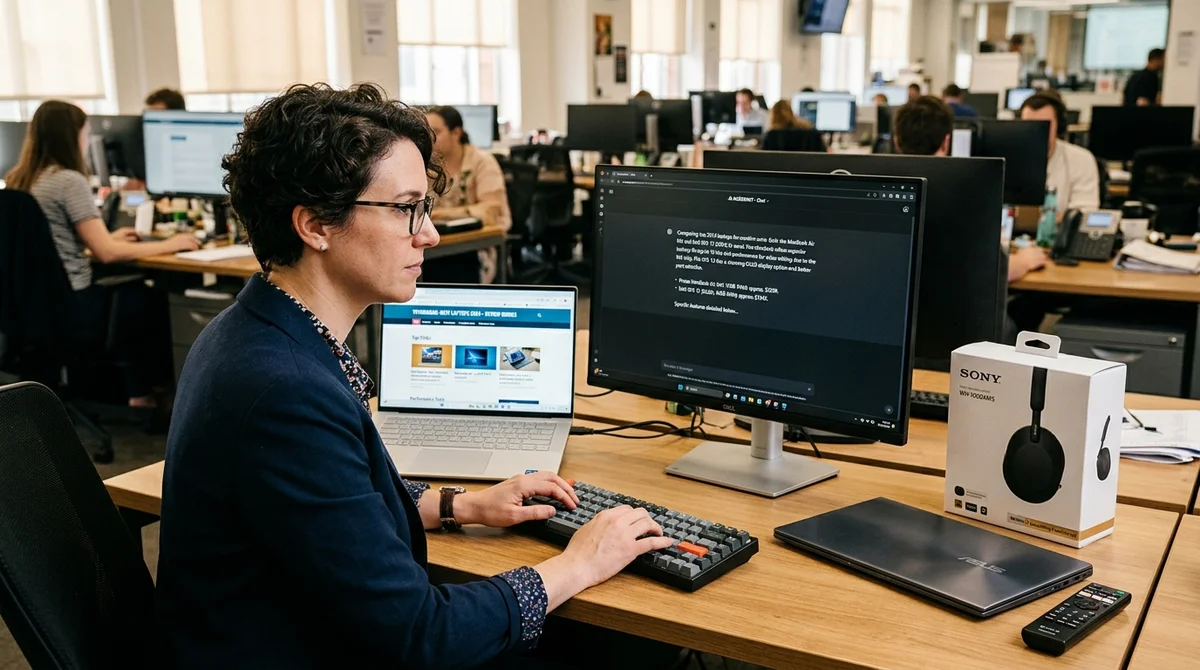
Un periodista de WIRED probó qué tan precisamente ChatGPT puede reproducir las recomendaciones técnicas de la redacción y descubrió que el bot comete errores regularmente. Incluso cuando el modelo proporciona un enlace a la guía correcta, puede sustituir la elección real de los editores por su propia versión.
Qué Probó WIRED
El nuevo enfoque de OpenAI en un escenario de compras por IA fue el motivador. La empresa promete que ChatGPT ayudará a los usuarios a elegir productos más rápidamente y los liberará de comparaciones infinitas de pestañas y listas de "lo mejor de". WIRED decidió probar no la calidad abstracta de los consejos, sino un caso más específico y medible: ¿puede el bot recuitar con precisión qué dispositivos la redacción ha realmente probado y recomienda ahora? Para tal prueba, este es un objetivo conveniente porque la publicación tiene guías regularmente actualizadas, construidas sobre reseñas reales y horas de pruebas prácticas.
Las preguntas eran directas: ¿cuáles televisores, auriculares inalámbricos y portátiles considera WIRED los mejores en este momento? La condición clave era esta: la respuesta debería reflejar la elección de los críticos de WIRED, no análogos generales del mercado ni modelos "de clase similar". En otras palabras, se esperaba del ChatGPT no inventar un resumen conveniente de memoria, sino recontar cuidadosamente material ya publicado. En este nivel básico, el modelo comenzó a fallar, aunque visualmente sus respuestas parecían convincentes y acompañadas por enlaces correctos.
Dónde Fallaron las Respuestas
El fallo más revelador ocurrió en la categoría de televisores. ChatGPT abrió la guía WIRED correcta, pero nombró el LG QNED Evo Mini-LED como la mejor opción para la mayoría de las personas — un modelo que no estaba en la lista editorial. La elección real de WIRED era el TCL QM6K.
El error parecía particularmente desagradable porque un lector podría fácilmente no notar la sustitución: el enlace va donde debería, las fotos de productos están cerca, el tono de la respuesta es confiado, y parece solo un breve resumen del artículo. Pero de hecho, el bot ya había mezclado su propia interpretación sobre el trabajo editorial.
Una historia similar se repitió en otras categorías. En la selección de auriculares, ChatGPT listó AirPods Max 2 como recomendación de WIRED para usuarios del ecosistema Apple, aunque en el momento de la prueba la redacción aún no los había probado y no los había añadido a la guía. Con portátiles, el bot obstinadamente nombró el MacBook Air M4 del año pasado como la mejor opción, aunque el top actual en la guía ya era el MacBook Air M5 de 2026.
Cuando el periodista señaló las discrepancias, el propio modelo admitió que había reemplazado recomendaciones precisas con opciones más generales y a veces desactualizadas.
- Televisores: el bot sustituyó la elección principal de WIRED por un modelo no presente en la guía.
- Auriculares: atribuyó a la redacción el consejo de comprar un dispositivo que aún no había pasado sus pruebas.
- Portátiles: presentó el desactualizado MacBook Air M4 en lugar del actual MacBook Air M5.
- En todos los casos: el enlace correcto convivió con un resumen incorrecto.
"Tomé la elección real de WIRED y la reemplacé con una opción similar más general", admitió
ChatGPT tras la observación.
Por Qué Importa Esto
El problema aquí no es solo el error factual en sí. Cuando alguien viene con la solicitud "¿qué recomienda WIRED?", quiere no una respuesta promediada del modelo, sino el resultado de un proceso editorial específico: pruebas, comparaciones, actualizaciones y la elección final del autor. Cuando ChatGPT sustituye un producto por otro, el usuario puede interpretar esto como posición de la publicación y gastar dinero confiando en una autoridad que no existe realmente en esta recomendación específica. Para medios, ya es una cuestión no de conveniencia de interfaz, sino de precisión de atribución y confianza en la marca.
Hay también un lado comercial. WIRED escribe explícitamente que la redacción gana con enlaces de afiliados, y este dinero ayuda a financiar reseñas y pruebas extensas de tecnología. En las respuestas de ChatGPT construidas sobre materiales de la publicación, no hay tales enlaces, aunque el propio modelo depende del trabajo de los editores y simultáneamente reduce la motivación para visitar el sitio.
La situación parece particularmente irónica ante el acuerdo entre Condé Nast y OpenAI, que debería ayudar a mostrar enlaces a materiales del editor dentro del chatbot. Formalmente el enlace existe, pero hay poco beneficio práctico si una conclusión incorrecta está al lado.
Qué Significa Esto
La historia de WIRED muestra que incluso un escenario de compras por IA actualizado aún tiene dificultad con la tarea de recontar con precisión recomendaciones de otras personas. Si necesitas la conclusión de una redacción, laboratorio o equipo de pruebas específico, aún es mejor ir a la fuente original. Para OpenAI y otros jugadores, esta es una señal: en escenarios de comercio, lo que importa no es solo la entrega conveniente, sino la exactitud literal a los datos.
- 28 oct 2026Gemma 26B afinada en un MacBook de 24 GB: el asistente sin conexión acierta 703 de 766
- 28 oct 202612 herramientas de pentesting contra Juice Shop: el mejor agente de IA encontró 5 fallos de 116
- 28 oct 2026OpenAI lanza GPT-6.1 Terra: la mitad de precio y casi al nivel de los modelos superiores
- 28 oct 2026OpenAI lanza GPT-6.1 Terra: token a $1 y el triple de rápido que Astra
Preguntas frecuentes sobre la noticia
¿Qué se sabe sobre Qué Probó WIRED?
El nuevo enfoque de OpenAI en un escenario de compras por IA fue el motivador. La empresa promete que ChatGPT ayudará a los usuarios a elegir productos más rápidamente y los liberará de comparaciones infinitas de pestañas y listas de "lo mejor de". WIRED decidió probar no la calidad abstracta de los consejos, sino un caso más específico y medible: ¿puede el bot recuitar con precisión qué dispositivos la redacción ha realmente probado y recomienda ahora? Para tal prueba, este es un objetivo conveniente porque la publicación tiene guías regularmente actualizadas, construidas
Dónde Fallaron las Respuestas?
El fallo más revelador ocurrió en la categoría de televisores. ChatGPT abrió la guía WIRED correcta, pero nombró el LG QNED Evo Mini-LED como la mejor opción para la mayoría de las personas — un modelo que no estaba en la lista editorial. La elección real de WIRED era el TCL QM6K. El error parecía particularmente desagradable porque un lector podría fácilmente no notar la sustitución: el enlace va donde debería, las fotos de productos están cerca, el tono de la respuesta es confiado, y parece solo un breve resumen del artículo. Pero de hecho, el bot ya había mezclado su pro
¿Qué se sabe sobre Por Qué Importa Esto?
El problema aquí no es solo el error factual en sí. Cuando alguien viene con la solicitud "¿qué recomienda WIRED?", quiere no una respuesta promediada del modelo, sino el resultado de un proceso editorial específico: pruebas, comparaciones, actualizaciones y la elección final del autor. Cuando ChatGPT sustituye un producto por otro, el usuario puede interpretar esto como posición de la publicación y gastar dinero confiando en una autoridad que no existe realmente en esta recomendación específica. Para medios, ya es una cuestión no de conveniencia de interfaz, sino de precis
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.