Un stack open source de 6 modelos y 9 agentes muestra cómo montar un equipo de IA en un solo servidor
Un servidor con GPU, seis modelos open source y nueve agentes: así es un equipo de IA autónomo que diseña, escribe, prueba y despliega nuevos agentes por su cuenta. En lugar de un modelo universal, los roles se reparten según las fortalezas: razonamiento para el orquestador, generación de código para el constructor, uso de herramientas para el crítico. El ahorro clave es compartir instancias: 9 agentes funcionan con solo 3–4 modelos. El autor describe además tres opciones de despliegue, desde una RTX 4090 hasta un clúster de A100.
Procesado por IA desde Habr AI; editado por Hamidun News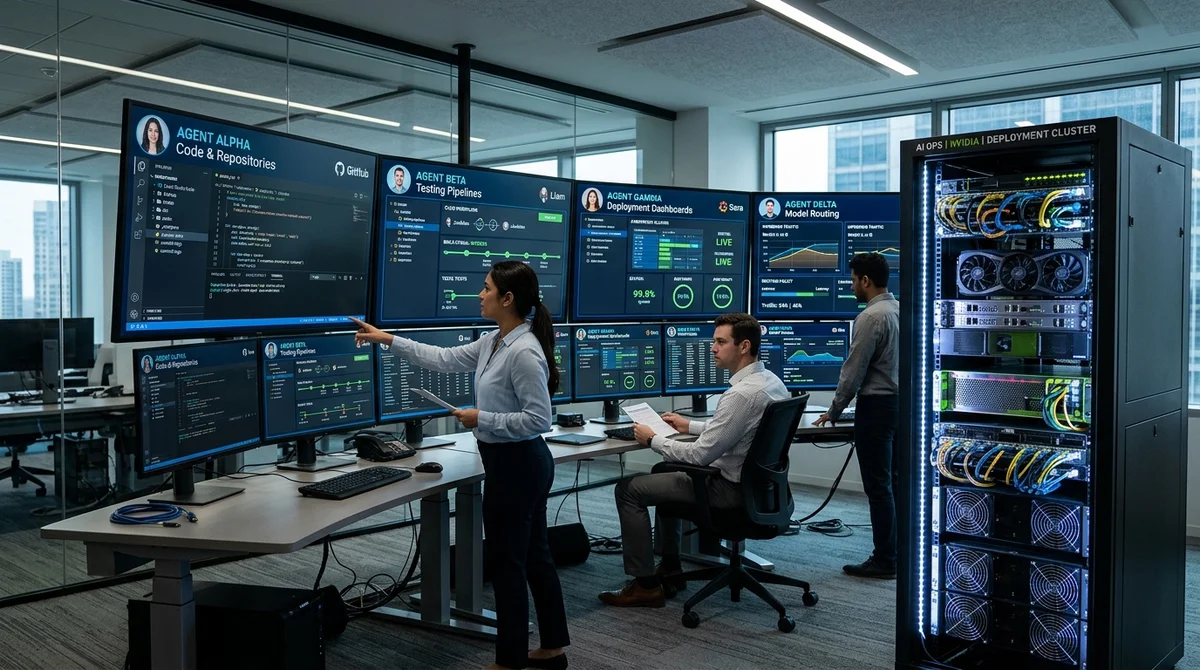
Un equipo autónomo de nueve agentes de IA puede diseñar, escribir, probar y desplegar nuevos agentes sin intervención humana. No hace falta un conjunto de API cerradas: el esquema se basa en seis modelos open source y, en su versión básica, cabe en un solo servidor con GPU.
Cómo está organizado el equipo
En lugar de un único modelo «universal», el autor montó un flujo de trabajo con nueve roles. Unos agentes se encargan de definir la tarea y la arquitectura; otros, de escribir código, controlar la calidad, probar y publicar. El resultado no es un gran asistente, sino una pequeña organización de ingeniería en la que cada miembro hace una parte acotada del trabajo.
Este enfoque reduce el caos: el agente no tiene que planificar el sistema, escribir módulos, ejecutar pruebas y evaluar sus propios errores a la vez. La idea clave es que la autonomía no se logra con magia, sino dividiendo el proceso en etapas. Si el agente solo entiende su tramo y recibe como entrada una tarea ya estructurada, los requisitos para el modelo son más claros.
El orquestador debe saber razonar y mantener el contexto, el constructor debe generar código de forma estable y el crítico debe detectar problemas en el uso de herramientas y en los escenarios de ejecución. Por eso la ventaja no viene de un supermodelo, sino de ensamblar con precisión los roles en un pipeline operativo.
Roles y benchmarks
El autor rechaza de forma explícita la idea del «mejor modelo en general». En su lugar, los roles se eligen según lo que respaldan los benchmarks. Para el orquestador importa el razonamiento, así que la referencia es un resultado de GPQA del 88,4 %. Para el constructor es crítica la generación de código, y aquí se mira HumanEval con un 92,7 %. Para el crítico pesa más entender el uso de herramientas y el comportamiento de los agentes en las tareas, por lo que se toma tau-bench, con un resultado del 87,4 %. Esa especialización explica que se usen seis modelos open source distintos en vez de uno de clase GPT para todos los casos.
- Orquestador: razonamiento sólido, priorización y descomposición de tareas
- Constructor: generación de código y revisión rápida de cambios de ingeniería
- Crítico: verificación del uso de herramientas, de la calidad de las soluciones y de los puntos débiles del pipeline
- Otros roles: pruebas, despliegue y etapas de servicio, donde se pueden reutilizar instancias compartidas
Nueve agentes no significan nueve modelos completos en memoria al mismo tiempo. Un truco práctico es compartir instancias: varios roles usan el mismo modelo si sus cargas y perfiles de tarea son parecidos. Así, un sistema de nueve agentes puede funcionar con solo tres o cuatro instancias de modelo. Esto reduce de forma drástica el consumo de VRAM, simplifica el mantenimiento y acerca la arquitectura a la producción real, en lugar de a una demostración con presupuesto ilimitado.
Hardware y puesta en marcha
La parte de infraestructura merece atención aparte. El autor describe tres configuraciones de despliegue: desde una sola RTX 4090 con 24 GB de memoria hasta un clúster de A100 con 211 GB en total. Entre esos extremos se puede elegir el equilibrio entre velocidad, calidad y paralelismo. Para abaratar costes se emplean cuantización, una infraestructura de inferencia bien pensada y un panel interactivo que ayuda a seguir los roles, la carga y el avance de las tareas. Es decir, no se trata solo de elegir modelos, sino también de un entorno operativo adecuado para ellos.
La conclusión práctica es sencilla: la IA agéntica open source deja de ser un juguete de laboratorio. Si antes este tipo de esquemas se asociaban con API caras o con clústeres pesados, aquí se muestra un camino de inicio más realista. Un equipo pequeño puede empezar con un servidor, comprobar la viabilidad del pipeline y escalarlo a medida que crezcan las tareas. El coste ya parece una decisión de ingeniería, y no una barrera que descarta de inmediato a la mayoría de los equipos.
Qué significa
El mercado se aleja de la idea de un modelo «mágico» y avanza hacia sistemas orientados a roles, donde importa más la composición correcta que un nombre sonoro en una API. Para las empresas es una señal: los equipos de IA autónomos pueden montarse ya con componentes open source, siempre que se traten como infraestructura y proceso, y no como una simple ventana de chat.
- 2 nov 2026DeepSeek abre el código del prototipo Super-agent: p95 de ejecución de 15,7 min frente a 29,5
- 2 nov 2026TensorFold 1.2.0 aumenta un 44,2% el rendimiento de Qwen3.8-27B en el M3 Ultra con 16 flujos
- 1 nov 2026El juez de EditAgent, de Adobe, elige una edición válida en el 81,3% de los casos frente al 74,8% de EditScore
- 1 nov 2026Prueba de 16 modelos en 7 buscadores: Exa obtuvo una media de 10,5 puntos de 14; SearXNG, en torno a 3
Preguntas frecuentes sobre la noticia
Cómo está organizado el equipo?
En lugar de un único modelo «universal», el autor montó un flujo de trabajo con nueve roles. Unos agentes se encargan de definir la tarea y la arquitectura; otros, de escribir código, controlar la calidad, probar y publicar. El resultado no es un gran asistente, sino una pequeña organización de ingeniería en la que cada miembro hace una parte acotada del trabajo. Este enfoque reduce el caos: el agente no tiene que planificar el sistema, escribir módulos, ejecutar pruebas y evaluar sus propios errores a la vez. La idea clave es que la autonomía no se logra con magia, sino di
¿Qué se sabe sobre Roles y benchmarks?
El autor rechaza de forma explícita la idea del «mejor modelo en general». En su lugar, los roles se eligen según lo que respaldan los benchmarks. Para el orquestador importa el razonamiento, así que la referencia es un resultado de GPQA del 88,4 %. Para el constructor es crítica la generación de código, y aquí se mira HumanEval con un 92,7 %. Para el crítico pesa más entender el uso de herramientas y el comportamiento de los agentes en las tareas, por lo que se toma tau-bench, con un resultado del 87,4 %. Esa especialización explica que se usen seis modelos open source dis
¿Qué se sabe sobre Hardware y puesta en marcha?
La parte de infraestructura merece atención aparte. El autor describe tres configuraciones de despliegue: desde una sola RTX 4090 con 24 GB de memoria hasta un clúster de A100 con 211 GB en total. Entre esos extremos se puede elegir el equilibrio entre velocidad, calidad y paralelismo. Para abaratar costes se emplean cuantización, una infraestructura de inferencia bien pensada y un panel interactivo que ayuda a seguir los roles, la carga y el avance de las tareas. Es decir, no se trata solo de elegir modelos, sino también de un entorno operativo adecuado para ellos. La conc
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.