Machine Learning Mastery señala cinco grandes barreras para escalar la IA agéntica en 2026
Machine Learning Mastery ha publicado un análisis sobre por qué la IA agéntica sigue siendo difícil de escalar en producción en 2026. Los principales cuellos de botella son la complejidad explosiva de la orquestación, la observabilidad débil, los costes impredecibles, los métodos de prueba inmaduros y las salvaguardas rezagadas. Sin estas capas, la autonomía se convierte rápidamente en fuente de fallos, riesgos y sobrecostes, sobre todo para empresas con usuarios reales y SLA.
Procesado por IA desde Machine Learning Mastery; editado por Hamidun News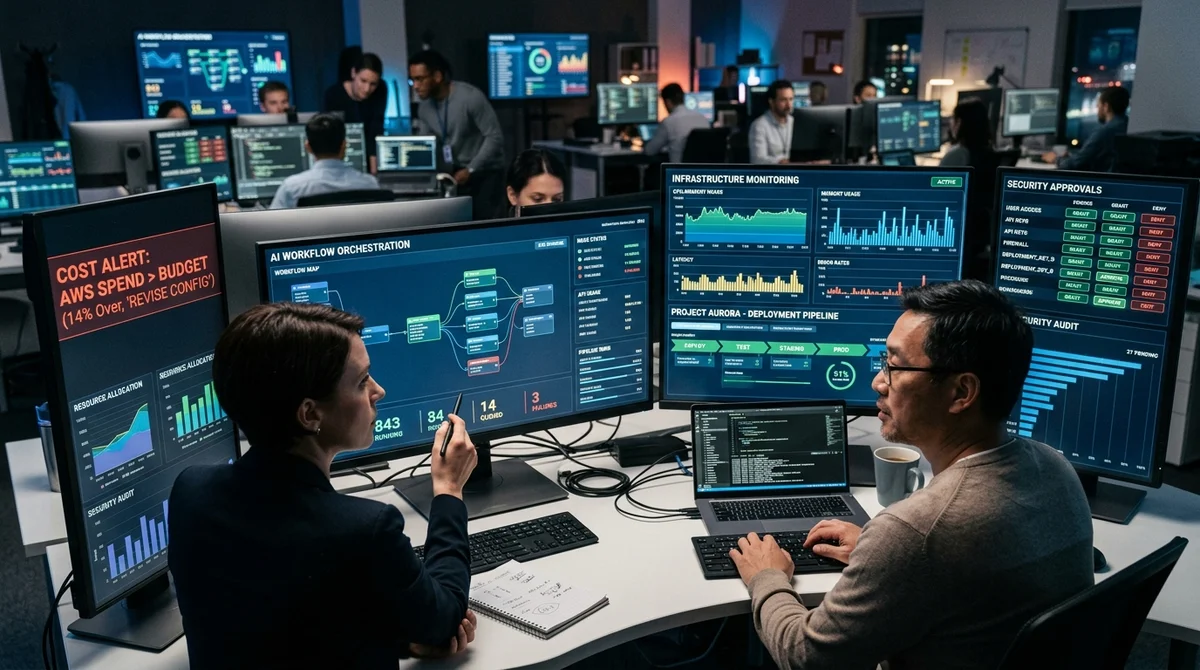
Machine Learning Mastery ha publicado un artículo sobre cinco problemas que frenan la adopción masiva de la IA agéntica en producción. La idea central es sencilla: entre una demo impresionante y un sistema que funciona de forma estable bajo carga hay una capa de ingeniería aparte, y es la que más falla ahora mismo.
Dónde se rompe la orquestación
Mientras hay un solo agente con una tarea acotada, el pipeline parece controlable. Pero en cuanto el sistema empieza a pasar tareas a otros agentes, elegir herramientas sobre la marcha y repetir pasos fallidos, la complejidad crece no de forma lineal, sino casi explosiva. Los equipos se topan menos con los límites de los modelos que con la coordinación: los agentes se esperan unos a otros, los escenarios asíncronos sufren condiciones de carrera y un error en un paso desencadena un fallo en cascada en otro.
«Las demos parecen impresionantes y los prototipos parecen magia».
Por eso un esquema que aguanta con calma cien solicitudes por minuto puede venirse abajo con decenas de miles. El resultado: las empresas construyen sus propios orquestadores y luego descubren que esa capa es la más cara y frágil de toda la pila. Para los equipos de ML supone un cambio de mentalidad: ya no basta con elegir un buen modelo, hay que saber diseñar un sistema distribuido con comportamiento predecible bajo carga.
Observabilidad y dinero
El segundo problema es la observabilidad débil. Las métricas habituales, como latencia y throughput, ya no bastan: en la IA agéntica hay que ver toda la ruta de ejecución. ¿Por qué el agente eligió una herramienta en lugar de otra? ¿Por qué repitió un paso tres veces? ¿Por qué falló el resultado final si cada etapa intermedia parecía normal?
La infraestructura de trazado profundo para estos casos aún es inmadura, y el comportamiento de los propios sistemas es no determinista. Una misma solicitud puede tomar ramas distintas, así que reproducir y corregir incidentes resulta bastante más difícil.
En este contexto aflora enseguida un tercer tema: el coste. Una sola solicitud agéntica suele componerse de decenas de llamadas a LLM, y en producción eso se convierte al instante en una factura grande. Incluso un precio de unos 15 centavos por escenario parece asumible solo hasta que el volumen llega a cientos de miles de ejecuciones al día.
Por eso los equipos de ingeniería ya apuestan por unas cuantas técnicas básicas:
- enrutar subtareas simples a modelos más baratos
- almacenar en caché de forma agresiva los resultados intermedios
- un kill switch para bucles descontrolados y reintentos infinitos
- límites estrictos al número de pasos, llamadas e intentos
El problema es que el ahorro casi siempre choca con la calidad. Si reduces los pasos, aumenta el riesgo de error. Si pasas parte de las tareas a un modelo más barato, el resultado es menos estable. Y, sobre todo, los presupuestos son difíciles de prever: un caso atípico puede lanzar una larga cadena de reintentos y encarecer una única solicitud decenas de veces respecto a la habitual.
Pruebas y control
La cuarta barrera es la falta de un enfoque maduro de pruebas. El software clásico se apoya en un comportamiento determinista, y el ML clásico, en un vínculo fijo entre entrada y salida. La IA agéntica rompe ambos modelos a la vez. Hoy los equipos validan estos sistemas con LLM-as-a-judge, conjuntos de pruebas por escenarios y simulaciones en entornos sintéticos, pero aún no existe un estándar común. Los benchmarks están fragmentados, las herramientas dispersas y la revisión humana sigue siendo el principal cortafuegos, aunque escala mal.
El quinto problema es la gobernanza y la seguridad. Un agente ya no se limita a escribir texto: envía correos, modifica datos, accede a servicios externos y potencialmente lanza transacciones. Hacen falta, por tanto, permisos de acceso, confirmación de acciones, límites de alcance y una auditoría detallada. Pero cuanto más estrictas son las salvaguardas, menor es la sensación de autonomía y más débil el efecto «guau» del producto.
También presiona el factor regulatorio: en cuanto estos sistemas afectan directamente a los clientes, las cuestiones de responsabilidad, cumplimiento normativo y verificabilidad de las decisiones dejan de ser teoría.
Qué significa
El mercado de la IA agéntica ha chocado no con la calidad de las demos, sino con la infraestructura que las rodea. Ganarán no quienes ensamblen antes el siguiente agente, sino quienes antes que nadie pongan a punto la orquestación, el trazado, las pruebas, los presupuestos y los mecanismos de protección.
Preguntas frecuentes sobre la noticia
Dónde se rompe la orquestación?
Mientras hay un solo agente con una tarea acotada, el pipeline parece controlable. Pero en cuanto el sistema empieza a pasar tareas a otros agentes, elegir herramientas sobre la marcha y repetir pasos fallidos, la complejidad crece no de forma lineal, sino casi explosiva. Los equipos se topan menos con los límites de los modelos que con la coordinación: los agentes se esperan unos a otros, los escenarios asíncronos sufren condiciones de carrera y un error en un paso desencadena un fallo en cascada en otro. «Las demos parecen impresionantes y los prototipos parecen magia». P
¿Qué se sabe sobre Observabilidad y dinero?
El segundo problema es la observabilidad débil. Las métricas habituales, como latencia y throughput, ya no bastan: en la IA agéntica hay que ver toda la ruta de ejecución. ¿Por qué el agente eligió una herramienta en lugar de otra? ¿Por qué repitió un paso tres veces? ¿Por qué falló el resultado final si cada etapa intermedia parecía normal? La infraestructura de trazado profundo para estos casos aún es inmadura, y el comportamiento de los propios sistemas es no determinista. Una misma solicitud puede tomar ramas distintas, así que reproducir y corregir incidentes resulta b
¿Qué se sabe sobre Pruebas y control?
La cuarta barrera es la falta de un enfoque maduro de pruebas. El software clásico se apoya en un comportamiento determinista, y el ML clásico, en un vínculo fijo entre entrada y salida. La IA agéntica rompe ambos modelos a la vez. Hoy los equipos validan estos sistemas con LLM-as-a-judge, conjuntos de pruebas por escenarios y simulaciones en entornos sintéticos, pero aún no existe un estándar común. Los benchmarks están fragmentados, las herramientas dispersas y la revisión humana sigue siendo el principal cortafuegos, aunque escala mal. El quinto problema es la gobernanza
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.