AtScale: los agentes de IA corporativos para analítica necesitan guardrails, no modelos más grandes
AtScale advierte que, en la analítica corporativa, aumentar el tamaño del modelo no resuelve el problema principal: el caos en los datos y en las definiciones de negocio. Si los agentes de IA trabajan con interpretaciones distintas de revenue, margin y churn, sin lineage ni source of record, solo consiguen dar más rápido respuestas seguras, pero incorrectas. La salida pasa por una capa semántica, reglas de cálculo comunes, control de acceso y guardrails estrictos.
Procesado por IA desde TNW; editado por Hamidun News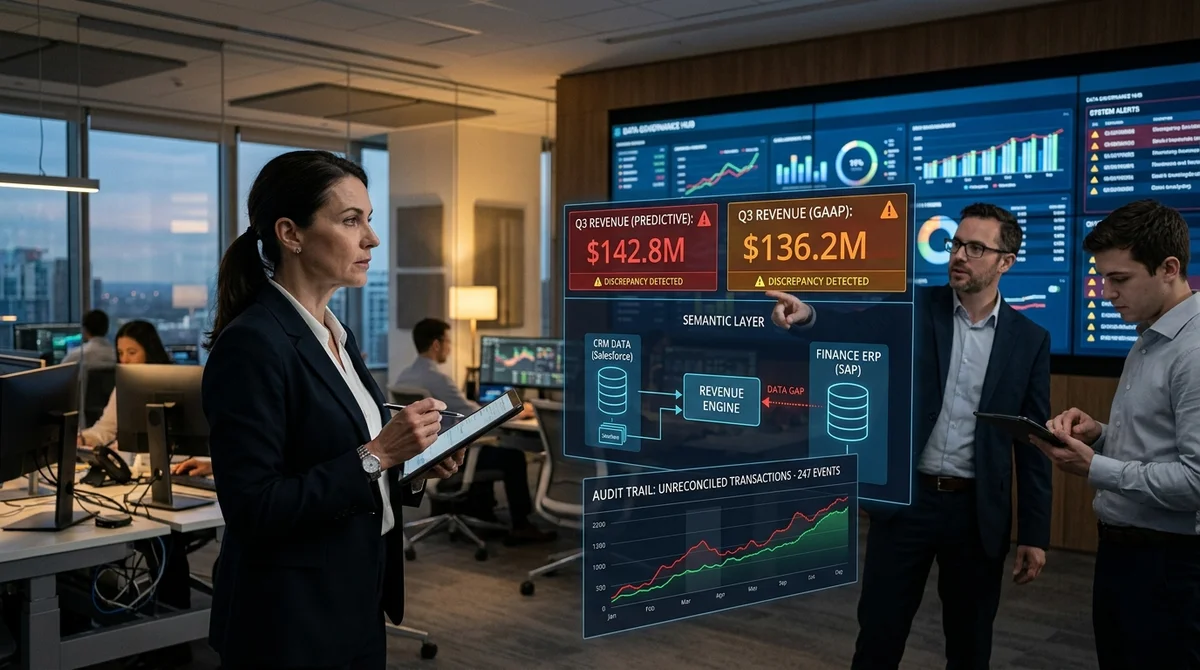
AtScale afirma que el principal riesgo de los agentes de IA corporativos en analítica no depende del tamaño del modelo, sino de la calidad del contexto en el que trabaja. Si un agente consulta datos dispersos sin reglas de negocio comunes, puede devolver rápidamente una respuesta verosímil, pero equivocada.
Por qué el tamaño no basta
En las grandes empresas es habitual confiar en que el próximo modelo, más grande, corregirá por sí solo los errores del anterior: razonará mejor, interpretará la consulta con más precisión y cuadrará las cifras con más cuidado. Pero el modelo no tiene ninguna forma mágica de saber qué definición de gross margin o de revenue se usa dentro de una empresa concreta. No elimina las viejas contradicciones entre dashboards, no reconstruye el origen de las métricas ni crea un audit trail solo porque tenga más parámetros.
AtScale cita además un estudio de TDWI en el que casi la mitad de los encuestados calificó sus iniciativas de AI governance como inmaduras o muy inmaduras. La lógica es sencilla: si los datos de origen y las definiciones son caóticos, más potencia de cálculo no reduce el error, sino que lo vuelve escalable. El agente responde más rápido, con más seguridad y en más tareas, pero los problemas estructurales siguen siendo los mismos. Al final, la empresa no obtiene una analítica fiable, sino una versión más convincente del mismo desorden de siempre.
Dónde se rompe la analítica
El mayor riesgo aparece cuando varios sistemas y equipos trabajan con los mismos indicadores, pero los entienden de forma distinta. Un agente toma los datos del almacén financiero; otro, del CRM o de una herramienta de BI, y en principio ambos responden a la misma pregunta. Si no comparten contexto, la discrepancia deja de ser un error puntual y se convierte en el modo normal de funcionamiento. Por eso el artículo recoge una fórmula breve que describe bien el problema:
«Con seguridad. Limpio. Incorrecto.»
Según AtScale, los fallos típicos son bastante previsibles. El agente puede apoyarse en una fuente donde un mismo indicador se interpreta de forma distinta que en el equipo de al lado. Puede entregar un resultado sin explicar con claridad cómo llegó a él. Puede basar su conclusión en datos a los que ni siquiera debería haber accedido. Y cuando la respuesta no puede vincularse a un source of record controlado, la empresa pierde la capacidad de verificar rápidamente el error, asignar responsabilidades y revertir una decisión equivocada sin conciliación manual.
Qué guardrails hacen falta
AtScale propone ver los guardrails no como un freno para la IA, sino como la infraestructura que hace posible la autonomía. En analítica, según la compañía, el modelo no debe trabajar directamente con tablas «en bruto» ni con las distintas reglas locales de cada equipo, sino a través de una capa semántica común. Esa capa no copia los datos ni los modifica físicamente, pero fija un significado único para los términos de negocio, las reglas de cálculo y los límites de acceso para todas las aplicaciones y agentes.
- Definiciones únicas de revenue, churn, margin y otras métricas clave
- Restricciones sobre la lógica de negocio de los cálculos, con independencia de la herramienta
- Visibilidad del lineage: de dónde sale la respuesta y qué datos intervinieron en ella
- Control de acceso: qué conjuntos de datos puede consultar el agente
- Estandarización de métricas entre departamentos y plataformas
La idea de este enfoque es que el rendimiento del modelo y la responsabilidad del sistema son problemas distintos. El modelo se encarga del razonamiento, mientras que la capa de governance define sobre qué razona exactamente y cómo puede verificarse el resultado. Si esa capa está bien construida, varios agentes en sistemas diferentes empiezan a hablar el mismo lenguaje de negocio. Si no, cada nueva integración, cada proceso y cada herramienta de IA adicional solo encarecen los errores, las revisiones manuales y la repetición de análisis.
Qué significa esto
La IA corporativa depende cada vez menos de la carrera de parámetros y cada vez más de la arquitectura de datos. Para las empresas es una mala noticia si contaban con «comprar un modelo más listo» y dar el problema por resuelto, y una buena si están dispuestas a invertir en una capa semántica, en governance y en trazabilidad. Son estos elementos, y no el tamaño del modelo por sí solo, los que determinarán si se puede confiar en la analítica con IA en procesos de negocio reales.
- 31 oct 2026Un autor sometió su guion a un jurado de IA: el veredicto costó 850.000 tokens
- 31 oct 2026SciGame puso a prueba a cinco agentes LLM: las fórmulas conocidas les impiden encontrar leyes modificadas
- 30 oct 2026El tráfico de agentes en Zocdoc se multiplica por 30 desde julio y ChatGPT suma dos demandas por consejos de salud
- 29 oct 2026OvisOCR3: un modelo de 0,8 mil millones de parámetros que lee documentos mejor que los sistemas especializados
Preguntas frecuentes sobre la noticia
¿Qué se sabe sobre Por qué el tamaño no basta?
En las grandes empresas es habitual confiar en que el próximo modelo, más grande, corregirá por sí solo los errores del anterior: razonará mejor, interpretará la consulta con más precisión y cuadrará las cifras con más cuidado. Pero el modelo no tiene ninguna forma mágica de saber qué definición de gross margin o de revenue se usa dentro de una empresa concreta. No elimina las viejas contradicciones entre dashboards, no reconstruye el origen de las métricas ni crea un audit trail solo porque tenga más parámetros. AtScale cita además un estudio de TDWI en el que casi la mita
Dónde se rompe la analítica?
El mayor riesgo aparece cuando varios sistemas y equipos trabajan con los mismos indicadores, pero los entienden de forma distinta. Un agente toma los datos del almacén financiero; otro, del CRM o de una herramienta de BI, y en principio ambos responden a la misma pregunta. Si no comparten contexto, la discrepancia deja de ser un error puntual y se convierte en el modo normal de funcionamiento. Por eso el artículo recoge una fórmula breve que describe bien el problema: «Con seguridad. Limpio. Incorrecto.» Según AtScale, los fallos típicos son bastante previsibles. El agente
¿Qué se sabe sobre Qué guardrails hacen falta?
AtScale propone ver los guardrails no como un freno para la IA, sino como la infraestructura que hace posible la autonomía. En analítica, según la compañía, el modelo no debe trabajar directamente con tablas «en bruto» ni con las distintas reglas locales de cada equipo, sino a través de una capa semántica común. Esa capa no copia los datos ni los modifica físicamente, pero fija un significado único para los términos de negocio, las reglas de cálculo y los límites de acceso para todas las aplicaciones y agentes. Definiciones únicas de revenue, churn, margin y otras métricas
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.