Cómo Sun Finance y AWS aceleraron la verificación de documentos y redujeron el riesgo de fraude
Sun Finance automatizó la verificación de documentos con Amazon Bedrock, Textract y Rekognition. La compañía elevó la precisión de extracción de datos del 79,7 % al 90,8 %, redujo el tiempo de procesamiento de 20 horas a menos de 5 segundos y recortó el coste por documento un 91 %. La clave fue combinar un OCR especializado, un LLM para estructurar los datos y un sistema antifraude sin servidor basado en similitud vectorial.
Procesado por IA desde AWS Machine Learning Blog; editado por Hamidun News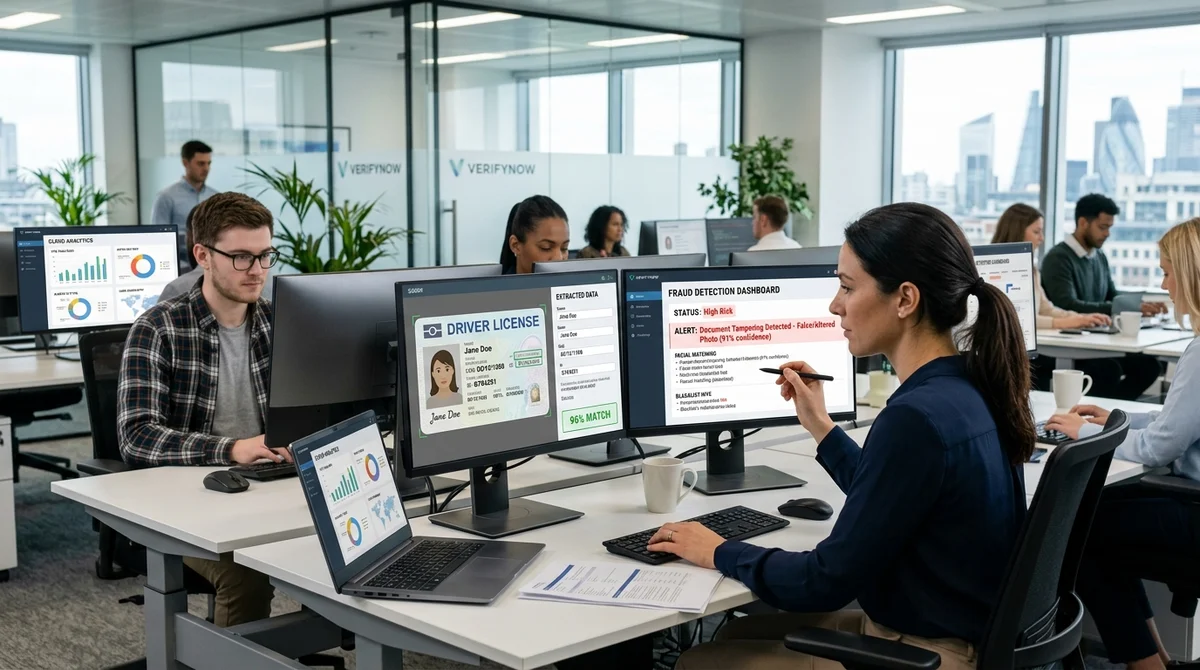
Sun Finance ha pasado la verificación de identidad a modo automático con servicios de AWS e IA generativa. La compañía montó un flujo que extrae datos de los documentos con más rapidez, procesa las solicitudes a menor coste y ayuda a detectar coincidencias sospechosas casi en tiempo real.
Cómo funciona el pipeline
La solución reparte el trabajo entre varias herramientas. Amazon Textract se encarga del OCR y extrae el texto de los documentos de identidad, Amazon Bedrock da al resultado la estructura necesaria y normaliza los campos, y Amazon Rekognition ayuda con la verificación visual y los escenarios antifraude. Este enfoque resultó más práctico que intentar resolverlo todo con un solo modelo: un servicio especializado hace la extracción, mientras que el LLM se ocupa de la interpretación, la corrección de formato y el ensamblado de la estructura final para los sistemas internos.
La velocidad de la arquitectura importa por separado. Sun Finance construyó un flujo IDV sin servidor, donde el procesamiento se lanza por eventos y no requiere una infraestructura permanente dimensionada para los picos de carga. Esto resulta especialmente útil en procesos de crédito y fintech, donde el flujo de documentos es irregular: de noche puede ser mínimo y dispararse en las horas de concesión. Con este esquema es más fácil controlar el coste, y el tiempo de respuesta ya no depende de una cola manual de operadores, que antes podían retrasar la verificación muchas horas.
- El OCR extrae el texto en bruto y los campos del documento
- El LLM unifica la estructura de los datos y elimina el ruido
- Rekognition añade señales visuales para verificar la identidad
- La búsqueda vectorial ayuda a encontrar solicitudes sospechosamente parecidas
Para el antifraude en este esquema importa no solo leer el documento, sino también poder compararlo con casos ya procesados. La búsqueda vectorial permite almacenar representaciones de las solicitudes y encontrar rápidamente coincidencias cercanas por imagen, texto o conjunto de rasgos. Si el sistema detecta documentos demasiado parecidos, patrones repetidos o una cercanía atípica entre solicitudes distintas, puede enviarlos a una revisión adicional. Esto ofrece una capa de protección más flexible que las reglas rígidas simples.
Por qué funcionó
La principal conclusión del caso es que combinar OCR y LLM da mejores resultados que usar cada componente por separado. Según Sun Finance, la precisión de extracción subió del 79,7 % al 90,8 %. En estos escenarios no es una mejora cosmética: cada pocos puntos de precisión influyen directamente en el volumen de correcciones manuales, el número de errores en el formulario y la rapidez de la decisión sobre la solicitud. El LLM no sustituye al reconocimiento especializado, sino que lo complementa: entiende el contexto de los campos, homogeneiza los nombres, elimina artefactos típicos del OCR y prepara los datos para seguir automatizando.
El efecto económico es igual de notable. Según la descripción de AWS, el coste de procesar un documento bajó un 91 % y el tiempo de procesamiento pasó de un máximo de 20 horas a menos de 5 segundos. Para una fintech esto significa varias cosas a la vez: menos gastos operativos, menos abandonos por esperas largas y más posibilidades de verificar al cliente antes de que abandone la solicitud. En paralelo, el sistema antifraude basado en similitud vectorial permite buscar solicitudes repetidas o demasiado parecidas sin una pesada infraestructura de servidores. Así la verificación no solo es más rápida, sino también más resistente a los intentos de saltarse las reglas básicas.
Qué significa
El caso de Sun Finance muestra que la IA generativa en la gestión documental funciona mejor no como sustituto universal de todo el stack, sino como una capa sobre servicios especializados que ya son sólidos. Para bancos, entidades de microcréditos y otras empresas con procesos KYC, la señal es clara: si se reparten bien el OCR, la estructuración y el antifraude entre distintos componentes, se puede subir la precisión, reducir el tiempo de respuesta a segundos y bajar notablemente el coste de la verificación a la vez.
- 19 nov 2026Amazon y Google tendrán el 28,4% de Anthropic tras la IPO, pero sin derecho a voto
- 19 nov 2026Social Department sustituye una semana de visionado de una serie por cuatro consultas de QuickSearch en AWS
- 19 nov 2026AgentCore de AWS incorpora hooks con Lambda y gasta un 34% menos de tokens que sus alternativas
- 19 nov 2026Skyflow en AgentCore Gateway oculta los datos personales a las herramientas de los agentes de IA
Preguntas frecuentes sobre la noticia
Cómo funciona el pipeline?
La solución reparte el trabajo entre varias herramientas. Amazon Textract se encarga del OCR y extrae el texto de los documentos de identidad, Amazon Bedrock da al resultado la estructura necesaria y normaliza los campos, y Amazon Rekognition ayuda con la verificación visual y los escenarios antifraude.
¿Qué se sabe sobre Por qué funcionó?
La principal conclusión del caso es que combinar OCR y LLM da mejores resultados que usar cada componente por separado. Según Sun Finance, la precisión de extracción subió del 79,7 % al 90,8 %. En estos escenarios no es una mejora cosmética: cada pocos puntos de precisión influyen directamente en el volumen de correcciones manuales, el número de errores en el formulario y la rapidez de la decisión sobre la solicitud.
¿Qué se sabe sobre Qué significa?
El caso de Sun Finance muestra que la IA generativa en la gestión documental funciona mejor no como sustituto universal de todo el stack, sino como una capa sobre servicios especializados que ya son sólidos. Para bancos, entidades de microcréditos y otras empresas con procesos KYC, la señal es clara: si se reparten bien el OCR, la estructuración y el antifraude entre distintos componentes, se puede subir la precisión, reducir el tiempo de respuesta a segundos y bajar notablemente el coste de la…
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.