NVIDIA y PNY promocionan la RTX PRO 6000 Blackwell para analítica de datos y desarrollo de IA
PNY promociona estaciones de trabajo con la NVIDIA RTX PRO 6000 Blackwell como sustituto de los sistemas basados en CPU para data science. Sus argumentos principales: hasta 50 veces más velocidad en pandas mediante cuDF sin reescribir código, menor tiempo de entrenamiento de XGBoost y la posibilidad de montar hasta cuatro GPU en una sola máquina. La apuesta se centra en el procesamiento local de los datos, una menor dependencia de la nube y el control del gasto.
Procesado por IA desde IEEE Spectrum AI; editado por Hamidun News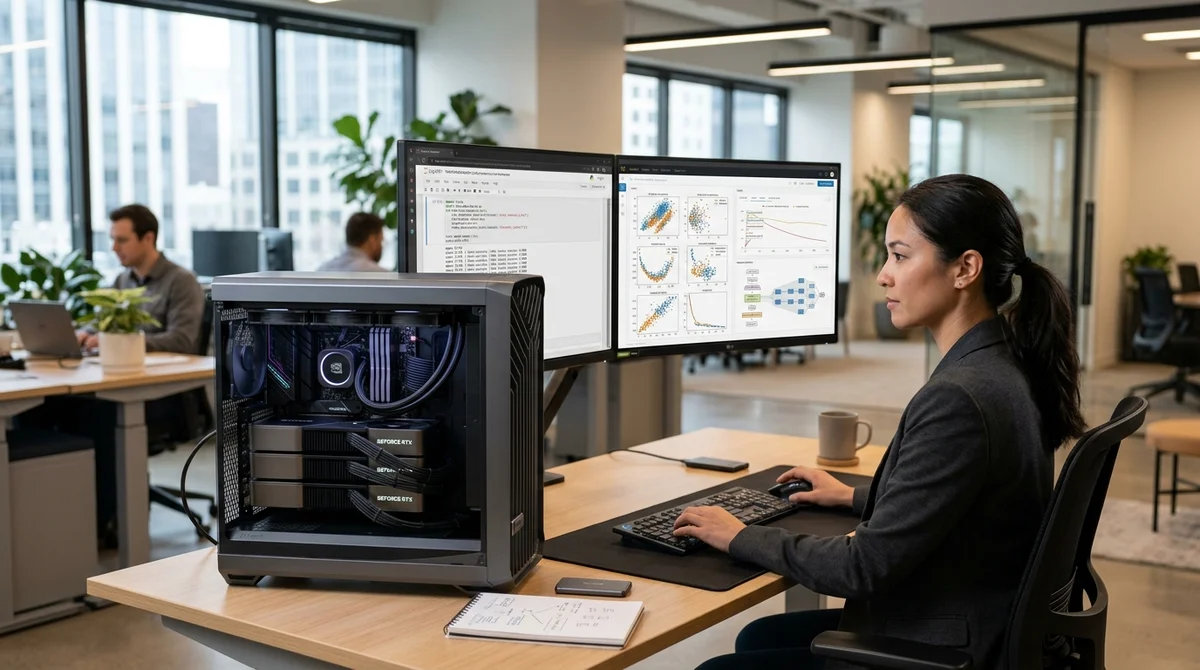

En un contenido patrocinado para IEEE Spectrum, PNY promociona la NVIDIA RTX PRO 6000 Blackwell Workstation Edition como alternativa local a la nube y a los centros de datos para tareas de data science. La tesis central: parte de los pipelines pesados de IA y analítica puede acelerarse decenas de veces directamente en el puesto de trabajo.
Por qué la CPU se queda corta
El planteamiento gira en torno a tres cuellos de botella que conocen la mayoría de los equipos de data science. El primero es la preparación de datos: limpiar, unir tablas, rellenar huecos y crear variables suele consumir la mayor parte del tiempo antes de entrenar el modelo. El segundo es la escala: los volúmenes crecen más rápido de lo que los sistemas de sobremesa con CPU pueden procesar, por lo que los equipos a veces recortan las muestras y pierden calidad en los resultados. El tercero es el hardware: el acceso a aceleradores en la nube y en centros de datos es caro y, en ocasiones, limitado.
En ese contexto, NVIDIA y PNY proponen devolver parte de la carga a estaciones de trabajo locales. La idea es sencilla: si un analista o ingeniero de ML tiene bajo la mesa una máquina con varias GPU, depende menos de las colas de la infraestructura compartida, comprueba hipótesis más rápido y no saca datos sensibles al exterior. Para los equipos corporativos se presenta como un compromiso entre velocidad, privacidad y control de costes.
Qué promete Blackwell
El énfasis está en acelerar todo el flujo, desde las operaciones de pandas hasta el entrenamiento de modelos. Según NVIDIA, la biblioteca cuDF de la pila CUDA-X puede acelerar pipelines de Python sin reescribir código, y su combinación con PyData y XGBoost debería reducir de forma notable el tiempo de análisis exploratorio y de entrenamiento. La plataforma también está pensada para escenarios multiusuario, visualización avanzada y trabajo colaborativo mediante NVIDIA AI Workbench, de modo que un mismo proyecto pueda llevarse en una máquina local, en la nube y en un centro de datos.
- hasta cuatro GPU RTX PRO 6000 Blackwell Max-Q en una sola estación de trabajo
- aceleración de pandas con cuDF sin cambiar el código, hasta 50 veces según la compañía
- operación join: casi 5 minutos en CPU frente a 14 segundos en GPU
- group by: casi 4 minutos en CPU frente a 4 segundos en GPU
- entrenamiento de XGBoost que antes tardaba semanas, que la compañía promete reducir a minutos
«la GPU de escritorio más potente jamás creada»
El tono de marketing de la publicación es directo: así describe PNY la RTX PRO 6000 Blackwell en el vídeo que la acompaña. Es una afirmación contundente, pero el propio material no incluye pruebas independientes ni comparaciones con alternativas en una configuración equivalente. Por eso conviene tomar las cifras como una referencia del fabricante: muestran el tipo de tareas en las que una GPU sí aporta una ventaja, pero no sustituyen un benchmark completo con tu propio stack y tus datos.
Apuesta por lo local
Otro argumento es la economía y la seguridad. Cuando parte del pipeline pasa de la nube a la estación de trabajo, la empresa paga menos por el alquiler de cómputo y el almacenamiento, y los datasets sensibles permanecen dentro del perímetro. Para los sectores con requisitos de procesamiento on-premise, esto pesa más que el rendimiento puro. Además, una máquina local reduce la dependencia de la escasez de GPU en los centros de datos: hay que esperar menos por un hueco de entrenamiento o negociar un presupuesto aparte.
PNY también subraya el componente corporativo: integración con la infraestructura de TI existente, soluciones de red NVIDIA ConnectX, herramientas de despliegue y alta disponibilidad. El mensaje es claro: la RTX PRO 6000 Blackwell no se vende como una «tarjeta para entusiastas», sino como un ladrillo para el desarrollo corporativo de IA. Sobre todo para equipos que necesitan iterar rápido con grandes datasets, pero que no están dispuestos a mudarse por completo a la nube ni a competir constantemente por los recursos de un clúster compartido.
Qué significa
El mercado de hardware de IA se desplaza cada vez más de las promesas universales hacia un escenario concreto: ofrecer a un equipo de data science rendimiento de nivel centro de datos en su propio puesto. Si las aceleraciones anunciadas se confirman con cargas reales, estas estaciones podrían convertirse en una capa intermedia entre el portátil del analista y un costoso clúster de GPU. Pero conviene comprarlas tras probarlas con los pipelines propios, y no por un benchmark publicitario.
- 1 nov 2026Los modelos locales pierden ante Opus y Codex: 0,21 puntos en un MacBook frente a 1,00 de Codex
- 1 nov 2026Un autor de Habr ajusta YOLOv8l con radiografías dentales y lleva el mAP50 a 0,642
- 1 nov 2026Los bots de voz con LLM recurren al clasificador rápido Jev: decisiones en 200–500 ms
- 1 nov 2026La capa de seguridad MoneyGate frenó las 42 peticiones fraudulentas a IA locales
Preguntas frecuentes sobre la noticia
¿Qué se sabe sobre Por qué la CPU se queda corta?
El planteamiento gira en torno a tres cuellos de botella que conocen la mayoría de los equipos de data science. El primero es la preparación de datos: limpiar, unir tablas, rellenar huecos y crear variables suele consumir la mayor parte del tiempo antes de entrenar el modelo. El segundo es la escala: los volúmenes crecen más rápido de lo que los sistemas de sobremesa con CPU pueden procesar, por lo que los equipos a veces recortan las muestras y pierden calidad en los resultados. El tercero es el hardware: el acceso a aceleradores en la nube y en centros de datos es caro y,
¿Qué se sabe sobre Qué promete Blackwell?
El énfasis está en acelerar todo el flujo, desde las operaciones de pandas hasta el entrenamiento de modelos. Según NVIDIA, la biblioteca cuDF de la pila CUDA-X puede acelerar pipelines de Python sin reescribir código, y su combinación con PyData y XGBoost debería reducir de forma notable el tiempo de análisis exploratorio y de entrenamiento. La plataforma también está pensada para escenarios multiusuario, visualización avanzada y trabajo colaborativo mediante NVIDIA AI Workbench, de modo que un mismo proyecto pueda llevarse en una máquina local, en la nube y en un centro d
¿Qué se sabe sobre Apuesta por lo local?
Otro argumento es la economía y la seguridad. Cuando parte del pipeline pasa de la nube a la estación de trabajo, la empresa paga menos por el alquiler de cómputo y el almacenamiento, y los datasets sensibles permanecen dentro del perímetro. Para los sectores con requisitos de procesamiento on-premise, esto pesa más que el rendimiento puro. Además, una máquina local reduce la dependencia de la escasez de GPU en los centros de datos: hay que esperar menos por un hueco de entrenamiento o negociar un presupuesto aparte. PNY también subraya el componente corporativo: integració
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.