Machine Learning Mastery: por qué a las aplicaciones de IA no les basta un almacén vectorial
Machine Learning Mastery recordó algo simple: un vector store es muy útil para la búsqueda semántica, pero no sustituye a toda la base de datos de un producto de IA. En producción, junto a los embeddings casi siempre hace falta SQL para permisos, metadatos, facturación y estado de la aplicación. Para muchos equipos, PostgreSQL con pgvector puede ser el mejor punto de partida. Una base de datos vectorial independiente solo tiene sentido a gran escala.
Procesado por IA desde Machine Learning Mastery; editado por Hamidun News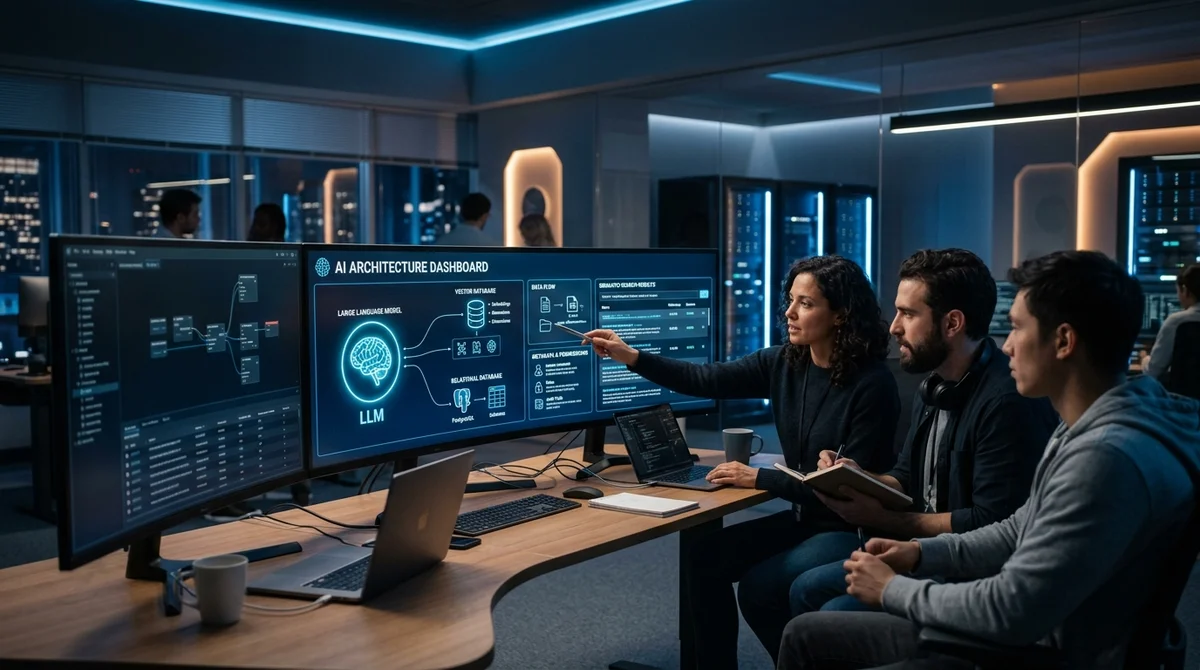
Machine Learning Mastery ha analizado un error habitual en la arquitectura de aplicaciones de IA: considerar el vector store una base de datos completa para todo el producto. En la fase de demo suele bastar, pero en producción junto a la búsqueda vectorial casi siempre hace falta una capa relacional clásica.
Dónde destaca un vector store
Las bases de datos vectoriales se han convertido en una pieza estándar de los sistemas RAG porque resuelven una tarea que el SQL tradicional maneja mal: buscar por significado y no por coincidencia exacta de palabras. Cuando el usuario hace una pregunta, el sistema la convierte en un embedding y busca los fragmentos de documentos más cercanos en significado. Así, la IA puede encontrar textos relevantes incluso cuando no usan las mismas formulaciones que la consulta.
Esto es especialmente útil con datos no estructurados: documentos internos, correspondencia, PDF y bases de conocimiento. Si alguien pregunta por los derechos del inquilino ante moho en un piso, la búsqueda vectorial encontrará secciones sobre estándares de habitabilidad u obligaciones del arrendador, aunque la expresión "condiciones de vida peligrosas" no aparezca en el documento. Este enfoque tolera mejor las erratas, las paráfrasis y el contexto implícito. Por eso el vector store se ha vuelto un componente básico de la búsqueda con IA allí donde las formulaciones casi nunca coinciden palabra por palabra.
Dónde hace falta SQL
El problema es que la flexibilidad de la búsqueda vectorial la convierte a la vez en una herramienta imprecisa para tareas operativas. Responde bien a "qué se parece en significado", pero no sirve donde se necesita una respuesta firme, sin probabilidades ni tolerancias. En cuanto el producto tiene usuarios, límites, pagos y estados de objetos, la búsqueda aproximada empieza a estorbar en lugar de ayudar.
Por eso, en un sistema en producción la base relacional sigue siendo el lugar donde viven todos los "hechos duros":
- permisos y límites entre tenants, donde un error se convierte en una fuga de datos;
- metadatos de documentos: autor, URL, fecha de carga, hash del archivo, estado de publicación;
- facturación, auditoría, logs y cualquier registro que deba ser consistente;
- estado de la aplicación: si un chat está archivado, si un flag está activo, qué tarifa tiene el usuario.
Hay otro punto práctico: el filtrado SQL preciso reduce las alucinaciones del modelo. Si la IA debe resumir solo los tickets de alta prioridad cerrados en los últimos 7 días por el equipo de frontend, primero hay que seleccionar con rigor exactamente esos registros y solo después pasar su texto al modelo. Es más barato, más rápido y más seguro que esperar a que la búsqueda vectorial por sí sola devuelva por casualidad un conjunto de datos perfectamente acotado. En esencia, aquí el SQL no compite con el LLM, sino que le prepara un espacio de trabajo correcto.
Un esquema híbrido
El autor propone no elegir entre los dos enfoques, sino combinarlos en una sola capa de datos. Un escenario típico es este: primero la base relacional comprueba el usuario, su rol y la lista de documentos a los que tiene acceso, y solo después el vector store busca coincidencias semánticas dentro de ese subconjunto seguro. Para los asistentes de IA corporativos no es una optimización, sino un límite de seguridad. Sin ese prefiltro, el sistema corre el riesgo de mostrar a un usuario datos de otro equipo o incluso de otro cliente.
También funciona el patrón inverso. Cuando la búsqueda vectorial devuelve fragmentos relevantes, la aplicación puede traer de SQL los metadatos: quién es el autor del documento, cuándo se actualizó, qué estado de confianza tiene. Así el modelo no responde en abstracto, sino con contexto, por ejemplo vinculado a la actualidad del documento o al departamento que lo emitió. Para bases de conocimiento internas y agentes de soporte, esto aumenta notablemente la confianza en la respuesta y ayuda al usuario a verificar rápido su origen.
Para los equipos que no quieren mantener dos bases distintas, Machine Learning Mastery destaca pgvector, una extensión de PostgreSQL para búsqueda por similitud. En esta variante los embeddings conviven con los campos estructurados, y una sola consulta puede comprobar permisos, filtrar registros por fecha y estado, y luego ordenarlos por cercanía semántica. El compromiso es simple: a escala moderada simplifica bastante la infraestructura, pero con miles de millones de vectores los sistemas especializados como Pinecone o Milvus siguen siendo más rápidos. En cambio, para cientos de miles o unos pocos millones de vectores, este enfoque suele ser el punto de partida más pragmático.
Qué significa
La conclusión principal es simple: el vector store es una parte importante de la pila de IA, pero no la sustituye por completo. Si el producto trabaja con usuarios, accesos, dinero y estado del sistema, no se puede prescindir de una base relacional. Para la mayoría de los equipos, un inicio razonable es PostgreSQL con pgvector, o una combinación de SQL más una base vectorial aparte, donde cada tecnología se ocupa solo del tipo de tareas que mejor resuelve. Cuanto antes aparezca esta separación en la arquitectura, menos probable es que la demo se venga abajo con el primer crecimiento real.
Preguntas frecuentes sobre la noticia
Dónde destaca un vector store?
Las bases de datos vectoriales se han convertido en una pieza estándar de los sistemas RAG porque resuelven una tarea que el SQL tradicional maneja mal: buscar por significado y no por coincidencia exacta de palabras. Cuando el usuario hace una pregunta, el sistema la convierte en un embedding y busca los fragmentos de documentos más cercanos en significado. Así, la IA puede encontrar textos relevantes incluso cuando no usan las mismas formulaciones que la consulta. Esto es especialmente útil con datos no estructurados: documentos internos, correspondencia, PDF y bases de c
Dónde hace falta SQL?
El problema es que la flexibilidad de la búsqueda vectorial la convierte a la vez en una herramienta imprecisa para tareas operativas. Responde bien a "qué se parece en significado", pero no sirve donde se necesita una respuesta firme, sin probabilidades ni tolerancias. En cuanto el producto tiene usuarios, límites, pagos y estados de objetos, la búsqueda aproximada empieza a estorbar en lugar de ayudar. Por eso, en un sistema en producción la base relacional sigue siendo el lugar donde viven todos los "hechos duros": permisos y límites entre tenants, donde un error se conv
¿Qué se sabe sobre Un esquema híbrido?
El autor propone no elegir entre los dos enfoques, sino combinarlos en una sola capa de datos. Un escenario típico es este: primero la base relacional comprueba el usuario, su rol y la lista de documentos a los que tiene acceso, y solo después el vector store busca coincidencias semánticas dentro de ese subconjunto seguro. Para los asistentes de IA corporativos no es una optimización, sino un límite de seguridad. Sin ese prefiltro, el sistema corre el riesgo de mostrar a un usuario datos de otro equipo o incluso de otro cliente. También funciona el patrón inverso. Cuando la
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.