Un sistema basado en LLM reduce de 2 horas a 5 minutos la preparación de fichas de control en una planta siderúrgica
En una planta metalúrgica enseñaron a un sistema LLM a leer escaneos de normas GOST y a elaborar fichas de control en 3–5 minutos en lugar de dos horas. El prompt universal fracasó. La solución que funcionó fue un conjunto de reglas distinto para cada documento, 20 GOST prioritarios y nueve iteraciones de ajuste. El proceso se aceleró 24 veces y las reglas se trasladaron a Excel para que los propios tecnólogos puedan modificarlas.
Procesado por IA desde Habr AI; editado por Hamidun News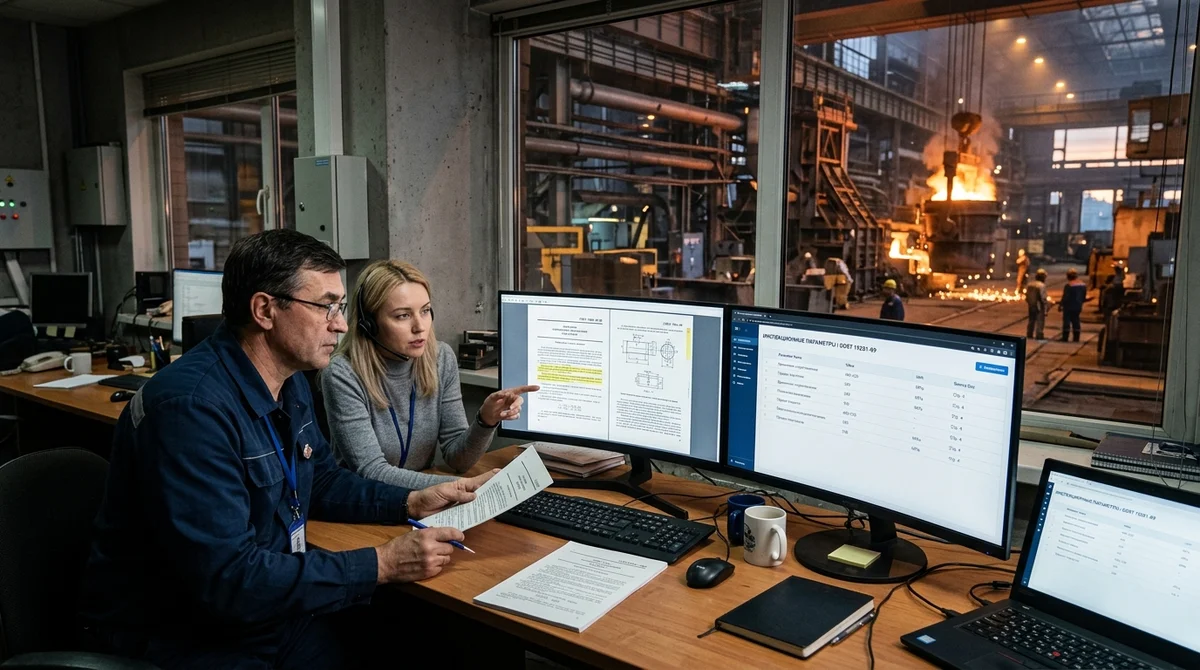
Un caso práctico de una empresa metalúrgica muestra que los grandes modelos de lenguaje ya no solo responden preguntas, sino que también pueden quitar a los ingenieros la pesada rutina normativa. Se entrenó un sistema para leer escaneos de GOST de la era soviética y elaborar automáticamente fichas de control en 3–5 minutos, en lugar de más de dos horas de trabajo manual. En horas de trabajo, según el autor del proyecto, esto elimina un volumen de tareas comparable al de tres tecnólogos.
El problema era muy terrenal. La empresa de ciclo completo emplea a unas 3200 personas y su nomenclatura supera las 4500 referencias y no deja de crecer. Para cada referencia, el tecnólogo debía abrir un GOST, un OST u otro documento normativo, localizar las tablas y notas pertinentes, introducir parámetros como la calidad del acero, el diámetro de la pieza en bruto y el grupo, y después rellenar a mano más de 40 parámetros de control.
La dificultad es que hay más de doscientos documentos y buena parte de ellos existe en forma de escaneos en PDF poco cómodos, de la época soviética. La primera idea fue un parser convencional, pero se descartó enseguida. El formato de las normas es demasiado heterogéneo: en un documento los valores necesarios están en filas de tablas, en otro se esconden en las notas, en un tercero están repartidos por el texto con remisiones a otras secciones.
Un esquema simple de extracción por plantilla se rompe aquí, porque la tarea exige entender el sentido del documento y no solo su estructura visual. Por eso el autor optó por los LLM y montó un esquema en el que el modelo recibe el PDF con la norma, los parámetros de la nomenclatura y un conjunto de reglas sobre cómo determinar cada parámetro de control. La siguiente hipótesis parecía lógica: crear un único prompt universal para todos los documentos normativos.
En la primera prueba, este enfoque dio un resultado decente. Según el autor, Claude Sonnet 4.6 en modo thinking identificó correctamente el 85% de los parámetros de un GOST, y GPT 5.
4, el 72%. Pero en los documentos siguientes la universalidad se vino abajo. Los modelos se confundían con las tablas anidadas, interpretaban mal condiciones límite como «no menos de» y «no más de», y a veces omitían constantes o vínculos entre secciones.
Resultó que un enfoque general elegante funcionaba peor que una arquitectura más estrecha pero controlable. La solución llegó tras analizar la nomenclatura con el principio de Pareto. Resultó que el 80% de las referencias de la planta se describen con aproximadamente el 18% de los GOST.
Para el piloto se eligieron los 20 documentos más utilizados y para cada uno se redactó un prompt propio con reglas concretas: dónde buscar el parámetro, en qué tabla o sección se describe y cómo interpretar los casos dudosos. El sistema recibía el PDF y las características del producto, y devolvía una tabla con el parámetro, su valor y una referencia al lugar de la norma. Cuando aparecía un error, el autor enviaba una captura de pantalla a la conversación, mostraba la respuesta correcta y pedía actualizar la regla para que el fallo no se repitiera.
El ajuste requirió nueve iteraciones y 14 días laborables, tras lo cual la extracción de parámetros de los GOST seleccionados funcionó sin errores. Ahora el proyecto pasa del modo experimental a uno más apto para producción. Las reglas se sacan de los prompts y se llevan a una tabla de Excel, para que los tecnólogos puedan modificar la lógica sin meterse en ingeniería de prompts.
El modelo recibe ya no solo el PDF y los parámetros del producto, sino también esta tabla de reglas, y devuelve los datos en un formato apto para cargarlos en el sistema de información interno de la empresa. Esta capa hace la solución escalable: se pueden añadir nuevas normas poco a poco sin que todo el mantenimiento dependa de un solo desarrollador. La conclusión principal del caso es simple: en la industria, los LLM funcionan mejor no como una «inteligencia universal para todo», sino como una herramienta bien ajustada a una clase concreta de documentos.
Si se empieza por las normas más frecuentes, se obliga al modelo a indicar la fuente de cada parámetro y se dejan las reglas editables por los especialistas de la materia, la IA pasa de demostración a mecanismo de producción con una economía clara. Este enfoque bien podría repetirse no solo en la metalurgia, sino también en la ingeniería mecánica, la construcción, la química, la farmacia y la energía: en cualquier lugar donde aún se trasladen a mano datos de reglamentos a sistemas de trabajo.
- 1 nov 2026Los modelos locales pierden ante Opus y Codex: 0,21 puntos en un MacBook frente a 1,00 de Codex
- 1 nov 2026Kimi logra un 96,2 % en un test de analítica sobre una base de 1C y se perfila como plan B ante un bloqueo de Claude
- 1 nov 2026OpenAI reescribe las reglas de comportamiento de GPT: cinco valores y una cadena de prioridades
- 1 nov 2026Google admite que AI Mode reduce los ingresos de su buscador: las acciones caen un 15%
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.