Google DeepMind deja que un LLM reescriba algoritmos de teoría de juegos y supere a los expertos
Google DeepMind aplicó AlphaEvolve a algoritmos para juegos de información incompleta como el póker. El sistema, basado en un LLM, reescribió el código de dos enfoques clave, CFR y PSRO, y generó nuevas variantes: VAD-CFR y SHOR-PSRO. La primera igualó o superó a las mejores soluciones manuales en 10 de 11 juegos; la segunda, en 8 de 11. La evaluación se hizo en escenarios más complejos que los algoritmos no habían visto antes.
Procesado por IA desde MarkTechPost; editado por Hamidun News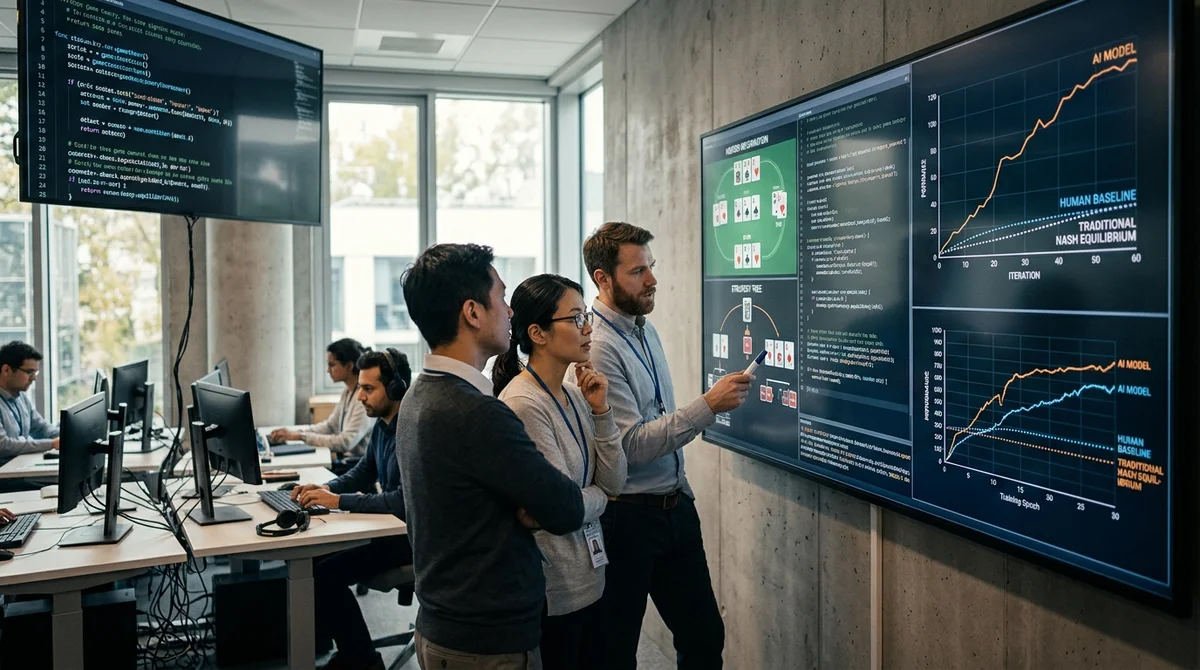
Google DeepMind ha demostrado que un modelo de lenguaje puede hacer algo más que ayudar a los investigadores a escribir código: puede buscar por su cuenta nuevas ideas algorítmicas en teoría de juegos y superar soluciones que los humanos llevan años puliendo. El trabajo trata del Multi-Agent Reinforcement Learning para juegos de información incompleta, situaciones en las que los participantes juegan por turnos y no ven los datos ocultos de los demás, como en el póker. En estas tareas, la calidad de un algoritmo suele depender no solo de la teoría de base, sino de muchos detalles de ingeniería: cómo acumular el arrepentimiento (regret), cómo descontar señales antiguas, cuándo empezar a promediar la estrategia y cómo buscar el equilibrio.
Normalmente todo esto se ajusta a mano, con intuición, una serie de hipótesis y largos experimentos. En un preprint publicado en arXiv el 18 de febrero de 2026, el equipo de DeepMind propuso delegar ese trabajo en AlphaEvolve, un agente evolutivo de reescritura de código que usa un LLM y una verificación automática de la calidad de cada nueva versión. En este trabajo, AlphaEvolve se aplicó a dos familias clásicas de algoritmos: CFR (Counterfactual Regret Minimization) y PSRO (Policy Space Response Oracles).
Los experimentos usaron el framework OpenSpiel y la calidad se midió con la exploitability, una métrica que indica cuánto puede explotar un rival, con su mejor respuesta, la estrategia encontrada. Un punto importante: los investigadores no se limitaron a ajustar hiperparámetros. El sistema modificó la propia lógica del código en Python que se encarga de acumular la señal de regret, construir la política actual y promediar las estrategias.
El trabajo señala explícitamente a Gemini 2.5 Pro como el modelo sobre el que se construyó este circuito de búsqueda. Para la familia CFR, el sistema encontró una nueva variante llamada VAD-CFR, Volatility-Adaptive Discounted CFR.
Su idea es que el algoritmo no usa reglas fijas para olvidar información antigua, sino que observa la volatilidad del aprendizaje y descuenta con más fuerza el historial en los momentos inestables. Además, AlphaEvolve añadió un refuerzo asimétrico de las señales de regret instantáneo positivas con un coeficiente de 1,1 y una regla inesperada de promediado: no empezar en absoluto a acumular la política media hasta la iteración 500. Esto resulta especialmente interesante porque el horizonte de evaluación era de 1000 iteraciones y el umbral de 500 lo dedujo el propio sistema, sin ninguna pista explícita en el prompt.
En el conjunto completo de 11 juegos, VAD-CFR igualó o superó a las mejores soluciones conocidas en 10 de los 11 casos; la única excepción fue la versión de Kuhn Poker para cuatro jugadores. Para PSRO, AlphaEvolve no buscó reglas de actualización del regret, sino un metasolucionador, que determina la distribución de probabilidad sobre la población de estrategias. Así surgió SHOR-PSRO, Smoothed Hybrid Optimistic Regret PSRO.
Esta variante combina el optimistic regret matching con una distribución suave sobre las mejores estrategias puras y, a lo largo del entrenamiento, ajusta gradualmente el equilibrio entre exploración y convergencia hacia el equilibrio. En la práctica, esto elimina parte del ajuste manual que antes era obligatorio: el investigador ya no tiene que adivinar de antemano cuándo debe el sistema fomentar la diversidad de estrategias y cuándo acercarse con más firmeza al equilibrio. En el conjunto completo de 11 juegos, SHOR-PSRO igualó o superó a las mejores soluciones manuales de referencia en 8 casos.
También importa que DeepMind no comprobó solo el ajuste a los ejemplos de entrenamiento. Los dos esquemas hallados evolucionaron primero en cuatro juegos, entre ellos 3-player Kuhn Poker, 2-player Leduc Poker, 4-card Goofspiel y 5-sided Liar's Dice, y después se probaron, sin reajuste adicional, en variantes más grandes y no vistas de las mismas clases de problemas. Esto es más sólido que la demostración habitual en uno o dos entornos de juguete: muestra al menos una capacidad básica de los algoritmos para generalizar más allá del conjunto en el que se hizo la búsqueda.
La conclusión principal es sencilla: los LLM empiezan a automatizar no solo la escritura de código, sino el diseño de los propios algoritmos. Para los investigadores, esto cambia su papel: menos prueba y error manual con heurísticas, más definición de la métrica, las restricciones y el sistema de verificación. Con todo, el trabajo no demuestra que el modelo pueda inventarlo todo de forma universal: el éxito depende de una función de evaluación clara y de dominios en los que la calidad de la solución se puede comprobar con rigor.
Aun con esa salvedad, el resultado parece serio: DeepMind mostró que, en áreas acotadas y formalizables, una máquina ya puede encontrar jugadas a las que los expertos no llegaron a mano.
- 2 nov 2026Karpathy montó en dos horas un clon de YouTube con 6454 vídeos recomendados en Hacker News
- 2 nov 2026Karpathy usó Claude para crear HackerTube, con 6454 vídeos recomendados en Hacker News
- 2 nov 2026Anthropic debe aumentar sus ingresos un 32% al año para cubrir contratos por $850 mil millones
- 2 nov 2026El creador de Bun migra 750 mil líneas de Zig a Rust en 11 días con Claude Code
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.