Google DeepMind presenta Gemini Robotics-ER 1.6 para tareas autónomas en el mundo real
Google DeepMind ha actualizado Gemini Robotics-ER a la versión 1.6 con la mirada puesta en escenarios reales: desde el reconocimiento de objetos y la verificación de tareas hasta la lectura de sensores y manómetros. El modelo funciona mejor con varias cámaras, cuenta y localiza objetos con más precisión y admite llamadas a herramientas externas. Ya está disponible a través de la API de Gemini y Google AI Studio.
Procesado por IA desde DeepMind Blog; editado por Hamidun News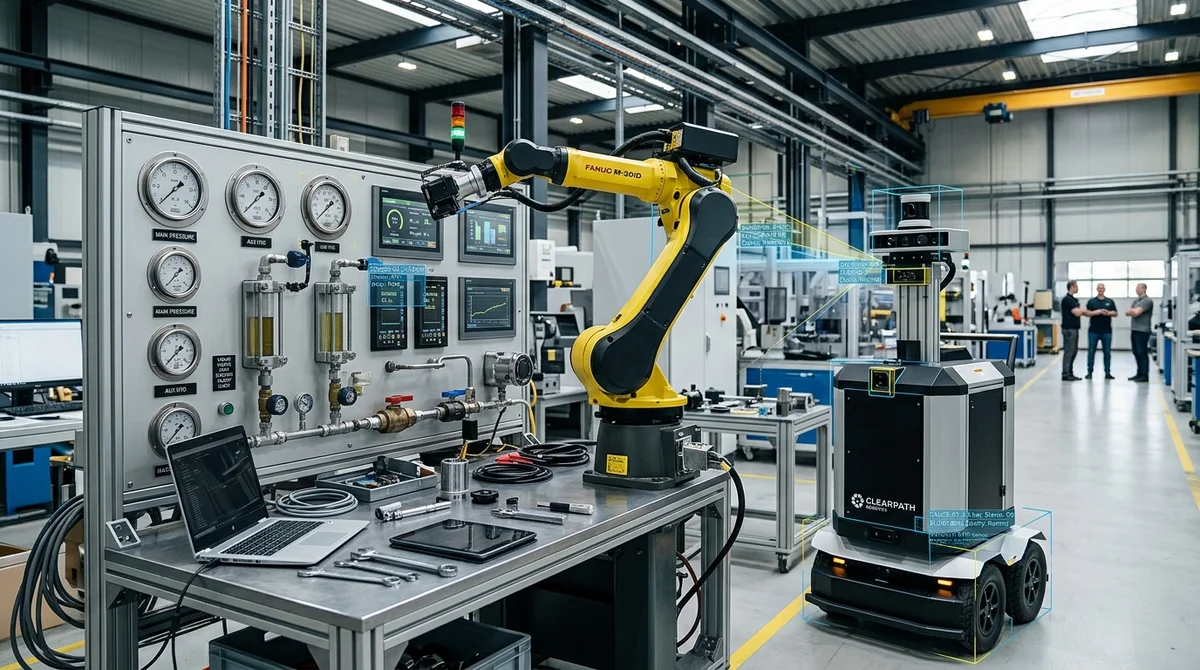
El 14 de abril de 2026, Google DeepMind presentó Gemini Robotics-ER 1.6, un modelo de razonamiento actualizado para robots, diseñado no solo para ejecutar órdenes, sino para entender el entorno físico. La compañía apuesta por el embodied reasoning, es decir, la capacidad de un sistema de conectar la percepción visual, el contexto de la tarea y la acción real.
La nueva versión pone el acento en un razonamiento espacial más preciso, la comprensión de la escena desde varias cámaras, la detección de que una tarea se ha completado con éxito y la lectura de instrumentos industriales. En esencia, es un «cerebro» de alto nivel para el robot que puede invocar herramientas externas, modelos VLA y funciones definidas por el usuario para ejecutar escenarios complejos en el mundo real.
Una de las mejoras clave es el trabajo con tareas espaciales. DeepMind explica que, para un robot, una operación básica como señalar un objeto no es una nimiedad, sino la base de comportamientos más complejos. Mediante puntos, el modelo no solo puede encontrar objetos, sino también contarlos, comparar tamaños, establecer relaciones entre ellos, elegir los mejores puntos de agarre y comprobar las restricciones indicadas en el prompt.
Por ejemplo, si el sistema debe señalar todos los objetos que caben en una taza azul, tiene que reconocer a la vez la forma, el tamaño y la posición relativa de los elementos. En las demostraciones, Gemini Robotics-ER 1.6 contó con más precisión las herramientas del encuadre, no señaló objetos que no estaban y, en general, resolvió estas tareas notablemente mejor que Gemini Robotics-ER 1.
5 y Gemini 3.0 Flash.
El segundo bloque importante es la comprensión de la escena desde varios ángulos y la llamada success detection, es decir, la capacidad de determinar si una tarea realmente se ha completado. Para la robótica autónoma esto es crítico: no basta con que el robot inicie una acción; debe decidir si tiene que repetir el intento o puede pasar al siguiente paso del plan. En instalaciones reales es especialmente difícil, porque las cámaras suelen ver la escena desde arriba y desde el manipulador a la vez, algunos objetos pueden quedar tapados y la iluminación y el fondo cambian.
Gemini Robotics-ER 1.6 correlaciona mejor varios flujos de vídeo y construye con ellos una imagen coherente. Como ejemplo, DeepMind muestra un escenario en el que el sistema determina, a partir de varias vistas, si se ha completado la tarea «poner el bolígrafo azul en el portalápices negro».
La novedad más práctica es la lectura de instrumentos. DeepMind desarrolló esta capacidad junto con Boston Dynamics, a partir de tareas de inspección de instalaciones industriales. En fábricas y salas técnicas, un robot debe revisar con regularidad termómetros, manómetros, indicadores químicos de nivel, mirillas y pantallas digitales. Para ello no basta con reconocer la imagen: el sistema debe entender la posición de la aguja, el nivel del líquido, los límites de la escala, las divisiones y las etiquetas de las unidades de medida, y a veces incluso combinar las lecturas de varias agujas que corresponden a distintos dígitos. En el caso de una mirilla, además hay que tener en cuenta las distorsiones causadas por el ángulo de la cámara.
Según DeepMind, la precisión en la lectura de instrumentos subió del 23 % de Gemini Robotics-ER 1.5 y el 67 % de Gemini 3.0 Flash al 86 % de Gemini Robotics-ER 1.6. Con el modo agentic vision activado, la cifra llega al 93 %: el modelo primero amplía la zona relevante, luego señala puntos clave y ejecuta código para estimar proporciones e intervalos, y por último interpreta el valor final.
DeepMind subraya además la seguridad. La compañía describe Gemini Robotics-ER 1.6 como su modelo de robótica más seguro hasta la fecha. Respeta mejor las políticas de Gemini en tareas espaciales adversariales y se ciñe con notable mayor precisión a las restricciones físicas, por ejemplo cuando el sistema no debe manipular líquidos ni levantar objetos de más de 20 kilogramos. Además, en escenarios basados en informes reales de lesiones, Robotics-ER supera a Gemini 3.0 Flash: 6 puntos porcentuales más en tareas de texto y 10 puntos más en tareas de vídeo relacionadas con el reconocimiento de riesgos.
El modelo ya está disponible para desarrolladores a través de la API de Gemini y Google AI Studio. Junto con el lanzamiento, DeepMind publicó un ejemplo en Colab e invitó a los socios a enviar imágenes etiquetadas de errores típicos para mejorar las próximas versiones.
La actualización muestra hacia dónde se desplaza la competencia en robótica: la mecánica decide cada vez menos y la capa de razonamiento que la gobierna, cada vez más. Si un modelo sabe ver la escena desde varios puntos, usar herramientas, leer instrumentos, verificar el resultado y respetar las restricciones de seguridad, el robot deja de ser un simple dispositivo ejecutor y se convierte en un sistema capaz de trabajar según la situación. Para inspecciones industriales, almacenes y servicios, es una de las señales más prácticas de que los grandes modelos de IA se acercan a una autonomía real fuera del laboratorio.
- 18 nov 2026Huang deja el cargo de CEO de NVIDIA y la compañía pierde más de $1 billón en capitalización
- 18 nov 2026Google lanza Gemini 4 Neon para Chat y Tasks: 1M de tokens y $3 por millón de entrada
- 18 nov 2026Google lanza Gemini 4 Neon: tercer puesto en el ranking de IA y una tarea un 32% más barata
- 18 nov 2026El agente Devin Bot construyó solo una app de Android en 44 días: 1 134 PR con 183 mensajes
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.