Playwright y MCP: cómo un agente de IA verifica la interfaz y la base de datos sin aserciones SQL manuales
Un aviso verde tras el checkout no prueba que el pedido se haya creado de verdad. Un nuevo patrón de verificación full-stack propone encargar al agente de IA las dos partes del escenario: recorrer la interfaz con Playwright y, después, comprobar con un segundo servidor MCP el registro en la base de datos, las líneas del pedido y el descuento de existencias. Esto reduce el volumen de código de prueba y elimina las comprobaciones SQL manuales de los tests end-to-end.
Procesado por IA desde Habr AI; editado por Hamidun News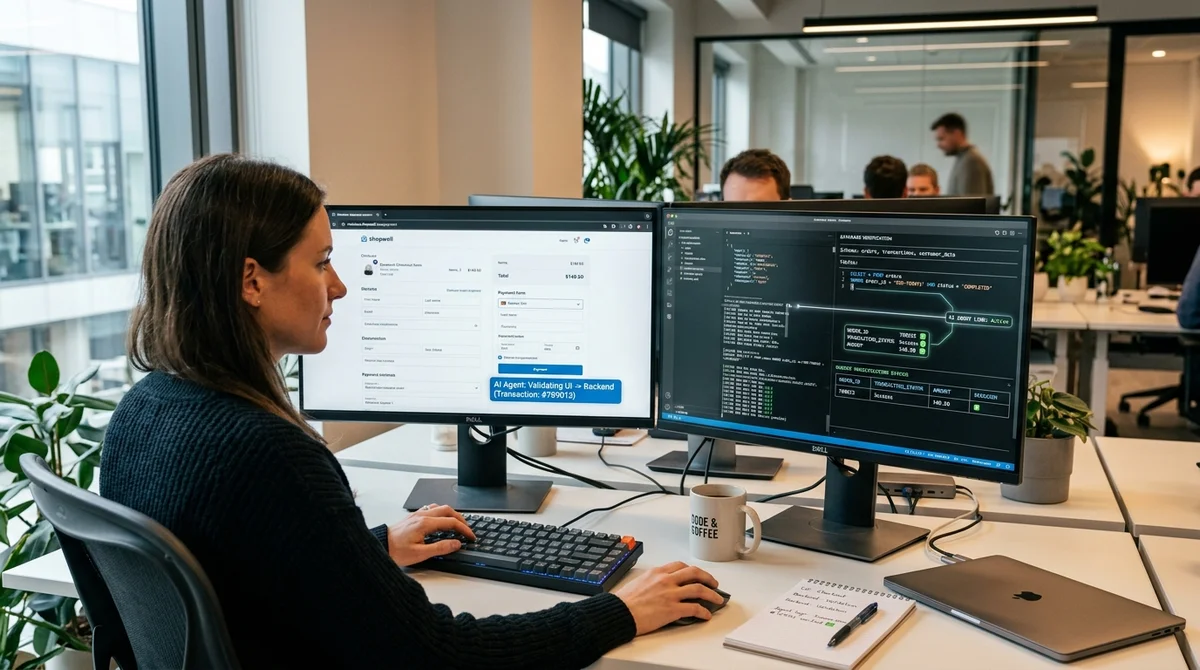
Un único aviso verde tras pulsar el botón «Finalizar pedido» no significa que el pedido se haya creado de verdad. Si la transacción se revirtió, una cola perdió el mensaje y la interfaz mostró «correcto» de todos modos, el test end-to-end da una falsa sensación de fiabilidad. Por eso cada vez más equipos apuestan por la verificación full-stack, que comprueba no solo la interfaz, sino también el estado real de los datos en la base.
En el enfoque clásico, la infraestructura de pruebas necesita acceso directo a la base de datos mediante un ORM o un controlador de bajo nivel. Ahí empiezan los costes añadidos: credenciales propias, configuración de conexiones, aserciones SQL manuales y mantenimiento de las consultas cada vez que cambia el esquema. En teoría esto resuelve el problema, pero el coste crece con el número de escenarios. Cada nuevo test end-to-end deja de ser solo una comprobación del comportamiento del usuario y se convierte en un pequeño proyecto de mantenimiento de código de prueba.
El artículo analiza un patrón más ligero: un único agente de IA trabaja de forma secuencial con dos servidores MCP. Primero ejecuta con Playwright el escenario en el navegador como un usuario normal: llena el carrito, pasa por el checkout, pulsa el botón de confirmación y registra los indicios clave del resultado. Después, el mismo agente cambia a un servidor capaz de leer la estructura de la base de datos y responder a consultas de verificación sin que el tester escriba SQL a mano.
En esencia, al agente le basta con formular qué debe confirmar: si existe el registro del pedido, si coinciden las líneas, si se descontó el stock del producto, si cambió el estado del pago. Este enfoque cierra la brecha principal entre «la interfaz mostró éxito» y «la operación de negocio realmente se completó». El agente puede cotejar los datos de la interfaz con los registros de las tablas, comprobar efectos secundarios e incluso tener en cuenta la asincronía si el sistema no escribe en la base al instante.
Para los equipos de producto, esto es especialmente importante en escenarios donde un solo botón del usuario dispara una cadena de acciones: crear el pedido, reservar inventario, registrar en el sistema logístico, actualizar el estado del cliente. Es en esos puntos donde con más frecuencia nacen los errores caros que un test de interfaz normal no detecta.
El valor práctico del patrón está en que baja la barrera de entrada a las pruebas full-stack. El equipo no tiene que meter un ORM en los tests solo para unas pocas comprobaciones ni duplicar el conocimiento del esquema de la base en el código de las aserciones. En su lugar aparece una capa única de verificación expresada como intenciones: «tras finalizar el pedido debe aparecer un registro», «el número de líneas debe coincidir», «el stock del almacén debe disminuir en una unidad».
Si el esquema cambia, el mantenimiento se traslada al servidor MCP o a la descripción del acceso a datos, en lugar de repartirse por decenas de tests. Como resultado, los tests son más cortos, más claros y más cercanos al lenguaje del negocio.
Aun así, este escenario no elimina la disciplina básica de ingeniería. No se puede confiar solo en el agente de IA: los tests unitarios y de integración siguen siendo necesarios para localizar rápido los errores en funciones, servicios y contratos. El acceso del agente a la base debe estar limitado, preferiblemente de solo lectura y únicamente en el entorno de pruebas. También hacen falta medidas de previsibilidad: datos de prueba estables, reglas de selección claras y protección para que el agente no compruebe por error un pedido equivocado en una base compartida. De lo contrario, una herramienta cómoda se convertirá pronto en una fuente de fallos ruidosos y difíciles de reproducir.
La conclusión principal es sencilla: el siguiente paso del testing end-to-end es pasar de comprobar pantallas a comprobar las consecuencias reales de la acción del usuario. La combinación de Playwright y MCP hace ese paso bastante más barato, porque elimina el SQL manual del trabajo diario del tester y permite que una sola automatización recorra el camino desde el clic en el botón hasta el hecho de que exista el registro en la base. Para los equipos que prueban pagos, pedidos, reservas y otras transacciones críticas, no es solo una técnica cómoda, sino una forma de reducir el número de tests falsos positivos y de detectar antes errores que antes se colaban en producción.
Build & Ship Production AI Agents Without Boilerplate Code
Start your free 72-hour trial at Hamidun Academy (academy.hamidun.com) — interactive lessons on Claude Code & Cursor, live Tech Radar, and production agent templates.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.