Habr AI: por qué los modelos de lenguaje necesitan guardrails y cómo protegerse del prompt hacking
Los LLM pasan rápidamente de la fase experimental a convertirse en infraestructura, y con ello crece el coste de sus errores. Los guardrails se consolidan como una capa de protección obligatoria: filtran contenido tóxico, detectan prompt injection, limitan el acceso a herramientas y reducen el riesgo de fugas. Para los desarrolladores, esto ha dejado de ser un tema opcional. Ya es una disciplina de ingeniería propia, con un stack creciente de soluciones, pruebas y verificaciones automáticas.
Procesado por IA desde Habr AI; editado por Hamidun News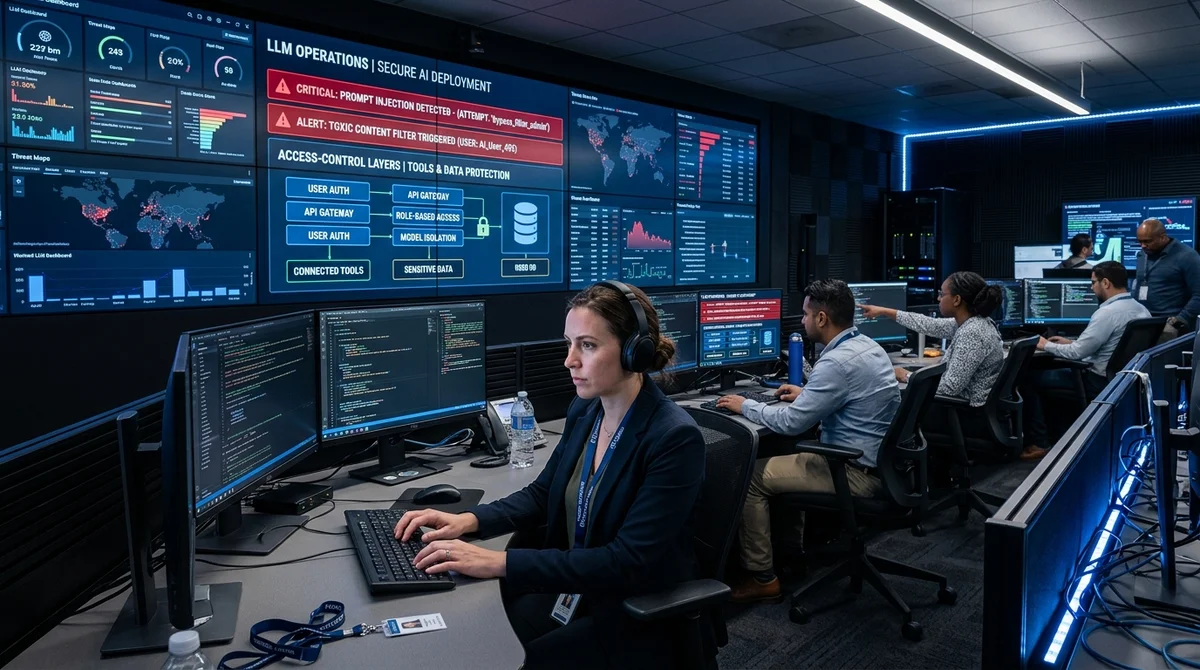
Los modelos de lenguaje están dejando de ser un juguete para demos y se convierten en una capa de infraestructura que influye en la búsqueda, la atención al cliente, la analítica, las ventas y los procesos internos de las empresas. En esta etapa, el gran problema ya no se limita a la calidad de las respuestas: también importa la capacidad de controlar el comportamiento del modelo. Si un LLM puede saltarse las reglas, generar texto tóxico, revelar instrucciones internas o ejecutar una acción peligrosa a través de una herramienta conectada, la empresa necesita algo más que un buen prompt: necesita un sistema completo de restricciones de protección, los llamados guardrails.
Con este término se suele designar un conjunto de mecanismos que controlan el modelo en la entrada, durante el procesamiento y en la salida. Y su alcance va más allá de moderar insultos o bloquear peticiones claramente prohibidas. Las vulnerabilidades de los LLM son mucho más amplias: prompt injection y ataques de jailbreak, elusión de las instrucciones del sistema, alucinaciones, fugas de datos personales o corporativos, uso inseguro de API externas y documentos, y manipulaciones a través del contexto que el modelo recibe del correo, el CRM, páginas web o la base de conocimiento.
Incluso sin mala intención, un usuario puede formular una petición de tal forma que el modelo se salga de los límites aceptables y, si tiene acceso a herramientas, empiece a ejecutar acciones que nadie aprobó explícitamente. Cuanto más conectan las empresas los LLM a datos y acciones reales, mayor es el riesgo de que un error del modelo deje de ser una simple respuesta extraña y se convierta en un incidente de seguridad, un daño reputacional o una pérdida económica directa. Por eso, alrededor de los guardrails se está formando con rapidez un stack tecnológico propio.
Incluye filtros de peticiones entrantes, clasificadores de intención, detectores de instrucciones maliciosas, políticas de acceso a herramientas, restricciones por roles, enmascaramiento de datos sensibles, verificación de hechos, validación de salidas estructuradas y posprocesamiento de la respuesta antes de enviarla al usuario. En los escenarios con agentes, esta capa gana todavía más peso: el modelo ya no se limita a escribir texto, sino que llama a funciones, hace búsquedas, lee archivos, crea tareas o modifica registros en los sistemas. Aquí los guardrails actúan como un gestor de reglas: deciden qué acciones están permitidas, en qué orden, con qué parámetros y ante qué señales hay que detener la cadena.
En la práctica, la industria está llegando a la conclusión de que la seguridad de un LLM no es un único ajuste del modelo, sino una arquitectura formada por varias comprobaciones independientes. De ahí el interés por frameworks especializados, policy engines, plataformas de observabilidad y prácticas de red teaming para LLM. Para los desarrolladores, esto abre una nueva especialización en la intersección entre la IA aplicada, la ingeniería backend y la seguridad.
Ya no basta con saber montar un chat sobre la API de un modelo: hay que entender la superficie de ataque, diseñar pipelines seguros, separar las fuentes de contexto confiables de las no confiables, registrar las respuestas dudosas, crear conjuntos de evaluación y comprobar con regularidad cómo se comporta el sistema bajo la presión de peticiones atípicas. En la práctica, esto implica varios pasos básicos desde el inicio: limitar estrictamente el acceso del modelo a datos y herramientas según el principio de mínimo privilegio, separar las instrucciones del sistema de la entrada del usuario, tratar todos los documentos y contenidos web entrantes como potencialmente hostiles, validar el JSON y los comandos antes de ejecutarlos y mantener a una persona en el circuito para las operaciones de riesgo. Además, crece la demanda de equipos capaces de integrar estas comprobaciones en el CI/CD y en la analítica de producto, en lugar de reducirlas a una auditoría puntual antes del lanzamiento.
Las empresas que adopten antes estas prácticas obtendrán productos más seguros y, además, una economía de explotación de los LLM más predecible. La conclusión principal es sencilla: los guardrails dejan de ser un «complemento para los prudentes» opcional y se convierten en un nivel de madurez obligatorio para cualquier producto serio basado en LLM. Cuanto más integrado está el modelo en los procesos de negocio, menos importa lo convincente que suenen sus respuestas y más importa la solidez con la que el sistema resiste la entrada maliciosa, los errores de contexto y la tentación de otorgar al modelo permisos innecesarios.
Por eso crecerá la demanda de modelos, pero también la de herramientas, pruebas e ingenieros capaces de mantener la IA dentro de límites seguros.
- 18 nov 2026El creador de Digg lanza una alternativa abierta a DocuSign: $240 al año en lugar de $8 100
- 18 nov 2026AI Scientist de Sakana fallaba en el 42% de las ejecuciones: el código lo escribía el propio modelo
- 18 nov 2026Una IA de lenguaje en el ESP32-S3 se acelera hasta 406 tokens/s: 18 veces más rápido
- 12 nov 2026El sindicato de Oakland logra reciclaje profesional en lugar de despidos por la IA: 94,1 % a favor de la huelga
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.