AWS publica una guía práctica para ajustar Amazon Nova con el Nova Forge SDK
AWS ha publicado la segunda parte de su serie sobre Nova Forge SDK y muestra un escenario aplicado de ajuste fino de Amazon Nova. La guía cubre la preparación de datos, su mezcla durante el entrenamiento y la evaluación posterior de la calidad. En la práctica, es un playbook listo para los equipos que quieren adaptar el modelo a su dominio sin construir el proceso desde cero.
Procesado por IA desde AWS Machine Learning Blog; editado por Hamidun News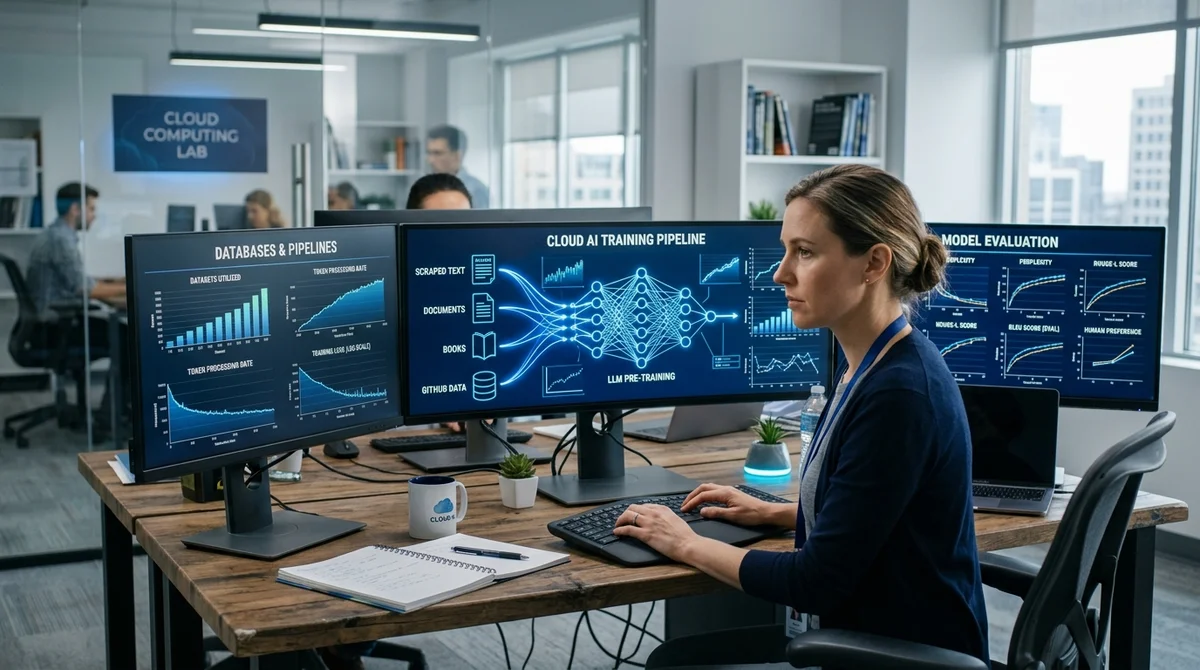
AWS ha publicado la segunda parte de su serie sobre Nova Forge SDK. Esta vez pasa de la visión general a las instrucciones prácticas: cómo ajustar un modelo Amazon Nova con datos propios, usar la mezcla de conjuntos de datos y comprobar después si el ajuste tuvo un efecto real. El material no se lee como una presentación de funciones, sino como un escenario de trabajo que un equipo puede replicar casi paso a paso.
La guía se centra en el ciclo completo de ajuste del modelo. AWS describe el camino desde la preparación del corpus hasta el lanzamiento del entrenamiento y la evaluación posterior de los resultados. Importa porque muchos equipos no se atascan por tener o no un modelo, sino por el proceso: cómo llevar los datos al formato adecuado, con qué complementar los ejemplos internos, cómo no perder las capacidades base del modelo tras especializarlo y con qué criterios decidir si el ajuste ha merecido la pena.
En esta lógica, Nova Forge SDK se presenta como una herramienta que ayuda a estandarizar el experimento y hacerlo repetible. En lugar de acciones dispersas (un script para los datos, una configuración de entrenamiento aparte, una revisión manual de calidad aparte), la compañía propone reunirlas en una secuencia clara de pasos.
La guía pone un énfasis especial en el data mixing, la mezcla de conjuntos de datos durante el ajuste fino. Para los equipos prácticos es uno de los temas clave: si se entrena el modelo solo con un conjunto corporativo estrecho, puede responder mejor en ese dominio concreto y, al mismo tiempo, perder utilidad general, estilo o robustez en las respuestas. La incorporación de distintos tipos de ejemplos se suele usar para mantener el equilibrio entre especialización y calidad del modelo base. En el contexto de Amazon Nova, significa poder adaptar el sistema con más precisión a cada escenario, como documentación interna, soporte, clasificación o generación de textos, sin convertir el ajuste en una caja negra.
A juzgar por la descripción del material, AWS se centra en el aspecto práctico: no solo explicar el concepto, sino mostrar cómo trabajar con las proporciones de datos e integrar esta etapa en el pipeline general de entrenamiento.
La guía también dedica un apartado a evaluar el resultado tras el fine-tuning. Es una etapa tan importante como el propio entrenamiento: sin una comprobación clara, es fácil acabar con un proceso bien configurado que en producción no mejora las respuestas del modelo. Por eso el valor de esta guía no está solo en las instrucciones de lanzamiento, sino en el intento de unir preparación de datos, entrenamiento y evaluación en una sola cadena. Para los equipos de producto es especialmente útil, porque la decisión de desplegar un modelo ajustado no suele tomarse por intuición, sino por la calidad en tareas reales: precisión, estabilidad, ajuste al estilo y menos errores en los escenarios objetivo.
Otro punto fuerte del material es la reproducibilidad. AWS lo presenta explícitamente como un playbook, es decir, un esquema repetible que se puede adaptar al caso propio. Resulta práctico para equipos de ML y de producto que quieren algo más que «probar el fine-tuning» y construir un flujo claro de experimentos: preparar la muestra, definir las proporciones de mezcla, entrenar el modelo, comprobar la calidad, registrar las conclusiones y pasar a la siguiente iteración. En esencia, se trata de pasar el ajuste fino de experimentos manuales puntuales a un proceso más disciplinado, en el que es más fácil comparar resultados entre versiones y decidir con datos en lugar de por intuición.
También importa que sea ya la segunda parte de la serie sobre Nova Forge SDK. La primera se dedicó al lanzamiento de experimentos de personalización, y el nuevo material continúa el tema y baja a un nivel más práctico. El formato favorece a AWS: la compañía no se limita a anunciar los modelos Amazon Nova, sino que va construyendo documentación aplicada para quienes los integran de verdad en productos. Es también una señal reveladora para el mercado: la competencia ya no gira solo en torno al tamaño del contexto, la velocidad o los resultados en benchmarks, sino también a la comodidad de las herramientas que acortan el camino entre un modelo base y una solución adaptada a un dominio.
La conclusión principal es sencilla: AWS apuesta no solo por los propios modelos Amazon Nova, sino por un proceso gestionado para ajustarlos. Si la serie sobre Nova Forge SDK mantiene este nivel de detalle, puede convertirse en un apoyo útil para los equipos que no necesitan un stack de IA abstracto, sino instrucciones claras para convertir un modelo general en una herramienta de trabajo para una tarea concreta.
- 31 oct 2026Worldwide Express encargó las facturas en disputa a agentes de IA y redujo su deuda un 75%
- 30 oct 2026AWS ofrece a los agentes de código una vista previa en vivo del sitio desde la sesión aislada
- 30 oct 2026MoEngage abre 400 API cerradas a agentes de IA con AgentCore Gateway, sin servidores MCP propios
- 29 oct 2026NVIDIA Nemotron 3.5 Super VL: 120 mil millones de parámetros, 12 mil millones activos, despliegue en AWS
Ship AI Faster with Founders, Engineers & Weekly Architecture Reviews
Inside Vibe Club (hamidun.com/club) — weekly live masterminds with Zhemal Khamidun, Tech Radar, full LMS access, and 370+ production Claude Code skills.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.