Por qué LoRA falla en producción y cómo RS-LoRA salva el ajuste fino de modelos
LoRA funciona bien cuando el modelo solo necesita cambiar de tono, formato o personalidad, pero rinde peor cuando hay que incorporarle hechos nuevos. Un rango bajo recorta una señal de alta dimensión, y subir el rango sin más debilita el aprendizaje. RS-LoRA propone un cambio simple: usar alpha/√r en lugar de alpha/r, lo que mantiene la estabilidad con rangos altos.
Procesado por IA desde MarkTechPost; editado por Hamidun News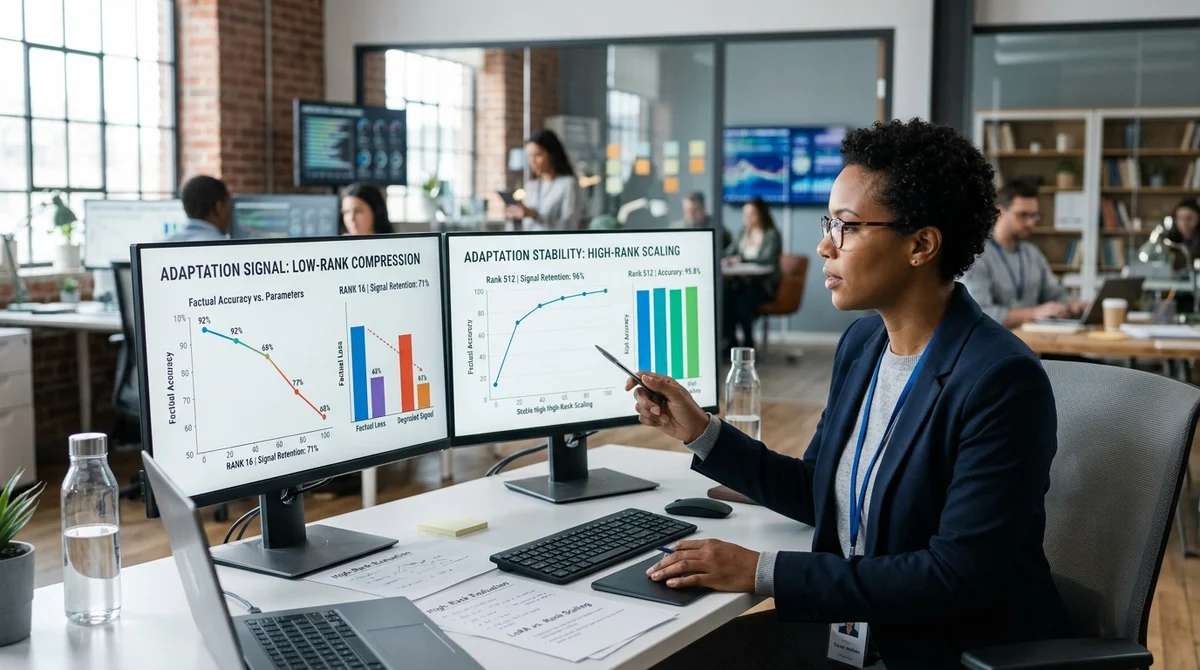
LoRA lleva tiempo siendo el estándar para el ajuste fino barato de modelos grandes, pero en producción arrastra una suposición oculta: que todas las actualizaciones de pesos son parecidas. En la práctica no lo son. Los cambios que controlan el estilo son realmente compactos, mientras que las actualizaciones que añaden hechos nuevos y experiencia de dominio se reparten en muchas dimensiones, y ahí es donde la LoRA convencional empieza a perder información.
La popularidad de LoRA tiene explicación: el método permite ajustar un modelo sin recalcular todos sus parámetros, usando pequeñas matrices de rango bajo. Funciona bien cuando hay que cambiar el tono, el formato de respuesta, el personaje o los hábitos de habla de un asistente. El artículo lo demuestra con una matriz de pesos simplificada de 64×64: en una actualización de estilo, unos pocos valores singulares dominan claramente, así que una aproximación de rango 4 u 8 conserva casi toda la señal.
En su simulación, con rango 4 ya se cubre más del 99% de la variación útil. Por eso un chatbot aprende con facilidad un nuevo estilo de comunicación, una plantilla de respuesta o una manera concreta de expresarse, sin reentrenar todo el modelo.
Los problemas empiezan cuando hay que enseñar contenido y no forma: datos médicos, catálogos de productos, normativas internas, estadísticas o reglas sectoriales. Estas actualizaciones se comportan como de rango alto: la información está repartida en muchas direcciones en lugar de concentrarse en unos pocos componentes dominantes. En el experimento del artículo, el rango 8 retiene solo un 28% aproximado de la señal real.
De ahí un efecto conocido en producción: el modelo suena seguro, usa la terminología correcta y la estructura general de la respuesta, pero confunde cifras, omite detalles o da una conclusión incompleta. Para asistentes corporativos, analítica, soporte y escenarios basados en conocimiento, no es un fallo cosmético, sino un riesgo de calidad.
La diferencia clave se ve en el espectro de valores singulares. Las tareas de estilo tienen un codo claro: tras unos pocos componentes, las dimensiones adicionales apenas aportan. Los hechos tienen una cola larga, donde cada componente adicional suma parte del conocimiento útil. Cuando LoRA trunca con dureza una actualización así a un rango bajo, corta precisamente esa cola. Por fuera, el sistema puede parecer mejorado, porque el formato, el tono y la estructura quedan más pulidos, pero la precisión factual mejora mucho menos de lo que sugieren las pruebas superficiales. Eso explica por qué las demos con respuestas vistosas y buen estilo no garantizan un comportamiento fiable con datos reales de trabajo.
La reacción lógica de un ingeniero es subir el rango. Pero la LoRA estándar tiene un segundo problema oculto: el escalado alpha/r. Cuanto mayor es el rango, más se comprime el coeficiente y más débil es la señal de entrenamiento.
En el ejemplo con alpha = 16, la escala cae de 16 con rango 1 a 0,25 con rango 64. El resultado es una paradoja: se añade capacidad para que el modelo represente una actualización más compleja, pero a la vez se reduce la influencia real de esa actualización sobre los pesos. El optimizador tiene que compensarlo con pasos más agresivos, de modo que el entrenamiento converge peor o se vuelve inestable.
Por eso, el consejo de subir el rango en producción a menudo no resuelve el problema y a veces solo lo disimula.
RS-LoRA propone una corrección mínima pero importante: usar alpha/√r en lugar de alpha/r. Formalmente es casi cambiar un símbolo, pero en la práctica el efecto es grande. Con rango 64 la escala se queda en 2,0 en vez de 0,25, de modo que la adaptación de rango alto conserva una magnitud significativa y no mata la señal.
El artículo lo demuestra sin bucles de entrenamiento pesados ni frameworks, solo con NumPy, SVD y una comparación de errores de reconstrucción. Eso hace el argumento especialmente claro: las tareas de estilo de rango bajo se siguen resolviendo bien con la LoRA convencional, mientras que las tareas de incorporación de conocimiento exigen RS-LoRA o una estrategia de adaptación distinta desde el principio.
La conclusión para los equipos que llevan LLM ajustados a producción es bastante directa: la configuración del adaptador debe elegirse no solo por presupuesto y velocidad, sino también por el tipo de actualización. Si se cambia el tono, el personaje o el formato de respuesta, la LoRA estándar de rango bajo suele bastar. Si se incorporan hechos nuevos, datos de referencia, reglas o experiencia de dominio, un rango bajo puede crear la ilusión de un entrenamiento exitoso mientras pierde en silencio una parte sustancial de la información. En esos casos, RS-LoRA deja de parecer una optimización fina y pasa a ser un requisito de fiabilidad del modelo en explotación real.
- 25 jul 2026Hiperredes en lugar de LoRA: leyes de escalado para la inyección de conocimiento en LLM
- 7 jul 2026Cómo entrenar Gemma-3 en matemáticas con GRPO y adaptadores LoRA
- 27 feb 2026Sakana AI logra adaptar modelos de lenguaje al instante y sin reentrenamiento
- 9 oct 2026Modelos enanos: cómo las empresas ahorran en IA afinando LLMs diminutos
Ship AI Faster with Founders, Engineers & Weekly Architecture Reviews
Inside Vibe Club (hamidun.com/club) — weekly live masterminds with Zhemal Khamidun, Tech Radar, full LMS access, and 370+ production Claude Code skills.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.