Scikit-LLM muestra cómo integrar el resumen de texto en un flujo de ML con scikit-learn
Scikit-LLM ha mostrado cómo integrar el resumen automático directamente en un pipeline habitual de scikit-learn. En el ejemplo, las reseñas largas se comprimen primero con el modelo gratuito DistilBART de Hugging Face y después pasan por TF-IDF y LogisticRegression. El enfoque reduce el volumen de texto, simplifica la preparación de características y mantiene todo el proceso, desde el texto sin procesar hasta la clasificación, dentro de un único flujo reproducible.
Procesado por IA desde Machine Learning Mastery; editado por Hamidun News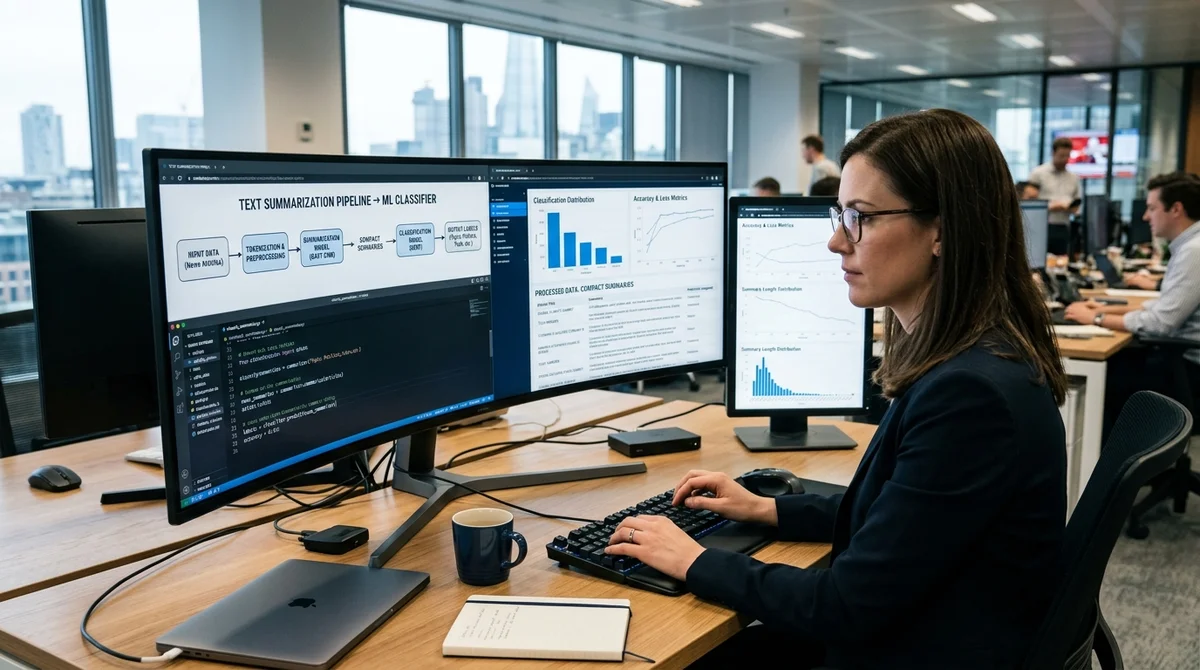
Scikit-LLM ha mostrado una forma práctica de integrar el resumen de texto directamente en un flujo clásico de ML con scikit-learn. La idea es sencilla: un LLM comprime primero los documentos largos en resúmenes breves, que luego se convierten en características numéricas y se envían a un clasificador. Así se pueden manejar textos extensos sin una etapa manual de preprocesamiento aparte, y todo el pipeline queda unificado, del texto en bruto a la predicción final.
En el análisis, el autor usa Scikit-LLM como nexo entre las herramientas tradicionales de aprendizaje automático y los modelos de lenguaje modernos. Por defecto, la biblioteca se apoya en modelos de OpenAI, pero el ejemplo elige una opción gratuita a través de Hugging Face: el modelo sshleifer/distilbart-cnn-12-6. Para ello se instala además la biblioteca transformers en la versión 4.37.2. La elección importa: el resumen puede invocarse muchas veces y el coste de inferencia se nota rápido si se ejecuta en API comerciales.
El elemento clave del ejemplo es una clase propia, HuggingFaceSummarizer, compatible con scikit-learn. Hereda de BaseEstimator y TransformerMixin, de modo que puede insertarse en un Pipeline normal como cualquier otro transformador. En el método fit, la clase carga en memoria un modelo preentrenado; en transform recibe una lista de textos, ejecuta el pipeline de resumen y devuelve los resúmenes breves ya listos. También se tiene en cuenta el hardware: si hay GPU disponible, el modelo se ejecuta en ella; si no, usa la CPU.
Ese resumen se convierte después en el primer paso del pipeline de ML. Le sigue TfidfVectorizer, que transforma los textos reducidos en características numéricas, y luego LogisticRegression se entrena con esas representaciones. La demostración usa solo dos ejemplos: una reseña positiva de una aspiradora y una reseña negativa de una mochila, con retraso en la entrega y una cremallera defectuosa. Para un modelo real, desde luego, no basta, pero lo importante aquí es otra cosa: demostrar que un texto largo y no estructurado puede condensarse automáticamente y alimentar directamente un esquema estándar de clasificación.
También resulta útil que todo el proceso se lance con una llamada normal a fit. En ese paso el pipeline descarga el modelo, resume los textos largos, vectoriza las versiones reducidas y después entrena el clasificador. El autor muestra además los propios resúmenes intermedios: la reseña positiva conserva la idea de que el aparato es bueno en general, aunque algo pesado y no muy claro de configurar; la negativa mantiene las quejas por el retraso en la entrega, la cremallera que se atasca y la tela barata. Incluso un modelo compacto sabe extraer la señal principal, que luego puede usarse en ML convencional.
Como cabía esperar, el resultado de un enfoque tan minimalista es de compromiso. El autor señala sin rodeos que la calidad de los resúmenes es claramente inferior a la que se obtiene con ChatGPT o Google Gemini. El modelo DistilBART, ligero y gratuito, extrae las ideas principales, pero con menos finura y de forma más tosca. Aun así, el ejemplo ilustra bien la arquitectura: el resumen deja de ser una herramienta externa y pasa a formar parte integrada del proceso de entrenamiento. Es especialmente útil en tareas con muchos documentos largos y un modelo posterior sensible a la dimensionalidad y al ruido del texto.
El valor práctico de este esquema es que el desarrollador obtiene un único pipeline reproducible para preparar los textos y entrenar el modelo. En lugar de varios scripts dispersos, hay un solo flujo que se puede entrenar, probar y llevar a producción con las reglas estándar de scikit-learn. Si se sustituye el modelo ligero por uno más potente, la calidad del resumen subirá y, con ella, puede subir la de la clasificación.
Scikit-LLM actúa aquí como puente entre la pila habitual de aprendizaje automático y los enfoques con LLM, un puente que se puede adoptar sin rehacer la infraestructura. Resulta especialmente interesante para equipos que ya trabajan en el ecosistema scikit-learn y quieren añadir funciones de LLM de forma puntual, sin reescribir por completo los pipelines, la infraestructura de entrenamiento ni los procedimientos de validación.
- 2 nov 2026El asistente Muse de Meta mantiene dosieres de las personas cercanas y obtiene root en Ubuntu por defecto
- 1 nov 2026Los modelos locales pierden ante Opus y Codex: 0,21 puntos en un MacBook frente a 1,00 de Codex
- 1 nov 2026Kimi logra un 96,2 % en un test de analítica sobre una base de 1C y se perfila como plan B ante un bloqueo de Claude
- 1 nov 2026OpenAI reescribe las reglas de comportamiento de GPT: cinco valores y una cadena de prioridades
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.