AWS muestra cómo sincronizar automáticamente las bases de conocimiento de Amazon Bedrock desde S3
AWS ha descrito una solución serverless que sincroniza automáticamente los documentos de S3 con Amazon Bedrock Knowledge Bases. El sistema capta los eventos del almacenamiento, encola las tareas mediante SQS y lanza los ingestion jobs solo dentro de las cuotas del servicio. El resultado es una base de conocimiento que se actualiza casi en tiempo real, sin supervisión manual ni carga innecesaria sobre la API.
Procesado por IA desde AWS Machine Learning Blog; editado por Hamidun News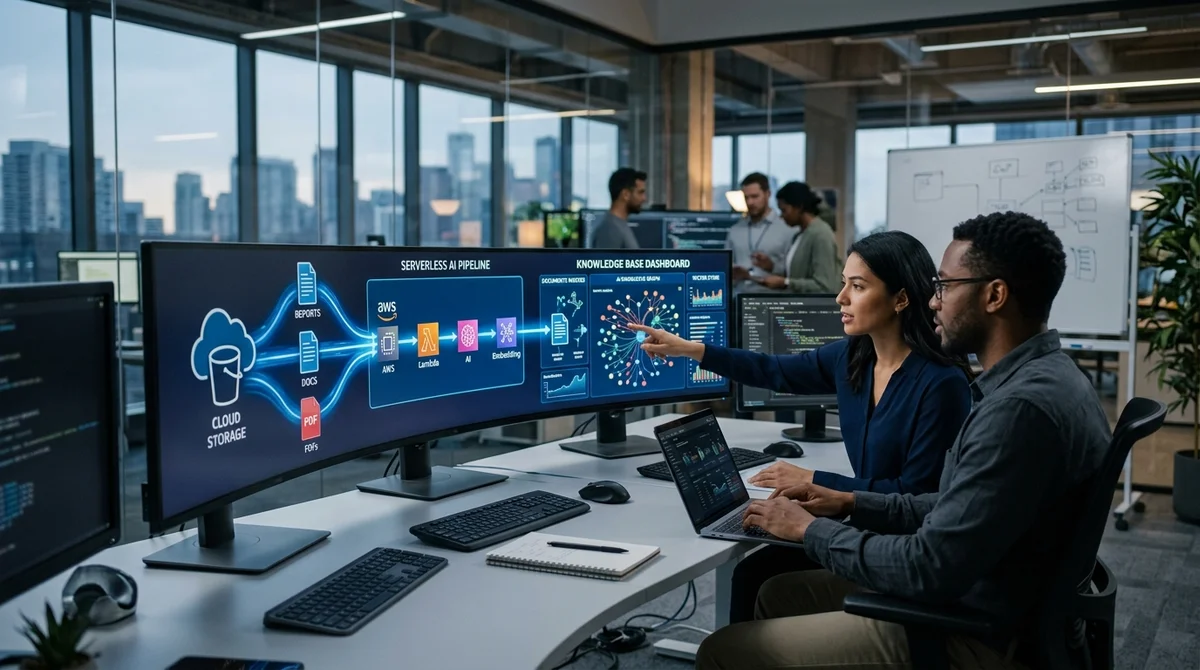
AWS ha propuesto un método práctico para actualizar automáticamente las bases de conocimiento de Amazon Bedrock sin tener que lanzar a mano una tarea de ingesta (ingestion job) tras cada cambio en el almacenamiento. La idea consiste en conectar los eventos de Amazon S3 con un pipeline serverless que detecta por sí solo los archivos nuevos o modificados, inicia la sincronización y, al mismo tiempo, no supera los límites de Bedrock. Para los equipos que construyen servicios RAG sobre documentación corporativa, esto elimina uno de los problemas operativos más habituales: la base de conocimiento deja de ir por detrás de los datos de origen y se actualiza de forma predecible, no según un calendario ni mediante una orden manual.
Las Knowledge Bases de Amazon Bedrock sirven para conectar los modelos generativos con los datos internos de una empresa: manuales, artículos, PDF, tablas y otra documentación. Pero el modelo no se entera por sí mismo de que hay archivos nuevos: una vez cargados los datos en S3, todavía hay que reindexarlos mediante un ingestion job. Si esto se hace a mano, el proceso se rompe enseguida a escala: los documentos llegan en momentos distintos, las actualizaciones son irregulares y el equipo acaba repartiendo su tiempo entre la consola de AWS, los scripts y las colas de sincronización.
La solución que describe AWS se basa en una arquitectura orientada a eventos. Cuando aparece un archivo nuevo en S3, se modifica un objeto existente o se produce otro evento relevante, el sistema lo registra y lanza un ingestion job para la base de conocimiento correspondiente. El enfoque serverless es importante aquí por dos motivos.
En primer lugar, no hace falta mantener un servicio independiente funcionando de forma permanente solo para comprobar cambios. En segundo lugar, la lógica escala con facilidad ante un flujo de actualizaciones impredecible: cuando hay pocos eventos, la infraestructura apenas consume recursos, y cuando aumentan, el pipeline sigue funcionando de forma automática. El énfasis principal no está solo en el lanzamiento automático, sino en respetar las cuotas de servicio de Amazon Bedrock.
Es un detalle importante, porque un esquema ingenuo en el que cada evento lanza de inmediato una tarea independiente puede chocar rápidamente con los límites de la API, sobre todo si se suben cientos de archivos a la vez al bucket o se actualiza de forma masiva un archivo de documentos. Por eso, la sincronización debe saber dosificar la carga, no crear ingestion jobs innecesarios y no convertir una automatización útil en una fuente de errores y llamadas repetidas. Otro punto a favor de la solución es una monitorización completa: al equipo le resulta más fácil ver qué tareas se han lanzado, dónde se han producido retrasos y si se están quedando cambios en los datos sin procesar.
Para los equipos de producto e ingeniería, esto no es un simple detalle de infraestructura. En los sistemas basados en RAG, la calidad de la respuesta depende directamente de lo actualizado que esté el contexto que recibe el modelo. Si la base de conocimiento se actualiza con retraso, el usuario puede encontrarse con precios desactualizados, normativas antiguas, descripciones de procesos obsoletas o documentos que faltan.
La sincronización automática reduce esa brecha entre la fuente de datos y la respuesta del modelo. Además, simplifica la operación: en lugar de lanzar actualizaciones a mano tras cada carga de datos, el equipo dispone de un proceso reproducible, con una lógica clara, control de la carga y observabilidad. También es significativo que AWS apueste precisamente por un esquema serverless y orientado a eventos, y no por una integración pesada con procesamiento continuo en segundo plano.
Para muchas empresas, es la vía más cómoda para implantar búsqueda generativa sobre almacenamiento ya existente en S3: los datos permanecen en su entorno habitual y la actualización del índice pasa a ser una reacción a un evento. Este enfoque resulta especialmente útil allí donde los documentos cambian con frecuencia: soporte, bases de conocimiento internas, analítica, cumplimiento normativo y documentación de producto. La conclusión principal es sencilla: a medida que Bedrock se utiliza cada vez más como base para asistentes corporativos y búsqueda en documentos, la sincronización manual de datos se convierte en el eslabón débil.
En la práctica, AWS ofrece una plantilla para automatizar este proceso sin perder el control sobre las cuotas ni sobre el estado del pipeline. Para las empresas, esto se traduce en respuestas más actualizadas de los modelos, menos rutina manual y un funcionamiento más predecible de la base de conocimiento en producción.
- 2 nov 2026Los steering vectors mejoran el SFT y la destilación de LLM con tres seeds
- 2 nov 2026Anthropic debe aumentar sus ingresos un 32% al año para cubrir contratos por $850 mil millones
- 2 nov 2026Un periodista de The Verge construye con Claude Code un equivalente del Meta Muse Charm por 50 dólares
- 31 oct 2026Worldwide Express encargó las facturas en disputa a agentes de IA y redujo su deuda un 75%
Ship AI Faster with Founders, Engineers & Weekly Architecture Reviews
Inside Vibe Club (hamidun.com/club) — weekly live masterminds with Zhemal Khamidun, Tech Radar, full LMS access, and 370+ production Claude Code skills.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.