El fin de la IA cara: Google y NVIDIA desploman el coste de la inferencia
El gran problema de la inteligencia artificial nunca ha sido solo el coste de entrenar los modelos, sino el de ejecutarlos a diario. En Google Cloud Next, Google y NVIDIA presentaron una solución conjunta que puede cambiar de raíz la economía de la computación en la nube. Las nuevas instancias A5X, basadas en los sistemas monolíticos en rack NVIDIA Vera Rubin NVL72, prometen reducir diez veces el coste de la inferencia de IA. Según las compañías, esa cifra se logra gracias a una integración inusualmente profunda entre hardware y software. Un abaratamiento de la computación de esta escala hará inevitablemente que la IA multimodal avanzada llegue a los servicios de consumo masivo.
Procesado por IA desde AI News; editado por Hamidun News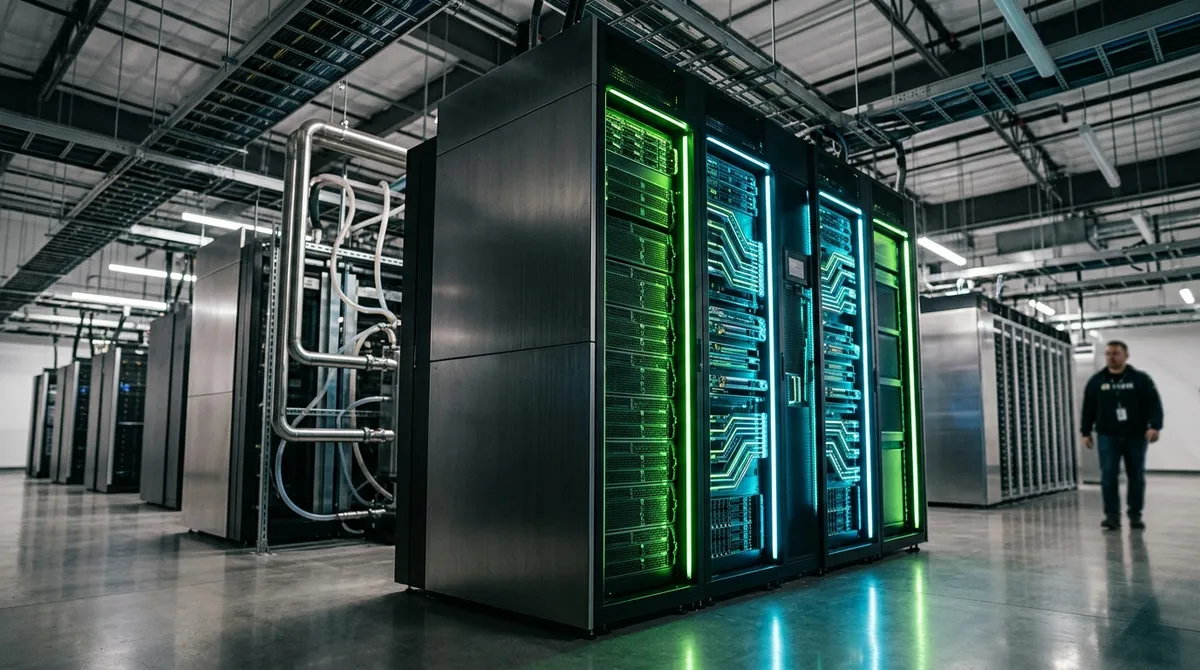
La industria de la inteligencia artificial lleva mucho tiempo como rehén de su propia ambición, ocultando problemas económicos de fondo tras lanzamientos estruendosos. La atención del público se centra tradicionalmente en los enormes costes del entrenamiento inicial de nuevos modelos de lenguaje, pero el verdadero agujero negro financiero está en su explotación diaria. Generar respuestas para millones de consultas de usuarios al día, lo que en el sector se conoce como inferencia, exige el funcionamiento continuo de clústeres enormes y extremadamente voraces en energía.
Ese factor ha hecho hasta ahora que desplegar a gran escala una IA multimodal realmente puntera no fuera económicamente viable para la gran mayoría de las empresas. En la reciente conferencia Google Cloud Next, los gigantes tecnológicos Google y NVIDIA anunciaron el final de esta era de escasez de infraestructura con una nueva arquitectura conjunta que promete reducir el coste de la inferencia diez veces.
La base de este avance son las nuevas instancias de cómputo A5X, ofrecidas sobre «hardware desnudo» (bare metal). Renunciar a la virtualización clásica elimina la pérdida de rendimiento en capas intermedias de software y entrega toda la potencia de cálculo directamente a los algoritmos. Las instancias se apoyan en la arquitectura NVIDIA Vera Rubin, el esperado cambio de generación que releva a Blackwell.
El elemento clave de la nueva infraestructura son los sistemas en rack NVL72. En el enfoque modular tradicional, las GPU se agrupan en servidores estándar, con cuellos de botella inevitables en la transferencia de datos. NVL72, en cambio, es un sistema de cómputo monolítico del tamaño de un armario entero.
Dentro de este rack, setenta y dos GPU de nueva generación funcionan como un único supercomputador gigante, unidas por interconexiones ópticas ultrarrápidas.
Este enfoque radical en la disposición de los servidores ataca el principal problema de la inferencia actual: el ancho de banda de la memoria. Ahora incluso los modelos de lenguaje más grandes, con cientos de miles de millones de parámetros, pueden cargarse completos en la memoria compartida del sistema. Así se evita que el clúster mueva constantemente bloques de datos entre nodos, un proceso lento y costoso en energía.
La reducción de diez veces en el coste de generar tokens, según lo declarado, no se debe solo a la potencia bruta de silicio de los chips Rubin, sino también a un nivel sin precedentes de codiseño de hardware y software. Llama la atención que Google, que tiene sus propios y potentes procesadores tensoriales TPU, haya optado por una integración tan profunda con NVIDIA, reconociendo que hace falta un enfoque híbrido para atender la enorme demanda de los desarrolladores.
Los ingenieros de ambas compañías reescribieron prácticamente la pila básica de gestión del cómputo y la optimizaron para las necesidades específicas de la generación de contenido a gran escala. Los nuevos algoritmos de reparto de carga a nivel de software tienen en cuenta ahora la topología física del rack Vera Rubin y minimizan la latencia de señal a escala de microsegundos. A la vez, el uso de refrigeración líquida avanzada y de nuevos controladores de potencia inteligentes ha permitido reducir drásticamente el consumo eléctrico por cada megabyte de datos generado. Para los centros de datos actuales, donde la factura eléctrica suele superar el coste de los propios servidores, es un factor crítico de rentabilidad.
Las consecuencias de este anuncio de infraestructura para el mercado tecnológico son difíciles de exagerar, porque rompe una barrera fundamental en la economía unitaria de los servicios basados en inteligencia artificial. Hasta ahora, tanto los desarrolladores independientes como las grandes corporaciones tenían que hacer concesiones constantes. Debían limitar artificialmente la funcionalidad de sus productos con modelos menos capaces pero más baratos, o imponer límites estrictos al número de consultas para no arruinarse con las facturas de la nube. Una reducción de diez veces en los costes significa que modelos de negocio que ayer parecían pura ciencia ficción por el coste desorbitado del cómputo hoy pasan a ser plenamente rentables.
En un futuro cercano, el abaratamiento de la inferencia traerá una revolución discreta pero enorme en la experiencia de usuario. El análisis de vídeo complejo en tiempo real, la generación personalizada de mundos 3D sobre la marcha en videojuegos y los agentes de IA inteligentes que trabajan en segundo plano las 24 horas analizando todo el flujo de información entrante podrían convertirse en un estándar masivo y no en un servicio premium caro. Para los proveedores de nube, la alianza entre Google y NVIDIA fija un listón de eficiencia intimidante.
Los enfoques tradicionales para construir centros de datos quedan obsoletos a gran velocidad y dan paso a soluciones hiperoptimizadas a escala de rack completo. Esta colaboración marca un cambio de rumbo importante: la industria pasa por fin de la carrera por crear la IA más inteligente a una carrera pragmática por entregarla a cada usuario del planeta de la forma más barata, rápida y eficiente.
- 2 nov 2026El creador de Bun migra 750 mil líneas de Zig a Rust en 11 días con Claude Code
- 2 nov 2026Un periodista de The Verge construye con Claude Code un equivalente del Meta Muse Charm por 50 dólares
- 1 nov 2026Prueba de 16 modelos en 7 buscadores: Exa obtuvo una media de 10,5 puntos de 14; SearXNG, en torno a 3
- 1 nov 2026StreamVibe, el agente de vídeo de Google, supera en un 10,7 % a otros modelos en momento y calidad de respuesta
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.