OpenAI presenta su primer modelo de IA basado en chips de Cerebras
OpenAI ha presentado oficialmente GPT-5.3-Codex-Spark, su primer modelo que funciona con hardware de la startup Cerebras Systems. Es una versión optimizada y más rápida de Codex, el sistema de la compañía para automatizar la escritura de código. El lanzamiento marca el inicio de la diversificación del hardware de OpenAI para esquivar el dominio de Nvidia. El modelo busca reforzar la posición de la empresa frente a Google y Anthropic en asistentes de IA para desarrolladores, con alta velocidad sin perder precisión en la generación de código.
Procesado por IA desde 36Kr (36氪); editado por Hamidun News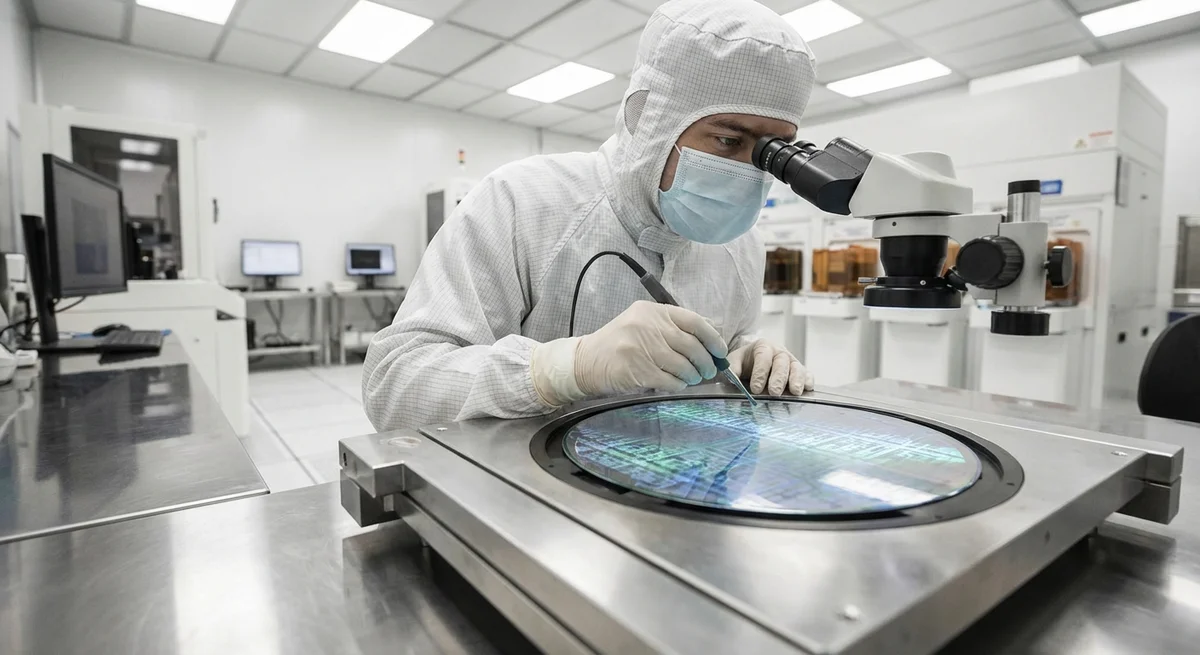
OpenAI ha dado un paso estratégico hacia la independencia tecnológica: la compañía ha presentado GPT-5.3-Codex-Spark, el primer modelo de inteligencia artificial diseñado específicamente para funcionar con chips de Cerebras Systems. No es solo un producto nuevo, sino una muestra de que OpenAI está dispuesta a diversificar sus alianzas de hardware y reducir su dependencia de Nvidia, que domina el mercado de aceleradores de IA.
Codex-Spark se presenta como una versión optimizada de la conocida herramienta Codex para automatizar la escritura de código: por un lado, más ligera de operar; por otro, bastante más rápida al ejecutar tareas. El lanzamiento coincide con una competencia cada vez más intensa entre los asistentes de IA para desarrolladores, donde OpenAI se enfrenta a Google Gemini y a Claude, de Anthropic.
La decisión responde a las crecientes limitaciones sistémicas con las que se ha topado OpenAI. La compañía compra GPU de Nvidia a escala global, pero eso crea una vulnerabilidad: en cualquier momento se podrían restringir los suministros, los precios podrían subir y Nvidia podría imponer sus propias condiciones. Cerebras Systems ofrece una alternativa con su propia arquitectura WSE (Wafer Scale Engine), un chip diseñado de otra forma que logra un equilibrio distinto entre ancho de banda y eficiencia energética. Para OpenAI es una necesidad estratégica: ampliar las fuentes de capacidad de cómputo supone una posición de mercado más sólida y menos expuesta a factores externos.
GPT-5.3-Codex-Spark no es un modelo completamente nuevo, sino una versión optimizada de Codex, adaptada específicamente a las particularidades de los chips de Cerebras. Es una decisión técnica importante: cada arquitectura exige enfoques distintos para la distribución de la memoria, la paralelización del cálculo y el almacenamiento en caché de datos. Los ingenieros de OpenAI rediseñaron la estructura del modelo para aprovechar al máximo la topología concreta de Cerebras. El resultado es una aceleración notable sin pérdida de precisión en la generación de código. Para los desarrolladores supone un ciclo de retroalimentación más rápido: las solicitudes de autocompletado de código se ejecutarán con una latencia mínima, algo crítico para el ecosistema de los IDE y el desarrollo continuo.
El tamaño y el peso del modelo también influyeron en esta optimización. Codex-Spark se presenta como una versión «ligera», lo que permite cargarlo en memoria más rápido y reduce los requisitos de ancho de banda de red. En un mundo donde cada milisegundo de latencia afecta a la experiencia de usuario, eso importa. Más aún en el contexto de la competencia: Google Gemini y Claude ya ofrecen herramientas integradas para trabajar con código, pero los desarrolladores suelen criticar su velocidad. Codex-Spark podría captar parte de esa audiencia si de verdad es más rápido y mantiene una alta precisión en sus sugerencias.
Este movimiento refleja una tendencia más amplia en la industria: el monopolio de Nvidia en las GPU es insostenible y todos los grandes actores empiezan a buscar alternativas. Apple desarrolló su Neural Engine, Google invirtió en las TPU y Amazon crea Trainium e Inferentia. OpenAI, como desarrolladora de modelos y no fabricante de chips, eligió otro camino: aliarse con Cerebras le permite mantenerse flexible y no depender de un único proveedor.
El lanzamiento de Codex-Spark marca el comienzo de una nueva etapa en la estrategia de OpenAI: no solo crear mejores modelos, sino también hacerlos funcionar sobre hardware diverso. Eso complica la vida a los competidores que aún dependen del hardware estándar y refuerza la posición de OpenAI en herramientas de IA para desarrolladores. La pregunta ahora es hasta qué punto funcionará esta estrategia en la práctica y si Cerebras podrá escalar sus chips con la rapidez suficiente para una demanda creciente.
- 2 nov 2026El asistente Muse de Meta mantiene dosieres de las personas cercanas y obtiene root en Ubuntu por defecto
- 1 nov 2026Los modelos locales pierden ante Opus y Codex: 0,21 puntos en un MacBook frente a 1,00 de Codex
- 1 nov 2026Kimi logra un 96,2 % en un test de analítica sobre una base de 1C y se perfila como plan B ante un bloqueo de Claude
- 1 nov 2026OpenAI reescribe las reglas de comportamiento de GPT: cinco valores y una cadena de prioridades
Build & Ship Production AI Agents Without Boilerplate Code
Start your free 72-hour trial at Hamidun Academy (academy.hamidun.com) — interactive lessons on Claude Code & Cursor, live Tech Radar, and production agent templates.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.