OpenAI presenta GPT-5.3-Codex-Spark, que funciona con chips de Cerebras en lugar de Nvidia
OpenAI ha dado un paso importante hacia la independencia de hardware con GPT-5.3-Codex-Spark. Por primera vez, un producto estrella de la compañía se entrenó y se ejecuta no en GPU de Nvidia, sino en chips Wafer Scale Engine 3 de la startup Cerebras Systems. El WSE-3 es un enorme chip del tamaño de una oblea de silicio completa, con una capacidad de cómputo colosal. La iniciativa busca diversificar las cadenas de suministro de OpenAI y reducir su dependencia de los escasos aceleradores de Nvidia. El cambio a hardware alternativo puede modificar de forma notable la economía del entrenamiento de grandes modelos de lenguaje y acelerar el desarrollo de nuevas arquitecturas.
Procesado por IA desde 3DNews AI; editado por Hamidun News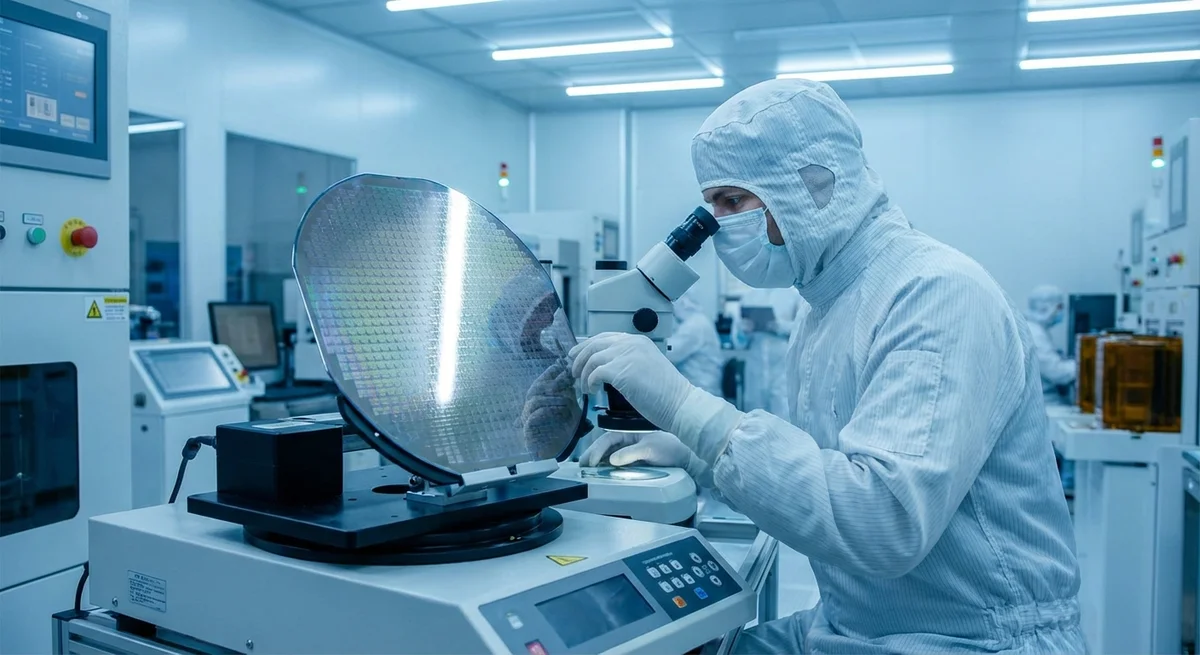
# OpenAI abandona Nvidia. Qué significa para el futuro de la inteligencia artificial
En la historia de los grandes modelos de lenguaje ha ocurrido algo que muchos consideraban imposible. OpenAI ha presentado GPT-5.3-Codex-Spark, el primer modelo estrella de la compañía que se entrenó y desplegó no en procesadores gráficos de Nvidia, sino en chips alternativos Wafer Scale Engine 3 de Cerebras Systems. El paso habla menos de un logro técnico que de un punto de inflexión en la economía de la inteligencia artificial y de la lucha por la independencia de las empresas más poderosas del sector.
Durante los últimos cinco años, Nvidia ha establecido un control casi monopolístico del mercado de aceleradores para entrenar redes neuronales. Cuando quedó claro que las arquitecturas transformer requieren una potencia de cálculo enorme, todos los grandes laboratorios, de OpenAI a Meta* y Google, apostaron por sus GPU. Pero depender de un único proveedor entraña riesgos. Las restricciones a la exportación a China, la escasez de chips y la subida de precios han presionado a las empresas que intentan escalar sus modelos. OpenAI sufrió en silencio como todos, pero ahora ha decidido actuar.
Cerebras Systems propuso un enfoque poco habitual. En lugar de crear miles de procesadores pequeños, la compañía diseñó el WSE-3, un chip de silicio monolítico del tamaño de una oblea completa, que no se puede instalar en un socket convencional. No es solo un chip, sino una minigranja entera en un único trozo de silicio, con más de 900 mil núcleos. Parece que la solución va en contra de los principios de modularidad, pero precisamente eso permitió a Cerebras evitar los cuellos de botella en la transferencia de datos entre procesadores separados, el principal enemigo del entrenamiento paralelo.
Cuando OpenAI probó el entrenamiento de GPT-5.3-Codex-Spark en el WSE-3, los resultados fueron inesperados. La velocidad de convergencia del modelo se mantuvo al nivel del entrenamiento en Nvidia H100, pero hizo falta menos sincronización y movimiento de datos entre aceleradores. Es decir, las horas de inactividad de la red que la empresa perdía antes ahora pueden dedicarse a cálculo útil. Eso significa más barato. Eso significa más rápido.
Pero lo principal no son las cifras técnicas, sino el sentido estratégico. OpenAI ha demostrado que existe una alternativa a Nvidia y que los grandes modelos pueden entrenarse en algo más que sus chips. Es el primer desafío serio al monopolio, y el mercado ya reacciona. Otras compañías, como Intel con su Gaudi, AMD con EPYC y MI300 e incluso Google con sus TPU, saben ahora que hay una ventana de oportunidad. Si OpenAI puede reentrenar un modelo en hardware nuevo y lograr resultados comparables, ellas también pueden.
La economía de la inteligencia artificial cambiará, pero no de inmediato. Cerebras todavía no puede producir WSE-3 en los volúmenes en que Nvidia fabrica H100. Reconstruir la infraestructura y reescribir el código para optimizarlo para la nueva arquitectura llevará tiempo. Aun así, el comienzo está hecho. En los próximos dos o tres años probablemente veremos diseños de aceleradores más extravagantes y una experimentación más activa con chips neuromórficos y ordenadores cuánticos. Nvidia seguirá siendo un actor poderoso, pero ya no el único.
Para los usuarios corrientes de ChatGPT, esto no cambia prácticamente nada: el modelo sigue siendo el mismo y sus capacidades, las mismas. Para la industria, en cambio, la diferencia es enorme. OpenAI ha demostrado que una gran inteligencia puede construirse de otra manera, y que en la carrera por el hardware no mandan quienes llegaron primero, sino quienes piensan más rápido.
*Meta está reconocida como organización extremista y prohibida en Rusia.
- 2 nov 2026El asistente Muse de Meta mantiene dosieres de las personas cercanas y obtiene root en Ubuntu por defecto
- 1 nov 2026Los modelos locales pierden ante Opus y Codex: 0,21 puntos en un MacBook frente a 1,00 de Codex
- 1 nov 2026Kimi logra un 96,2 % en un test de analítica sobre una base de 1C y se perfila como plan B ante un bloqueo de Claude
- 1 nov 2026OpenAI reescribe las reglas de comportamiento de GPT: cinco valores y una cadena de prioridades
Build & Ship Production AI Agents Without Boilerplate Code
Start your free 72-hour trial at Hamidun Academy (academy.hamidun.com) — interactive lessons on Claude Code & Cursor, live Tech Radar, and production agent templates.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.