OpenAI presenta un modelo de programación ultrarrápido que esquiva los chips de Nvidia
OpenAI ha anunciado GPT-5.3-Codex-Spark, un modelo de lenguaje especializado en escribir código que muestra una mejora de rendimiento de 15 veces. El logro clave es una arquitectura optimizada para chips no convencionales del tamaño de un plato. El paso permite a la compañía acelerar de forma notable la generación de código y reducir su dependencia crítica de las escasas GPU de Nvidia. El desarrollo subraya la tendencia a la integración vertical de software y hardware en los mayores laboratorios de IA del mundo.
Procesado por IA desde Ars Technica; editado por Hamidun News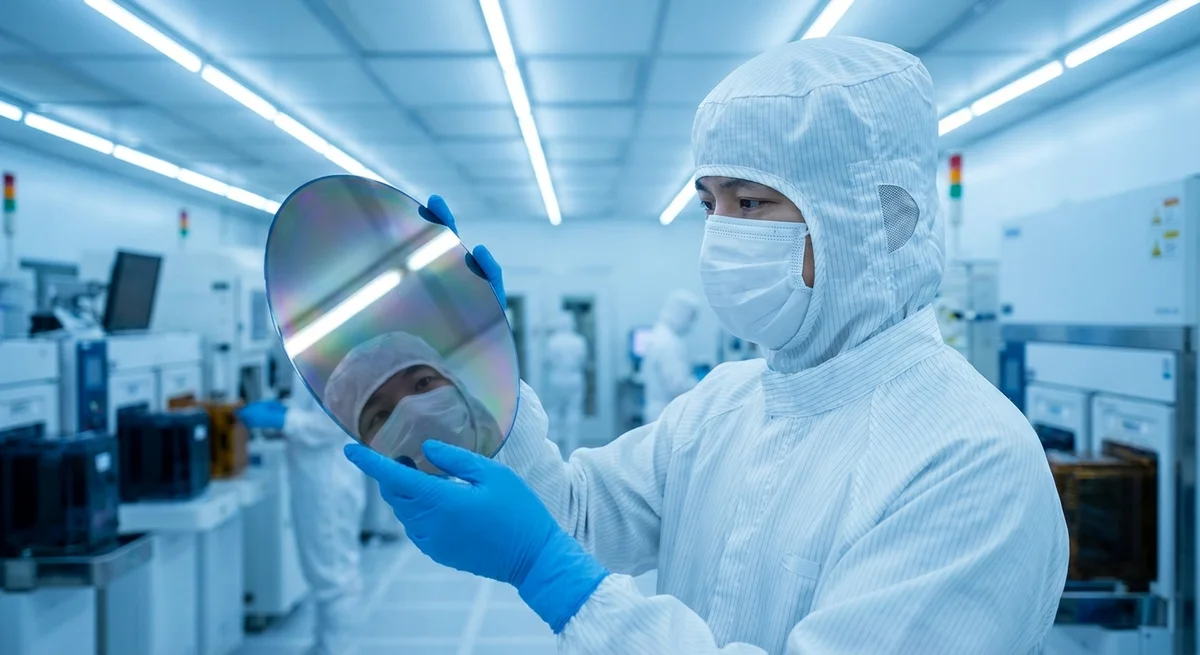
OpenAI ha presentado GPT-5.3-Codex-Spark, un modelo especializado en generación de código que funciona 15 veces más rápido que la versión anterior. Pero la verdadera noticia no es tanto la velocidad como la forma de lograrla: la compañía optimizó la arquitectura para chips no convencionales del tamaño de un plato, sorteando de hecho su dependencia crítica de las escasas GPU de Nvidia. La jugada muestra el deseo de OpenAI de controlar toda la pila, del software al hardware físico, y refleja la creciente rivalidad en el mercado de procesadores especializados para IA.
En los últimos dos años, Nvidia se ha convertido en una especie de cuello de botella para todas las grandes empresas de IA. Las GPU H100 y A100, que se volvieron el estándar para entrenar grandes modelos de lenguaje, tienen una demanda enorme y la oferta no da abasto. Los precios aprietan, los envíos se retrasan y las restricciones geopolíticas lo complican todo. OpenAI, Meta*, Google: todas buscan reducir su dependencia de Nvidia u optimizar los recursos que tienen. La empresa de Elon Musk, x.AI, anunció hace poco un chip propio, Apple hace lo mismo con su Neural Engine y Amazon invierte en los procesadores Trainium e Inferentia. El mercado se fragmenta, y OpenAI ha decidido no quedarse atrás.
GPT-5.3-Codex-Spark es un desarrollo con un objetivo concreto. Mientras que los modelos generalistas como GPT-4o deben resolver muchas tareas, Codex se centra en una: escribir código lo más rápido y con la mayor precisión posible.
Eso permitió a los ingenieros de OpenAI optimizar a fondo. Rediseñaron la arquitectura para las particularidades de la programación, eliminaron capas de cómputo redundantes y reestructuraron las operaciones tensoriales. El resultado es la misma calidad de salida con un coste computacional mucho menor.
Pero el cambio principal se produjo en la capa de hardware. OpenAI desarrolló, o replanteó para sus necesidades, chips no convencionales que trabajan con esta arquitectura de forma nativa. Estos procesadores son más compactos que las GPU estándar, se integran con más facilidad y requieren menos electricidad y refrigeración, todo lo que abarata los centros de datos y los hace más resistentes a los fallos.
La mejora de rendimiento de 15 veces impresiona, pero la cifra necesita contexto. Lo más probable es que no signifique que el modelo realice los cálculos directos 15 veces más rápido. Se refiere al tiempo de generación de código de extremo a extremo, desde la petición del usuario hasta el resultado final. Aquí las mejoras se suman: arquitectura optimizada, chips especializados y un pipeline de procesamiento rediseñado. Es un enfoque típico de la industria de la IA: el algoritmo más eficiente sobre el hardware más eficiente da el mejor resultado.
Para la industria, esto implica varias cosas a la vez. Primero, aumenta la presión sobre Nvidia. Si otras compañías empiezan a usar con éxito sus propios chips, la demanda de GPU podría caer. Segundo, refuerza la tendencia a la integración vertical en los laboratorios de IA. Apple, Google, Meta* y ahora OpenAI desarrollan chips propios. Tercero, es una buena noticia para los desarrolladores: un generador de código más rápido y barato puede reducir el coste de usar las API y hacer más accesibles los asistentes de IA.
Pero OpenAI no se librará por completo de Nvidia. Los modelos generalistas siguen necesitando GPU potentes para el entrenamiento. Los chips propios de OpenAI, al parecer, están optimizados específicamente para inferencia, es decir, para ejecutar modelos ya entrenados. Tiene lógica: el entrenamiento ocurre pocas veces, mientras que las peticiones de los usuarios llegan sin parar. OpenAI ha encontrado la manera de controlar justo la capa en la que se puede ganar dinero a escala. Y es una jugada estratégica acertada.
*Meta ha sido declarada organización extremista y está prohibida en Rusia.
- 2 nov 2026El asistente Muse de Meta mantiene dosieres de las personas cercanas y obtiene root en Ubuntu por defecto
- 1 nov 2026Los modelos locales pierden ante Opus y Codex: 0,21 puntos en un MacBook frente a 1,00 de Codex
- 1 nov 2026Kimi logra un 96,2 % en un test de analítica sobre una base de 1C y se perfila como plan B ante un bloqueo de Claude
- 1 nov 2026OpenAI reescribe las reglas de comportamiento de GPT: cinco valores y una cadena de prioridades
Build & Ship Production AI Agents Without Boilerplate Code
Start your free 72-hour trial at Hamidun Academy (academy.hamidun.com) — interactive lessons on Claude Code & Cursor, live Tech Radar, and production agent templates.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.