Robots atrapados por los datos: por qué los vídeos de volteretas son solo el principio
Los vídeos virales crean la ilusión de un gran avance tecnológico, pero el progreso real se frena por una "crisis de datos". A diferencia de las IA de texto, los robots necesitan datos multidimensionales del mundo físico: visión, tacto y fuerza. China está construyendo centros de recopilación de datos de forma masiva, donde operadores enseñan a mano tareas básicas a las máquinas. Los principales problemas son el alto coste de los datos "en vivo" y la incompatibilidad del equipo de distintos fabricantes. Los expertos comparan esta etapa con los primeros pasos del piloto automático y subrayan que el camino hacia robots asistentes universales será mucho más difícil y caro de lo que parecía al principio.
Procesado por IA desde 36Kr (36氪); editado por Hamidun News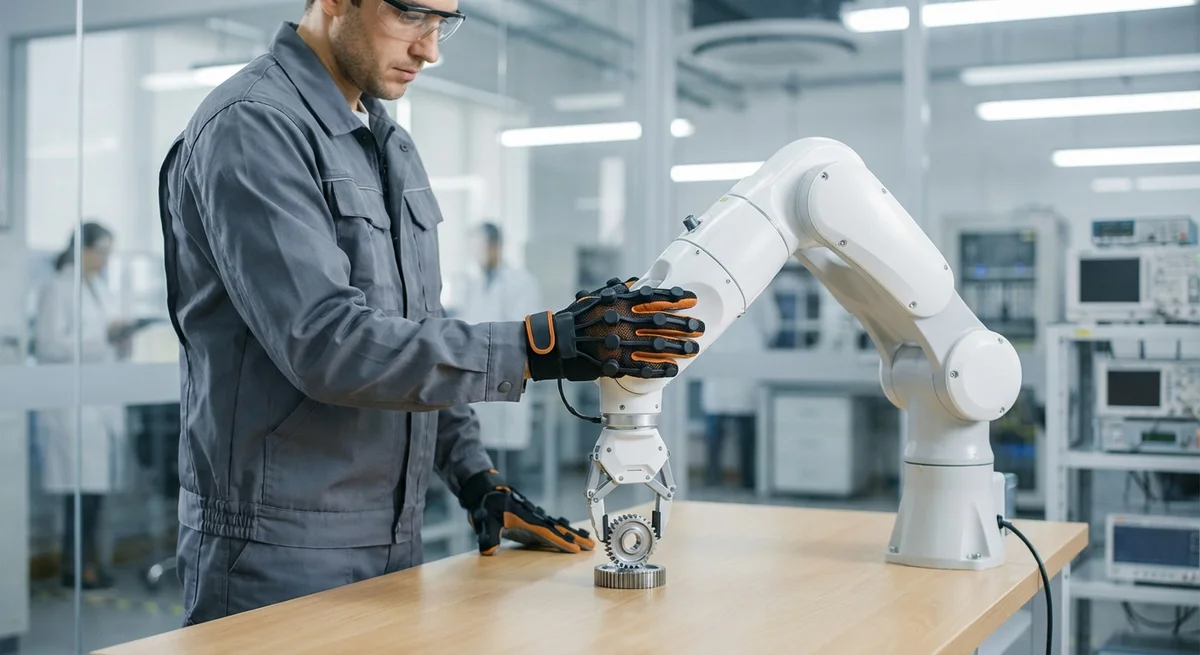
# Robots atrapados por los datos: por qué los vídeos de volteretas son solo el principio
En el último año, internet se ha llenado de vídeos con trucos impresionantes: robots que saltan, bailan, lanzan puñetazos y rompen sandías de una patada. La inversión crece, los medios abundan en titulares optimistas y el público está convencido de que la era de los robots asistentes domésticos está a punto de empezar. Pero si se mira tras las bambalinas de este teatro tecnológico, el panorama resulta mucho más complejo y más triste.
Ahora mismo, en silenciosos centros de preparación de datos por toda China, operadores humanos con guantes manejan manipuladores de forma lenta, casi dolorosa, y enseñan a las máquinas a recoger piezas, guardar herramientas y cerrar tapas de cajas. Esta escena carece de todo el aire cinematográfico de los vídeos virales, pero es lo que determina el progreso real de la robótica. Entre un truco impresionante y un ayudante doméstico útil se interpone un problema fundamental: un déficit catastrófico de datos de calidad.
Los modelos de lenguaje como ChatGPT y DeepSeek se basan en el triunfo de una lógica simple: miles de millones de ejemplos de texto de internet permitieron a la IA entender el lenguaje y empezar a generar contenido con sentido. Pero la robótica se enfrenta a una realidad muy distinta. Los datos de texto viven en un espacio digital bidimensional y se copian y distribuyen con facilidad, mientras que el mundo físico es un flujo de información multidimensional y continuo.
Un robot debe percibir el mundo por muchos canales a la vez: vídeo de varias cámaras, sensores de fuerza, sensores de tacto, información sobre la posición de las articulaciones. Cada operación que realiza un manipulador genera datos estructurados, con 57 dimensiones en algunos sistemas. Y todos estos flujos deben estar sincronizados a la perfección hasta el milisegundo; si no, el modelo aprenderá pura alucinación en lugar de una relación causa-efecto.
China ya cuenta con más de cincuenta centros de recopilación y procesamiento de datos de robótica. Solo en Pekín, uno de estos centros produce unos seis mil registros de ejemplos de entrenamiento al día. Una extrapolación aproximada sugiere que la producción anual podría alcanzar decenas de miles de millones de ejemplos.
Suena impresionante, pero en realidad es una gota en el océano de lo que se necesita. Los expertos de la empresa PowerTech hicieron un cálculo conservador: para que un robot aprenda un movimiento hacen falta aproximadamente entre mil y cinco mil ejemplos. Una tarea sencilla de varios movimientos requiere entre diez mil y veinte mil.
Pero un robot universal capaz de hacer el ochenta por ciento de los trabajos humanos de un sector necesitaría un conjunto de datos de cien millones. Y si la ambición se extiende a miles de sectores, hablamos de billones de ejemplos. El déficit es de cuatro a cinco órdenes de magnitud.
Pero ese no es todavía el problema más grave. La incompatibilidad del equipo resultó mucho más traicionera. Cada fabricante crea robots con configuraciones de sensores, protocolos de control y parámetros físicos distintos. Los datos recopilados con un modelo de manipulador a menudo simplemente no funcionan en otro: el lenguaje de una máquina sigue siendo completamente ajeno a la otra. Esto significa que el conocimiento no se suma ni se acumula en un activo común de la industria. Cada fabricante se ve obligado a construir su propio conjunto de datos desde cero, repitiendo una y otra vez el mismo trabajo costoso.
Algunos centros afrontan este dilema centrándose en los modelos populares, es decir, ignorando de hecho la diversidad. Otros eligen un camino más ambicioso: recopilan datos de robots de distintos fabricantes en un espacio único e intentan que el modelo generalice el conocimiento a equipos heterogéneos. Ningún enfoque ha demostrado aún ser universal.
Todo esto recuerda a los primeros días del piloto automático, una época en la que parecía que el problema estaba en los algoritmos y no en los datos. Han pasado casi veinte años y miles de millones en inversión, y resultó que la verdad estaba cerca, pero no exactamente donde se buscaba. Antes de que los robots entren de verdad en nuestras casas, queda un largo y aburrido trabajo en los centros de datos, donde personas con guantes enseñarán con paciencia a las máquinas a entender el mundo físico. Los vídeos virales son marketing. El progreso real es otra historia muy distinta.
- 2 nov 2026El marco AICG de NC State redujo un 50,3% el MAE al evaluar respuestas matemáticas
- 2 nov 2026Revisamos 929 automatizaciones en Alpina: cómo debería ser la formación corporativa en IA en 2026
- 2 nov 2026Interrogué a 6 redes neuronales sobre mí como lo haría un comprador corporativo: Amazon, esoterismo, «Telo Judelo» y 5 agujeros que cerramos en un día
- 2 nov 2026TJ Digital: el 23% de las páginas que cita la IA empiezan con una respuesta directa, frente al 14% de las que no cita
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.