Los laboratorios de IA pagan a XDOF por recopilar datos de entrenamiento para robots: es un trabajo sucio y rutinario
Para que los robots aprendan a moverse y a manipular objetos hacen falta millones de horas de demostraciones reales, igual que los LLM aprendieron de internet. Recopilar esos datos es monótono y duro: las personas pasan horas manejando robots a mano o moviéndose con trajes de captura de movimiento. Los laboratorios de IA ya pagan a empresas como XDOF para externalizar ese trabajo.
Procesado por IA desde TechCrunch; editado por Hamidun News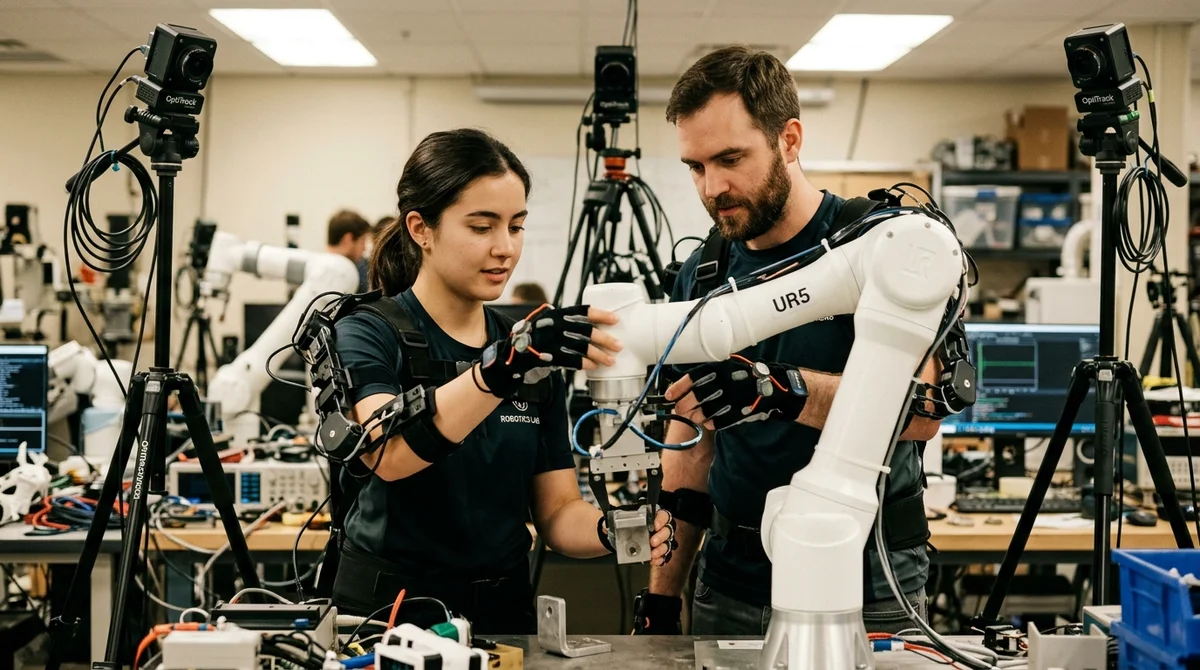
La IA física afronta el mismo problema que habría frenado a los modelos de lenguaje sin el internet que acumuló la humanidad: la escasez de datos de entrenamiento. Por ahora, los laboratorios lo resuelven a mano y pagan dinero real a empresas como XDOF para hacerlo.
Por qué faltan datos
Los grandes modelos de lenguaje aprendieron a razonar con billones de palabras que la humanidad acumuló en la red. Los robots físicos no tienen esa ventaja de partida. Movimientos, agarres, equilibrio, manejo de objetos frágiles: todo hay que demostrarlo en vivo, una y otra vez, en decenas de escenarios distintos. Una sola hora de demostraciones de calidad exige mucho esfuerzo. El operador se pone un exoesqueleto o maneja el robot con un joystick y repite el mismo movimiento cientos de veces con distinta iluminación, con diferentes objetos y en diferentes posturas. Los datos resultantes son caros, lentos de producir y están muy ligados al espacio físico. Internet no sirve de ayuda aquí.
Por eso los principales equipos de IA física, desde Physical Intelligence hasta laboratorios dentro de Google DeepMind y desarrolladores de robots humanoides, se han topado con el mismo muro: los modelos se pueden mejorar todo lo que se quiera, pero sin un volumen suficiente de demostraciones de calidad no aprenderán.
Qué hace XDOF
XDOF es una de las empresas a las que los laboratorios de IA externalizan este trabajo. Organiza todo el proceso: recluta operadores, configura el equipo, vigila la calidad del etiquetado y escala la producción según las necesidades de cada cliente. El modelo recuerda a los primeros tiempos de Scale AI, que contrató a un ejército de anotadores para etiquetar texto e imágenes. La diferencia es que ahora se trata de trabajo físico en un espacio real.
Una sesión típica de recopilación de datos es así:
- El operador controla el robot a mano y el sistema captura las trayectorias de movimiento y los datos de fuerza
- Varias cámaras graban la escena a la vez desde distintos ángulos
- Cada intento se etiqueta: éxito, fallo, caso límite
- El escenario se repite con distinta iluminación, con diferentes objetos y en diferentes posturas
- Una revisión final descarta las demostraciones defectuosas
Este trabajo no exige formación de ingeniero, pero sí atención, paciencia y resistencia física. Es justo ese «trabajo sucio y poco vistoso» del que advierte el sector.
Quién paga y por qué importa
Escalar la recopilación de datos choca con la física: no se pueden descargar de la red millones de movimientos robóticos ni sustituirlos por datos sintéticos sin arriesgar la degradación del modelo. La externalización permite a los laboratorios centrarse en la arquitectura y el entrenamiento mientras los especialistas se ocupan de la rutina.
Al mismo tiempo surge un nuevo tipo de «trabajo oculto» en la industria de la IA: invisible para el gran público, pero de importancia crítica. Como ocurrió con la moderación de contenido para los LLM, el mercado de recopilación de demostraciones robóticas crecerá rápido y con la misma rapidez acabará en el centro del debate sobre condiciones laborales y estándares de calidad.
Qué significa
La era de la IA física exigirá una infraestructura de recopilación de datos equivalente a la que internet aportó a los modelos de lenguaje. Las empresas que sean las primeras en montar canales eficientes de recopilación y etiquetado de demostraciones físicas obtendrán una ventaja estructural, con independencia de quién desarrolle los modelos.
- 1 nov 2026Prueba de 16 modelos en 7 buscadores: Exa obtuvo una media de 10,5 puntos de 14; SearXNG, en torno a 3
- 1 nov 2026StreamVibe, el agente de vídeo de Google, supera en un 10,7 % a otros modelos en momento y calidad de respuesta
- 1 nov 2026OpenAI reescribe las reglas de comportamiento de GPT: cinco valores y una cadena de prioridades
- 1 nov 2026Los bots de voz con LLM recurren al clasificador rápido Jev: decisiones en 200–500 ms
Preguntas frecuentes sobre la noticia
¿Qué se sabe sobre Por qué faltan datos?
Los grandes modelos de lenguaje aprendieron a razonar con billones de palabras que la humanidad acumuló en la red. Los robots físicos no tienen esa ventaja de partida. Movimientos, agarres, equilibrio, manejo de objetos frágiles: todo hay que demostrarlo en vivo, una y otra vez, en decenas de escenarios distintos. Una sola hora de demostraciones de calidad exige mucho esfuerzo. El operador se pone un exoesqueleto o maneja el robot con un joystick y repite el mismo movimiento cientos de veces con distinta iluminación, con diferentes objetos y en diferentes posturas. Los dato
¿Qué se sabe sobre Qué hace XDOF?
XDOF es una de las empresas a las que los laboratorios de IA externalizan este trabajo. Organiza todo el proceso: recluta operadores, configura el equipo, vigila la calidad del etiquetado y escala la producción según las necesidades de cada cliente. El modelo recuerda a los primeros tiempos de Scale AI, que contrató a un ejército de anotadores para etiquetar texto e imágenes. La diferencia es que ahora se trata de trabajo físico en un espacio real. Una sesión típica de recopilación de datos es así: El operador controla el robot a mano y el sistema captura las trayectorias d
¿Qué se sabe sobre Quién paga y por qué importa?
Escalar la recopilación de datos choca con la física: no se pueden descargar de la red millones de movimientos robóticos ni sustituirlos por datos sintéticos sin arriesgar la degradación del modelo. La externalización permite a los laboratorios centrarse en la arquitectura y el entrenamiento mientras los especialistas se ocupan de la rutina. Al mismo tiempo surge un nuevo tipo de «trabajo oculto» en la industria de la IA: invisible para el gran público, pero de importancia crítica. Como ocurrió con la moderación de contenido para los LLM, el mercado de recopilación de demos
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.