Gemini Omni y Gemini 3.5 en acción: 11 vídeos de demostración de Google
En Google I/O 2026, la compañía mostró 11 vídeos de Gemini Omni y Gemini 3.5 en acción. Los nuevos modelos demostraron una mejor comprensión de vídeo, voz y texto. Las demostraciones abarcaron desde el análisis de contenido hasta la generación, y apuntan a un nuevo nivel de capacidad de la IA. Google reafirmó su posición de liderazgo en el desarrollo de redes neuronales multimodales.
Procesado por IA desde Google AI Blog; editado por Hamidun News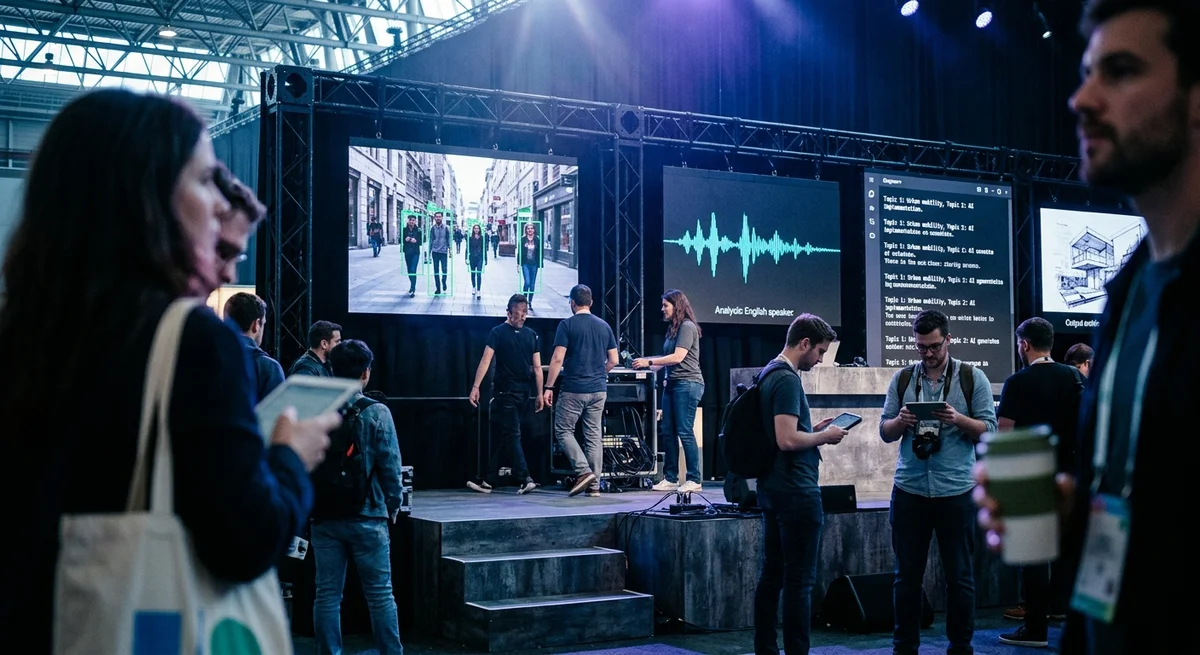
Gemini
Omni y Gemini 3.5: una nueva generación de IA multimodal
En la conferencia Google I/O 2026, la compañía presentó una serie de vídeos de demostración que exhiben la potencia de sus modelos más recientes, Gemini Omni y Gemini 3.5. En total se publicaron 11 vídeos, y cada uno muestra un caso de uso concreto y las capacidades singulares de estos modelos.
Qué mostró exactamente Google
Las demostraciones abarcan un amplio abanico de tareas:
- Análisis de contenido de vídeo con comprensión del contexto
- Procesamiento de comandos de voz e interacción conversacional
- Extracción de información de documentos de texto
- Generación de contenido a partir de los datos proporcionados
- Integración con aplicaciones y servicios reales
Características clave de los nuevos modelos
Gemini Omni es una versión mejorada, optimizada específicamente para trabajar con tipos de datos heterogéneos. El modelo muestra una mejora notable en:
- Precisión al reconocer detalles en vídeo
- Velocidad de procesamiento de las solicitudes
- Calidad de la interpretación del contexto
Gemini 3.5, por su parte, mantiene la practicidad y la accesibilidad con un aumento significativo del rendimiento. Este modelo está pensado para desarrolladores y empresas que necesitan equilibrio entre potencia y eficiencia.
Qué significa para la industria
Las demostraciones de Google subrayan varias tendencias importantes en el desarrollo de la IA:
- La multimodalidad se convierte en el estándar, no en la excepción
- La integración de la IA en las aplicaciones cotidianas se acelera
- Aumentan las exigencias de velocidad y precisión del procesamiento
Los vídeos confirman que Google sigue siendo uno de los principales actores en el desarrollo de redes neuronales de vanguardia. Las demostraciones enseñan aplicaciones prácticas de tecnologías que van más allá de los conceptos teóricos.
Qué viene ahora
La presentación de estos modelos indica que Google está lista para lanzar herramientas de uso más amplio. Desarrolladores y empresas podrán integrar Gemini Omni y Gemini 3.5 en sus propios productos, lo que abrirá nuevas posibilidades para crear aplicaciones de IA.
- 1 nov 2026StreamVibe, el agente de vídeo de Google, supera en un 10,7 % a otros modelos en momento y calidad de respuesta
- 1 nov 2026OpenAI reescribe las reglas de comportamiento de GPT: cinco valores y una cadena de prioridades
- 1 nov 2026Los bots de voz con LLM recurren al clasificador rápido Jev: decisiones en 200–500 ms
- 1 nov 2026Google admite que AI Mode reduce los ingresos de su buscador: las acciones caen un 15%
Preguntas frecuentes sobre la noticia
¿Qué se sabe sobre Gemini Omni y Gemini 3.5: una nueva generación de IA multimodal?
En la conferencia Google I/O 2026, la compañía presentó una serie de vídeos de demostración que exhiben la potencia de sus modelos más recientes, Gemini Omni y Gemini 3.5. En total se publicaron 11 vídeos, y cada uno muestra un caso de uso concreto y las capacidades singulares de estos modelos.
¿Qué se sabe sobre Qué mostró exactamente Google?
Las demostraciones abarcan un amplio abanico de tareas: Análisis de contenido de vídeo con comprensión del contexto Procesamiento de comandos de voz e interacción conversacional Extracción de información de documentos de texto Generación de contenido a partir de los datos proporcionados Integración con aplicaciones y servicios reales
¿Qué se sabe sobre Características clave de los nuevos modelos?
Gemini Omni es una versión mejorada, optimizada específicamente para trabajar con tipos de datos heterogéneos. El modelo muestra una mejora notable en: Precisión al reconocer detalles en vídeo Velocidad de procesamiento de las solicitudes Calidad de la interpretación del contexto Gemini 3.5, por su parte, mantiene la practicidad y la accesibilidad con un aumento significativo del rendimiento. Este modelo está pensado para desarrolladores y empresas que necesitan equilibrio entre potencia y eficiencia.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.