AWS SageMaker incorpora monitorización completa de LLM en producción
AWS ha integrado la monitorización completa de LLM en SageMaker AI. Los nuevos paneles de Grafana siguen el uso de GPU, la velocidad de procesamiento de tokens y la calidad de las respuestas. La función está pensada para producción con modelos populares como Llama, Mistral y Claude.
Procesado por IA desde AWS Machine Learning Blog; editado por Hamidun News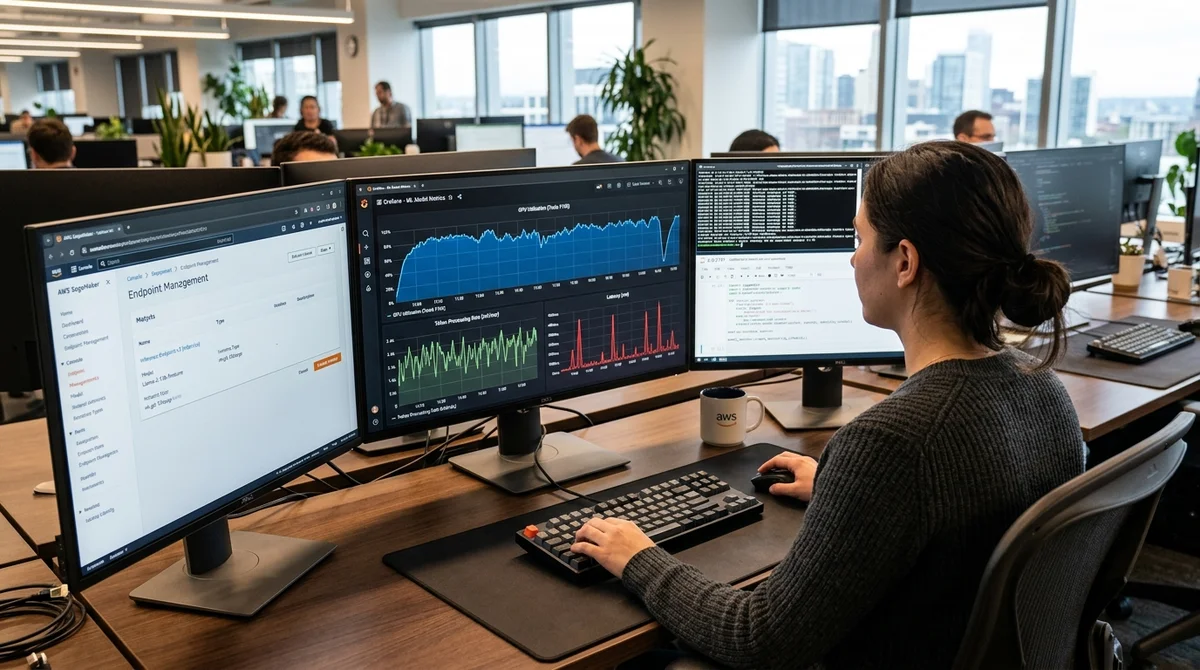
AWS ha añadido monitorización integral para los LLM que se ejecutan en la plataforma SageMaker AI. Con Amazon Managed Grafana, ahora es posible observar tanto métricas técnicas (uso de GPU, latencia) como indicadores de calidad (precisión de las respuestas, alucinaciones).
Qué se monitoriza
AWS distingue dos categorías de métricas. La primera son los recursos: utilización de las tarjetas gráficas, uso de memoria y número de tokens procesados por segundo. La segunda es la calidad del modelo: latencia de respuesta, precisión de la generación, presencia de alucinaciones y cumplimiento de las instrucciones originales.
Los nuevos paneles recopilan automáticamente datos de los endpoints de SageMaker y los muestran en tiempo real. Esto es importante: en producción no basta con ver que «el servidor funciona»; hay que saber también que «el modelo responde correctamente».
Las métricas integradas incluyen:
- Utilización de GPU y uso de memoria
- Velocidad de procesamiento de tokens de entrada y salida
- Latencia (el retraso entre la solicitud y la respuesta del modelo)
- Toxicidad y alucinaciones en la salida
- Cumplimiento de instrucciones y métricas de compliance
Por qué importa
Un LLM en producción no es simplemente hardware encendido y en marcha. El modelo puede cargarse y el procesador puede estar activo, pero la calidad de las respuestas puede ser baja. El modelo puede dar respuestas erróneas, ser lento o aprender un comportamiento indeseado.
Antes, los ingenieros tenían que integrar manualmente el registro en Prometheus, ELK u otros sistemas de monitorización. Eso exigía tiempo y un conocimiento profundo de las métricas. Ahora la herramienta está integrada directamente en SageMaker.
AWS ofrece plantillas de paneles listas para modelos populares: Llama, Mistral, Claude y otros. Un ingeniero puede desplegar la monitorización en unos pocos clics, sin escribir código personalizado.
Cuándo resulta útil
La monitorización completa es crítica cuando un LLM atiende a usuarios reales o respalda procesos de negocio importantes. Algunos ejemplos: un chatbot de atención al cliente, un asistente de IA para analizar documentos, un generador automático de contenido o un asistente de búsqueda en una base de conocimiento.
Si el modelo empieza a dar respuestas más largas, extrañas o menos útiles, las métricas lo muestran antes de que lleguen las quejas de los usuarios. Una caída inesperada de la utilización de GPU puede indicar problemas en la cola de solicitudes o el agotamiento de la memoria.
AWS subraya que la observabilidad no es una solución temporal, sino el
cimiento para un despliegue fiable de LLM en producción.
Qué significa
Monitorizar los LLM se está convirtiendo poco a poco en un estándar, igual que con las aplicaciones web convencionales. AWS lo hace más accesible al integrar herramientas de observabilidad ya preparadas directamente en la plataforma SageMaker.
Para los equipos de ingeniería, esto supone menos tiempo escribiendo scripts de integración a medida y más atención a la calidad de los propios LLM. Eso acelerará el despliegue de soluciones de IA en producción.
- 31 oct 2026Worldwide Express encargó las facturas en disputa a agentes de IA y redujo su deuda un 75%
- 30 oct 2026AWS ofrece a los agentes de código una vista previa en vivo del sitio desde la sesión aislada
- 30 oct 2026MoEngage abre 400 API cerradas a agentes de IA con AgentCore Gateway, sin servidores MCP propios
- 29 oct 2026NVIDIA Nemotron 3.5 Super VL: 120 mil millones de parámetros, 12 mil millones activos, despliegue en AWS
Preguntas frecuentes sobre la noticia
¿Qué se sabe sobre Qué se monitoriza?
AWS distingue dos categorías de métricas. La primera son los recursos: utilización de las tarjetas gráficas, uso de memoria y número de tokens procesados por segundo. La segunda es la calidad del modelo: latencia de respuesta, precisión de la generación, presencia de alucinaciones y cumplimiento de las instrucciones originales. Los nuevos paneles recopilan automáticamente datos de los endpoints de SageMaker y los muestran en tiempo real. Esto es importante: en producción no basta con ver que «el servidor funciona»; hay que saber también que «el modelo responde correctamente
¿Qué se sabe sobre Por qué importa?
Un LLM en producción no es simplemente hardware encendido y en marcha. El modelo puede cargarse y el procesador puede estar activo, pero la calidad de las respuestas puede ser baja. El modelo puede dar respuestas erróneas, ser lento o aprender un comportamiento indeseado. Antes, los ingenieros tenían que integrar manualmente el registro en Prometheus, ELK u otros sistemas de monitorización. Eso exigía tiempo y un conocimiento profundo de las métricas. Ahora la herramienta está integrada directamente en SageMaker. AWS ofrece plantillas de paneles listas para modelos populare
Cuándo resulta útil?
La monitorización completa es crítica cuando un LLM atiende a usuarios reales o respalda procesos de negocio importantes. Algunos ejemplos: un chatbot de atención al cliente, un asistente de IA para analizar documentos, un generador automático de contenido o un asistente de búsqueda en una base de conocimiento. Si el modelo empieza a dar respuestas más largas, extrañas o menos útiles, las métricas lo muestran antes de que lleguen las quejas de los usuarios. Una caída inesperada de la utilización de GPU puede indicar problemas en la cola de solicitudes o el agotamiento de la
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.