Cómo acelerar modelos de PyTorch: guía práctica de torch.profiler
Hugging Face ha publicado la primera parte de su guía de torch.profiler, la herramienta de análisis de rendimiento integrada en PyTorch. Registra cada operación en la GPU y la CPU, detecta cuellos de botella en los cálculos y ayuda a reducir el tiempo de entrenamiento de los modelos. La guía resulta útil para ingenieros de ML e investigadores que quieren saber en qué se va su capacidad de cómputo y acelerar sus proyectos.
Procesado por IA desde Hugging Face Blog; editado por Hamidun News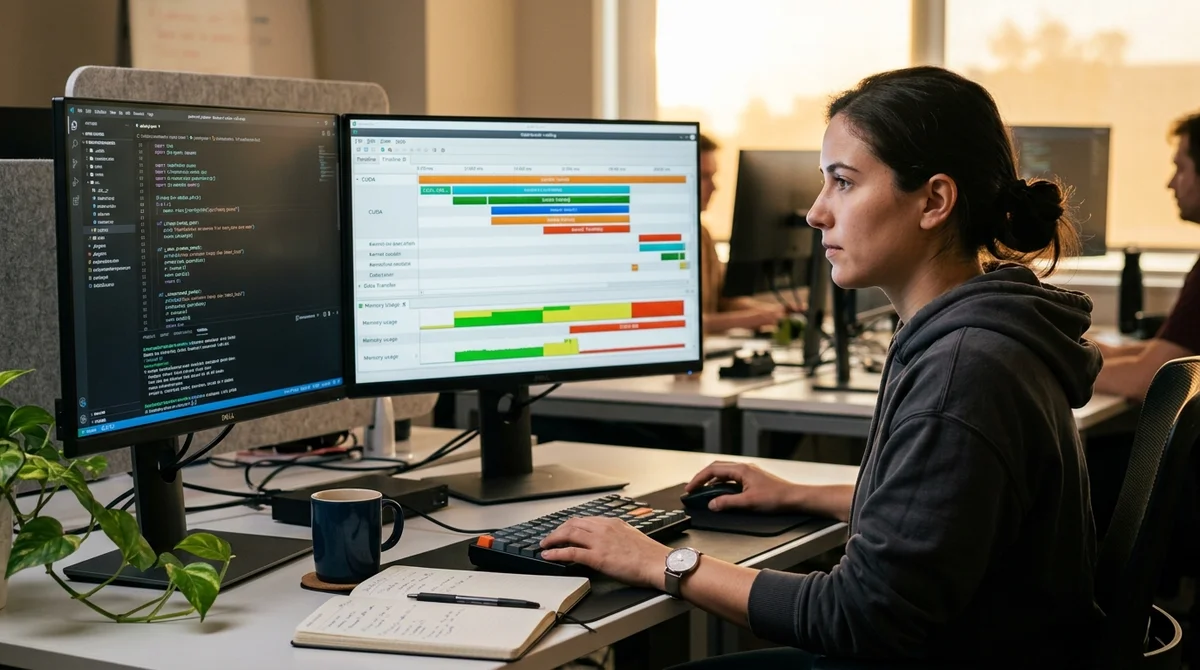
PyTorch incluye una herramienta integrada, torch.profiler, para analizar el rendimiento de los modelos. Registra cada operación en la GPU y la CPU, y ayuda a encontrar cuellos de botella en los cálculos y a optimizar el tiempo de entrenamiento.
Por qué perfilar los modelos
Sin perfilado, el desarrollador solo ve la cifra final: «la época se entrenó durante 2 horas». Pero ¿por qué 2 horas? ¿En qué se fue el tiempo? ¿Quizá el dataloader es lento? ¿O una operación en la GPU es ineficiente? ¿O la GPU está parada esperando datos de la CPU?
Optimizar a ciegas es adivinar. Cambias el batch size, la velocidad de carga, la precisión de los cálculos y el resultado no mejora, porque estás optimizando el cuello de botella equivocado. torch.profiler evita esa pérdida de tiempo: muestra la distribución exacta del tiempo y la memoria por operación.
Cómo funciona torch.profiler
La herramienta traza la ejecución del código a nivel de kernels CUDA e hilos de CPU. Para cada operación, como una multiplicación de matrices en una capa Linear o una convolución en Conv2d, registra el tiempo de inicio, el de fin y la memoria utilizada. Los resultados se pueden exportar a un formato compatible con Chrome DevTools y visualizar como línea de tiempo.
Las métricas principales del profiler:
- Exclusive time: el tiempo que la operación consumió por sí sola (sin las operaciones anidadas)
- Inclusive time: el tiempo de la operación junto con todas las llamadas anidadas
- Memory: uso máximo de memoria de la GPU durante la operación
- Sync time: tiempo dedicado a la sincronización entre CPU y GPU (el cuello de botella número uno)
Cuándo torch.profiler revela problemas
Un escenario típico: un modelo se entrena despacio, crees que necesitas una GPU más rápida, pero el profiler muestra que el 60% del tiempo de la época se va en esperar datos del dataloader. El problema no está en la GPU, sino en la carga de datos. La solución: aumentar num_workers en DataLoader o usar pinned memory.
Otro ejemplo: un modelo se entrena en un sistema distribuido (varias GPU) y el profiler muestra que se pierde mucho tiempo en sincronizar gradientes entre dispositivos. Es una señal para optimizar el grafo de comunicación o replantear la estrategia de paralelismo.
Una aclaración importante: el propio perfilado añade overhead. Si ejecutas el profiler sobre todo el ciclo de entrenamiento, puede ralentizar los cálculos entre un 10 y un 30%. Para mediciones precisas conviene perfilar solo el bloque de código que interesa (por ejemplo, una pasada forward-backward).
Qué significa
torch.profiler es el primer paso antes de cualquier optimización. No adivines dónde está el cuello de botella: perfila, revisa los resultados y optimiza justo lo que frena el proceso. Eso puede ahorrar semanas de experimentos y dirigir el esfuerzo adonde realmente dará resultado. Para los ingenieros de ML que quieren acelerar el entrenamiento de modelos, es una herramienta básica.
- 2 nov 2026TensorFold 1.2.0 aumenta un 44,2% el rendimiento de Qwen3.8-27B en el M3 Ultra con 16 flujos
- 1 nov 2026Los modelos locales pierden ante Opus y Codex: 0,21 puntos en un MacBook frente a 1,00 de Codex
- 1 nov 2026Un autor de Habr ajusta YOLOv8l con radiografías dentales y lleva el mAP50 a 0,642
- 1 nov 2026Los bots de voz con LLM recurren al clasificador rápido Jev: decisiones en 200–500 ms
Preguntas frecuentes sobre la noticia
¿Qué se sabe sobre Por qué perfilar los modelos?
Sin perfilado, el desarrollador solo ve la cifra final: «la época se entrenó durante 2 horas». Pero ¿por qué 2 horas? ¿En qué se fue el tiempo? ¿Quizá el dataloader es lento? ¿O una operación en la GPU es ineficiente? ¿O la GPU está parada esperando datos de la CPU? Optimizar a ciegas es adivinar. Cambias el batch size, la velocidad de carga, la precisión de los cálculos y el resultado no mejora, porque estás optimizando el cuello de botella equivocado. torch.profiler evita esa pérdida de tiempo: muestra la distribución exacta del tiempo y la memoria por operación.
Cómo funciona torch.profiler?
La herramienta traza la ejecución del código a nivel de kernels CUDA e hilos de CPU. Para cada operación, como una multiplicación de matrices en una capa Linear o una convolución en Conv2d, registra el tiempo de inicio, el de fin y la memoria utilizada. Los resultados se pueden exportar a un formato compatible con Chrome DevTools y visualizar como línea de tiempo. Las métricas principales del profiler: Exclusive time: el tiempo que la operación consumió por sí sola (sin las operaciones anidadas) Inclusive time: el tiempo de la operación junto con todas las llamadas anidadas
Cuándo torch.profiler revela problemas?
Un escenario típico: un modelo se entrena despacio, crees que necesitas una GPU más rápida, pero el profiler muestra que el 60% del tiempo de la época se va en esperar datos del dataloader. El problema no está en la GPU, sino en la carga de datos. La solución: aumentar num_workers en DataLoader o usar pinned memory. Otro ejemplo: un modelo se entrena en un sistema distribuido (varias GPU) y el profiler muestra que se pierde mucho tiempo en sincronizar gradientes entre dispositivos. Es una señal para optimizar el grafo de comunicación o replantear la estrategia de paralelism
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.