أنظمة RAG تتعطل على البيانات الحقيقية: السبب في الاسترجاع (retrieval) لا في النموذج
كثيرًا ما تتعطل خطوط معالجة RAG بسبب الاسترجاع (retrieval) لا بسبب النموذج. فحين يخطئ النظام في العثور على الوثيقة أو المقطع النصي المطلوب، يبدأ حتى GPT-4 بالهلوسة. جودة النموذج مرهونة بجودة السياق الذي يُقدَّم له.
معالج بواسطة الذكاء الاصطناعي من Habr AI؛ بتحرير Hamidun News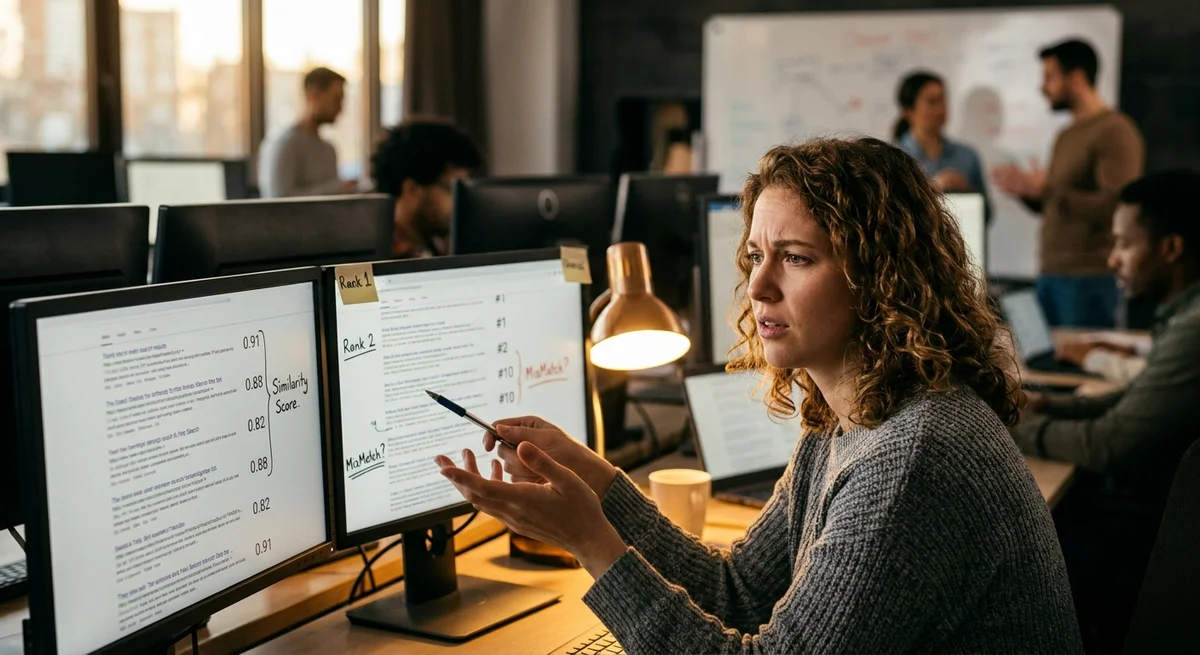
يبدو خط معالجة RAG كأنه سحر: تحمّل الوثائق، وتقطّعها إلى مقاطع (chunks)، وتولّد التضمينات (embeddings)، وتربط قاعدة بيانات متجهية. ثم تطرح سؤالًا فيجيب النموذج بثقة وتفصيل. تعرض النتيجة على العميل فيُعجب بها. لكن حين يبدأ الاختبار الفعلي بأسئلة حقيقية، يتبين أن النظام يخطئ الهدف في نصف الأسئلة.
الحلقة الأضعف في RAG
على الأسئلة الحقيقية، كثيرًا ما يجيب النظام إجابات خاطئة. فتارةً لا يعثر على الوثيقة المطلوبة أصلًا، وتارةً يعثر على الوثيقة الصحيحة لكنه يستخرج منها المقطع الخطأ، وتارةً لا يجلب أي محتوى ذي صلة، فيهلوس النموذج بثقة. قد يبدو أن المشكلة في النموذج، لكن الحقيقة أن retrieval هو المسؤول.
يجيب GPT-4 وClaude إجابات ممتازة إذا زُوِّدا بالسياق الصحيح. أما إذا كان السياق خاطئًا فالهلوسة حتمية، مهما بلغت جودة النموذج. جودة إجابة النموذج تساوي تمامًا جودة السياق الذي يُقدَّم له.
المشكلة ليست في النماذج، بل في retrieval، أي في الطريقة التي نبحث بها عن المقاطع ذات الصلة داخل قاعدة وثائقكم. هذه هي الحلقة الأضعف التي يمر عبرها خط معالجة RAG بأكمله. فإذا قدّم retrieval للنموذج سياقًا خاطئًا، يصبح كل ما عداه وقتًا ومالًا مهدورين.
«جودة إجابة النموذج تساوي جودة السياق الذي يُقدَّم له.»
متى يتعطل retrieval
يمكن أن يتعطل retrieval لعشرات الأسباب. وهذه أكثرها شيوعًا:
- تقطيع الوثائق إلى مقاطع كبير جدًا أو صغير جدًا. فقد يلتقط مقطع من 512 كلمة سياقًا مجاورًا بدلًا من المقطع المطلوب. مثال: السؤال عن سياسة الإرجاع، بينما يحتوي المقطع على وصف جدول المقاسات
- التضمينات مولَّدة لبيانات إنجليزية، بينما السؤال بالروسية. فتكون المسافة الدلالية بين متجه السؤال ومتجهات الوثائق هائلة، ولا توجد أي تطابقات
- إعادة صياغة السؤال بحيث لا يتطابق متجه تضمينه مع المتجهات في القاعدة. فإذا بحثتَ عن «вернуть заказ» (إرجاع الطلب) بينما تحتوي الوثائق على «возврат товара» (إرجاع البضاعة)، فالدلالة مختلفة
- العثور على الوثيقة ذات الصلة في المرتبة الثامنة من عشر، بينما لم يُمرَّر إلى النموذج سوى أفضل 5 نتائج. فلا يدخل السياق المطلوب ببساطة في نافذة الرؤية
- الفهرس ممتلئ بالنسخ المكررة والضوضاء. إذ تزاحم كثرة المقاطع غير ذات الصلة المعلومات الصحيحة وتُخرجها من النتائج
تؤدي كل واحدة من هذه المشكلات إلى النتيجة نفسها: يهلوس النموذج بدلًا من تقديم الإجابة الصحيحة.
كلفة retrieval
تحسين retrieval ليس هواية للمتحمسين، بل مهمة عمل حقيقية: فأسبوع أو أسبوعان يقضيهما المطوّر في التحليل قد يكشفان أن دقة النظام أقل بنسبة 30-40% من الدقة المتوقعة (expected accuracy). والسبب ليس في النموذج، بل في أن retrieval يبحث بطريقة خاطئة. وفي المشاريع الواقعية تمثل هذه خسارة كبيرة: أُنفق الوقت على RAG، وأُنفق المال على البنية التحتية، لكن النظام لا يعمل لأن متجهات الوثائق لا تتطابق مع متجهات الأسئلة.
ماذا يعني ذلك
لا يعمل RAG إلا إذا عمل retrieval. ودون ذلك سيخطئ حتى أفضل نموذج. وهذا يعني أن إطلاق RAG في بيئة الإنتاج يستلزم أولًا استثمار وقت جدي في تحسين البحث والاختبار على بيانات حقيقية، ثم التحسين التكراري لخط معالجة retrieval.
Access Frontier LLMs & Multimodal AI in One Workspace
Discover NomadNet AI (nomadnet.ai) — unified access to frontier language models, research synthesis, and multimodal workflows.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.