ICLR 2026 في ريو: ماذا يقول الباحثون عن توسيع نطاق النماذج الكبيرة
جمع مؤتمر ICLR 2026 نخبة الباحثين في ريو دي جانيرو في نهاية أبريل. وناقش المؤتمر، وهو الأرقى مكانة هذا العام، أبرز القضايا: كيف يمكن توسيع نطاق النماذج بكفاءة أكبر في ظل ارتفاع أسعار الرقائق، وأين يكمن خطر الذكاء الاصطناعي وكيف يمكن الحماية منه، وهل سيبقى مكان للنماذج المفتوحة إذا واصلت الشركات العملاقة إبقاء أقوى أنظمتها مغلقة. وقد حضرت AIRI المؤتمر، وتشارك انطباعاتها الجديدة عنه.
معالج بواسطة الذكاء الاصطناعي من Habr AI؛ بتحرير Hamidun News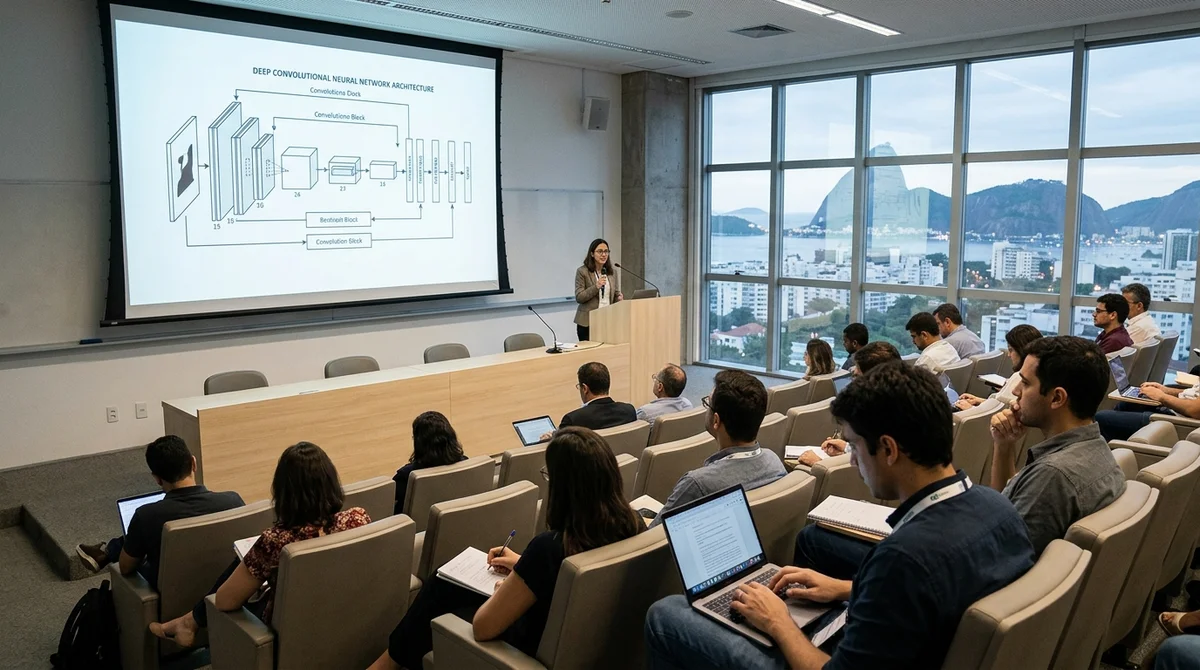
أُقيم مؤتمر ICLR 2026 في ريو دي جانيرو في نهاية أبريل، وأكد مكانته بوصفه التجمّع السنوي الأهم لباحثي الذكاء الاصطناعي. وهو بالنسبة إلى الأوساط العلمية أكثر من منصة لنشر الأبحاث المرموقة في المجلات: إنه المكان الذي تُولد فيه الأفكار وتُختبر، وتتحول بعد عام إلى معيار صناعي.
التوسّع مع مراعاة الكفاءة
تقترب ببطء، لكن بثبات، حقبة «كلما زادت المعاملات تحسّن النموذج». ولم يدور الحديث الأعلى صوتًا في ICLR حول حجم النماذج الجديدة، بل حول العائد على الاستثمار (Return on Investment): إذا أنفقتَ 100 مليون وحصلتَ على تحسّن بنسبة 3%، فلم يعد ذلك مجديًا اقتصاديًا. وقد سئم الباحثون من التظاهر بأن التوسّع يضمن التقدّم.
لماذا حدث ذلك؟ أسعار الرقائق ترتفع ولا تنخفض. ومضاعفة المعاملات لم تعد تضاعف الأداء. وبدأت الشركات تحسب بصراحة تكلفة تدريب النموذج الأساسي، إضافةً إلى الضبط الدقيق (fine-tuning) لكل مهمة متخصصة.
- أصبحت السياقات الطويلة (200K+ رمز) معيارًا لا أمرًا نادرًا
- يعمل المهندسون على تحسين سرعة الاستدلال وكفاءة الطاقة، لا حجم الأوزان وحده
- تظهر طرق للتوسّع الديناميكي في الحوسبة بحسب البيانات المُدخلة
- تزاحم النماذج متعددة الخبراء (MoE) البنى الكثيفة التقليدية
ولاحظ الحاضرون تحولًا في العقلية: يتحدث الباحثون عن نماذج أساسية طويلة العمر (long-lived foundation models)، أي نماذج تعيش طويلًا وتتحسن بالتدريج. فبدلًا من إعادة التدريب من الصفر باستمرار، تُضاف بيانات جديدة ومحوّلات (adapters) متخصصة وطبقات جديدة. وهذا أرخص وأسهل في بيئة الإنتاج (production)، وهو يتحول إلى القاعدة الجديدة.
الأمان أولوية
كان حضور موضوعات الأمان والضمانات في المؤتمر أوضح مما كان عليه قبل عام. ففي ICLR 2025 كان الأمر نادرًا، أما في 2026 فصار تيارًا رئيسيًا. ويقول الباحثون إن النماذج الكبيرة ينبغي ألا تُدرَّب على الأداء (performance) فحسب، بل على المتانة (robustness) أيضًا: مقاومة الأمثلة العدائية (adversarial examples)، والانزياحات التوزيعية، ومحاولات التلاعب.
«لم يعد بإمكاننا إطلاق نموذج ثم الأمل في ألا يتمكن أحد من اختراقه في
ظروف الاستخدام الفعلي» — موقف نموذجي في حلقات النقاش بالمؤتمر.
ولا يتعلق الأمر بالتنظيم التشريعي وحده (مع أن الدول تضع متطلبات جديدة). بل يتعلق بأن المجتمع العلمي نفسه أدرك أن السباق على نتائج SOTA يصبح خطيرًا إذا لم تُحتسب التكاليف الفعلية للضرر.
الأوزان المفتوحة في ظل الأنظمة المؤسسية
كان السؤال الأكثر احتدامًا في المؤتمر: هل سيكون للمصدر المفتوح في الذكاء الاصطناعي فرصة إذا واصلت Anthropic وOpenAI وMeta* إبقاء أكثر نماذجها تقدمًا مغلقة؟ وبدا الرأي في ICLR منقسمًا. فجزء من المجتمع العلمي يصرّ على أن النماذج المفتوحة بنية تحتية حيوية، ويجب تطويرها رغم المخاطر. أما الجزء الآخر فأكثر واقعية: ستتصدر الشركات الكبرى صفوف أفضل النماذج، فلديها موارد التدريب والمسؤولية أمام المستثمرين. وقد يبقى العلم المفتوح في دور داعم، يطوّر المنهجيات لكنه لا يمسك بخط المواجهة.
ماذا يعني ذلك
أظهر ICLR 2026 أن حقبة التوسّع الأسّي تقترب من نهايتها، لكن الذكاء الاصطناعي لا يتباطأ، بل يغيّر اتجاهه. وتنتظرنا حقبة التحسين المنهجي: كيف نستخدم الموارد بكفاءة أكبر، وكيف نجعل النماذج أكثر موثوقية، وكيف يبقى العلم المفتوح ذا صلة.
وهذا يعني للشركات الناشئة والمهندسين أن الميزة التنافسية لم تعد في تدريب نموذج أكبر، بل في نشر النماذج الموجودة بتكلفة أقل وسرعة أعلى وأمان أكبر.
*تعدّ روسيا شركة Meta منظمة متطرفة وتحظر نشاطها على أراضيها.
- 30 أكتوبر 2026Google: وكلاء الذكاء الاصطناعي مع Android CLI ينجزون مهام الواجهات أسرع بنسبة 77%
- 30 أكتوبر 2026Claude Enterprise يحصل على تقارير ذكية: من يستخدم الذكاء الاصطناعي وكيف وبكم
- 29 أكتوبر 2026Google تفتح Android Studio أمام وكلاء ذكاء اصطناعي من جهات أخرى: Claude وCodex وأكثر من 40 وكيلًا آخر
- 29 أكتوبر 2026Claude Code يمنتج الفيديو انطلاقًا من التفريغ النصي: كيف يعمل video-use الحاصل على 30 000 نجمة
أسئلة وأجوبة حول الخبر
ما أبرز التفاصيل حول التوسّع مع مراعاة الكفاءة؟
تقترب ببطء، لكن بثبات، حقبة «كلما زادت المعاملات تحسّن النموذج». ولم يدور الحديث الأعلى صوتًا في ICLR حول حجم النماذج الجديدة، بل حول العائد على الاستثمار (Return on Investment): إذا أنفقتَ 100 مليون وحصلتَ على تحسّن بنسبة 3%، فلم يعد ذلك مجديًا اقتصاديًا. وقد سئم الباحثون من التظاهر بأن التوسّع يضمن التقدّم. لماذا حدث ذلك؟ أسعار الرقائق ترتفع ولا تنخفض. ومضاعفة المعاملات لم تعد تضاعف الأداء. وبدأت الشركات تحسب بصراحة تكلفة تدريب النموذج الأساسي، إضافةً إلى الضبط الدقيق (fine-tuning) لكل مهمة متخصصة. أصبحت السياقات الطويلة (200K+ رمز) معيارًا لا أمرًا نادرًا يعمل المهندسون
ما أبرز التفاصيل حول الأمان أولوية؟
كان حضور موضوعات الأمان والضمانات في المؤتمر أوضح مما كان عليه قبل عام. ففي ICLR 2025 كان الأمر نادرًا، أما في 2026 فصار تيارًا رئيسيًا. ويقول الباحثون إن النماذج الكبيرة ينبغي ألا تُدرَّب على الأداء (performance) فحسب، بل على المتانة (robustness) أيضًا: مقاومة الأمثلة العدائية (adversarial examples)، والانزياحات التوزيعية، ومحاولات التلاعب. «لم يعد بإمكاننا إطلاق نموذج ثم الأمل في ألا يتمكن أحد من اختراقه في ظروف الاستخدام الفعلي» — موقف نموذجي في حلقات النقاش بالمؤتمر. ولا يتعلق الأمر بالتنظيم التشريعي وحده (مع أن الدول تضع متطلبات جديدة). بل يتعلق بأن المجتمع العلمي نفسه
ما أبرز التفاصيل حول الأوزان المفتوحة في ظل الأنظمة المؤسسية؟
كان السؤال الأكثر احتدامًا في المؤتمر: هل سيكون للمصدر المفتوح في الذكاء الاصطناعي فرصة إذا واصلت Anthropic وOpenAI وMeta إبقاء أكثر نماذجها تقدمًا مغلقة؟ وبدا الرأي في ICLR منقسمًا. فجزء من المجتمع العلمي يصرّ على أن النماذج المفتوحة بنية تحتية حيوية، ويجب تطويرها رغم المخاطر. أما الجزء الآخر فأكثر واقعية: ستتصدر الشركات الكبرى صفوف أفضل النماذج، فلديها موارد التدريب والمسؤولية أمام المستثمرين. وقد يبقى العلم المفتوح في دور داعم، يطوّر المنهجيات لكنه لا يمسك بخط المواجهة.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.