Google DeepMind تستثمر في مطوّر EVE Online لدراسة الذكاء الاصطناعي
استثمرت Google DeepMind في CCP Games، مطوّرة لعبة EVE Online. واشترت الشركة حصة أقلية في الاستوديو، وتخطط لاستخدام اللعبة كميدان لتدريب الذكاء الاصطناعي في أنظمة معقدة متعددة اللاعبين. بفضل اقتصادها الديناميكي وسياستها وآلاف اللاعبين فيها، ستصبح اللعبة مختبرًا فريدًا لدراسة سلوك الوكلاء الذكيين في سيناريوهات تفاعل واقعية.
معالج بواسطة الذكاء الاصطناعي من 3DNews AI؛ بتحرير Hamidun News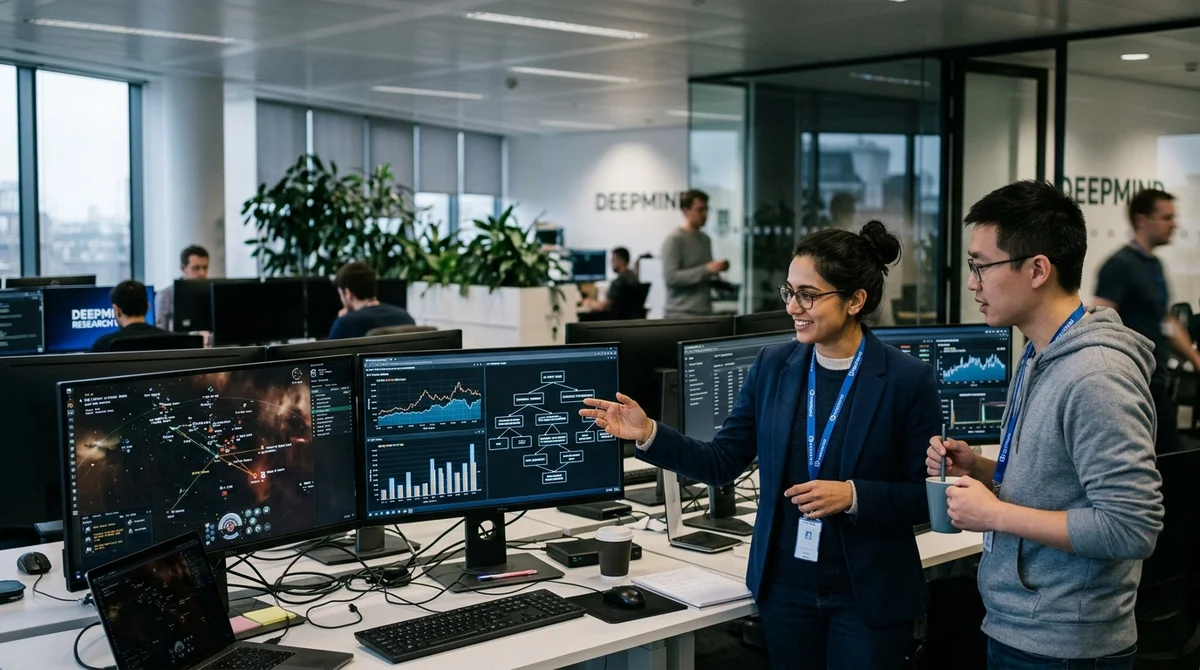
اشترت Google DeepMind حصة أقلية في CCP Games، مطوّرة محاكي الفضاء الشهير EVE Online. وتخطط المختبرات لاستخدام اللعبة كبيئة لأبحاث الذكاء الاصطناعي في أنظمة معقدة وديناميكية يديرها اللاعبون.
لماذا EVE Online
قد يبدو اختيار الباحثين غير مألوف للوهلة الأولى، لكنه يستند إلى منطق واضح. فـ EVE Online لعبة جماعية عبر الإنترنت، وهي عالم يمتد تاريخه لأكثر من عشرين عامًا، ويتفاعل فيه عشرات الآلاف من اللاعبين في وقت واحد ضمن فضاء مشترك، ويؤثر بعضهم في بعض بشكل مباشر. وفي اللعبة اقتصاد معقد خاص بها يشمل الإنتاج والتجارة، إضافة إلى أنظمة سياسية وشركات يديرها اللاعبون وتحالفات وحروب حقيقية على السيطرة على الأراضي. كل ذلك يشكّل عالمًا اجتماعيًا واقتصاديًا فريدًا.
ويوفر هذا العالم ظروفًا مثالية لدراسة سلوك الذكاء الاصطناعي، إذ يتعيّن على الوكلاء أن يتعلموا اتخاذ القرارات في ظل معلومات ناقصة ومنافسة حادة وتفاعلات اجتماعية معقدة مع وكلاء آخرين ومع اللاعبين. ولا يملك هؤلاء الوكلاء نجاحًا مضمونًا، بل عليهم التكيّف باستمرار مع أفعال المشاركين الآخرين، سواء كانوا لاعبين حقيقيين أو وكلاء ذكاء اصطناعي آخرين.
هذا بالتحديد ما يهم DeepMind: كيف يتصرف الذكاء الاصطناعي عندما يؤثر اختياره مباشرة في وكلاء آخرين، وعندما يحتاج إلى التخطيط على المدى البعيد والتكيّف سريعًا مع تغيّرات غير متوقعة في البيئة. ويصعب تطوير هذه المهارات في ظروف مختبرية معزولة تعتمد على محاكاة اصطناعية.
ما الذي سيجري اختباره
يخطط باحثو Google DeepMind لاستخدام عالم EVE Online كميدان لاختبار خوارزميات التعلم المعزز والأنظمة متعددة الوكلاء والتخطيط الاستراتيجي بعيد المدى. ومن الاتجاهات البحثية المحتملة:
- تدريب الوكلاء على التعاون والمنافسة داخل نظام واحد مع وكلاء ولاعبين آخرين
- تطوير ذكاء اصطناعي قادر على التفاوض وعقد الصفقات التجارية وتشكيل التحالفات
- دراسة السلوك الناشئ: كيف ينشأ سلوك جماعي معقد من قواعد سلوك بسيطة لوكلاء منفردين
- اختبار خوارزميات يمكنها التكيّف سريعًا مع تغيّر قواعد اللعبة وشروطها
- دراسة السلوك الاقتصادي: كيف يتخذ وكلاء الذكاء الاصطناعي قراراتهم بشأن توزيع الموارد والتجارة والاستثمار
وتكمن الميزة الرئيسية لهذا النهج في واقعية البيانات. فبدلًا من محاكاة نظام متعدد الوكلاء ببيئة مبسّطة، تحصل DeepMind على إمكانية الوصول إلى عالم حي يضم ملايين الساعات من التفاعلات بين اللاعبين، ومؤشرات اقتصادية واضحة، وعواقب حقيقية للخيارات.
السياق التاريخي
هذه ليست المحاولة الأولى لاستخدام الألعاب في أبحاث الذكاء الاصطناعي. ففي عام 2016 هزم AlphaGo، نظام DeepMind، بطل العالم في لعبة Go، ويعود ذلك جزئيًا إلى أن اللعبة وفّرت مجموعة ضخمة من المباريات التاريخية للتدريب. ثم استخدمت DeepMind لاحقًا ألعاب الفيديو (StarCraft وDota 2) في أبحاث الأنظمة متعددة الوكلاء.
غير أن EVE Online تتميز بحجمها وتعقيدها الاجتماعي. فهي ليست مجرد لعبة محاكاة، بل عالم حي باقتصاد يتفاعل فيه اللاعبون والذكاء الاصطناعي في الوقت الفعلي. ويُظهر استثمار DeepMind أن المختبر مستعد للعمل مع بيئات بحثية أكثر طموحًا.
ما الذي قد يتغيّر
يمثل استثمار DeepMind في EVE Online اعترافًا بأن ألعاب الفيديو أصبحت مختبرًا مهمًا لأبحاث الذكاء الاصطناعي. ويساعد هذا النهج في بناء أنظمة أكثر قدرة على التكيّف وأكثر ذكاءً، يمكنها العمل في ظروف واقعية غير متوقعة.
أما بالنسبة لمطوّري الألعاب، فقد يعني ذلك أن الشخصيات غير القابلة للعب (NPC) في مشاريعهم ستتصرف مستقبلًا بذكاء أكبر بكثير وبطريقة أكثر إثارة للاهتمام داخل عالم اللعبة. وبالنسبة للعلم والتكنولوجيا، فقد يعني أننا سنفهم بشكل أفضل كيف يتعلم الذكاء الاصطناعي ويتخذ قراراته حين يواجه تعقيدًا حقيقيًا وحالة من عدم اليقين.
Access Frontier LLMs & Multimodal AI in One Workspace
Discover NomadNet AI (nomadnet.ai) — unified access to frontier language models, research synthesis, and multimodal workflows.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.