اللغة الروسية في ChatGPT أغلى بمرتين: السبب هو التجزئة إلى رموز
يتضاعف سعر النص الروسي في ChatGPT وغيره من نماذج LLM السحابية مرتين مقارنةً بالإنجليزية. والسبب الطريقة التي تقسّم بها الشبكات العصبية النص إلى رموز (توكنات): فالكلمة الإنجليزية تشغل عادةً رمزًا واحدًا، بينما تتطلب الكلمة الروسية من 2 إلى 4 قطع. ونتيجة لذلك، تتقلص نافذة السياق إلى النصف.
معالج بواسطة الذكاء الاصطناعي من Habr AI؛ بتحرير Hamidun News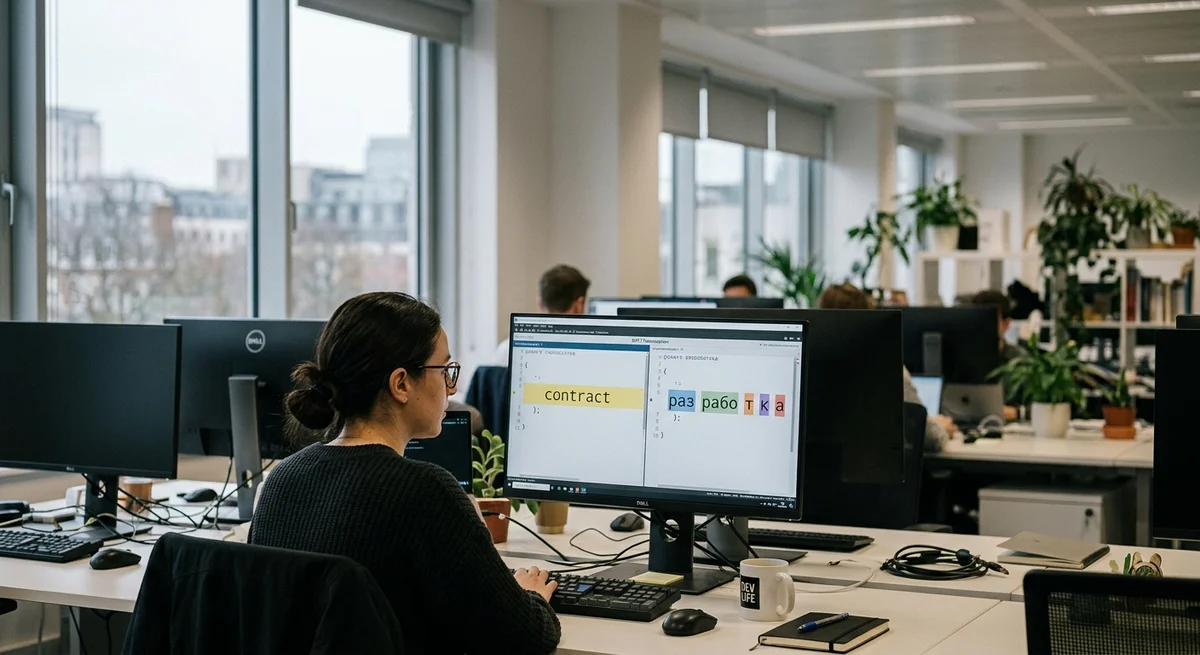
عندما ترسل طلبًا إلى ChatGPT أو أي شبكة عصبية سحابية أخرى، فهي لا تتعامل مع الحروف والكلمات مباشرةً. يُقسَّم النص أولًا إلى رموز (توكنات)، وهي قطع صغيرة من المعنى يستطيع النموذج معالجتها. ويعتمد على هذا التقسيم تكلفة الطلب وسرعة الرد وكمية المعلومات التي تتسع لها نافذة السياق في المرة الواحدة.
كيف تعمل التجزئة إلى رموز
التجزئة إلى رموز عملية تقطّع بها الشبكات العصبية المختلفة النص بطرق مختلفة. ويُقطَّع النص الإنجليزي بكفاءة عالية جدًا: فالكلمة تشغل عادةً رمزًا واحدًا أو رمزين. وكلمة «contract» مثلًا رمز واحد دائمًا. ويحتاج نص إنجليزي من 1000 كلمة إلى نحو 1200-1500 رمز.
أما اللغة الروسية فحظها أقل: فالمحتوى نفسه يتطلب قطعًا أكثر بمرتين إلى ثلاث مرات. فكلمة «разработка» (التطوير) في الروسية تحتاج إلى رمزين أو ثلاثة. و«программирование» (البرمجة) تحتاج إلى ثلاثة أو أربعة. أما صفة مثل «искусственный» (اصطناعي) فقد تشغل أربعة أو خمسة رموز. ويحتاج نص روسي من 1000 كلمة إلى 2500-3500 رمز.
ويحدث ذلك لأن اللغة الإنجليزية استُخدمت في تدريب نماذج اللغة الكبيرة الحديثة بكثافة أكبر بكثير من الروسية. فمفرداتها أفضل تمثيلًا في قاموس الرموز الذي جمعه مطورو النموذج من كميات ضخمة من المحتوى الإنجليزي. وتظل الأحرف السيريلية غريبة على الشبكات العصبية.
ماذا يعني ذلك عمليًا
بسبب هذا التفاوت في التجزئة، يكلّف النص الروسي في الخدمات السحابية مثل OpenAI نحو ضعف النص الإنجليزي عند تساوي كمية المعلومات الفعلية. فإذا كنت تدفع دولارًا واحدًا لمعالجة 1000 رمز من النص الإنجليزي، فسيكلّف النص الروسي دولارين.
ويظهر ذلك بوضوح أكبر في المشاريع الكبيرة: فتعريب تطبيق إلى الروسية، أو ترجمة وثائق، أو تشغيل روبوت دردشة بالروسية، ستكلّف ضعف الخدمات نفسها المقدَّمة لمستخدم ناطق بالإنجليزية.
لكن ارتفاع الكلفة ليس سوى بداية المشكلات. فمعالجة النص الروسي أبطأ بشكل ملحوظ، لأن على النموذج تمرير عدد أكبر من الرموز. وكلما زاد عدد الرموز، تأخر الرد. أما نافذة السياق، وهي حجم الذاكرة الذي يستطيع النموذج الاحتفاظ بالمعلومات فيه، فتصبح أصغر بمرتين من حيث المحتوى الفعلي. فإذا كانت نافذة السياق لدى النموذج 128 ألف رمز، فلن يتسع بالروسية سوى نصف المعلومات الروسية.
من المتضرر أكثر
- المطورون الناطقون بالروسية الذين يستخدمون الذكاء الاصطناعي في العمل على الوثائق والشيفرة
- الشركات التي تعالج كميات كبيرة من النصوص الروسية (الترجمة، روبوتات الدردشة، التحليلات)
- الشركات الناشئة الروسية التي تبني منتجات على LLM ولا تستطيع تحمّل نفقات OpenAI
- الباحثون الذين يعملون على اللغة الروسية ويحتاجون إلى تحليلات معمّقة عبر الشبكات العصبية
- المؤلفون والناشرون الذين يريدون استخدام الذكاء الاصطناعي في تحرير النصوص وإعادة صياغتها
كيف تقيس ذلك على بياناتك
يوصي كاتب المقال بالتحقق من النسبة الفعلية للرموز في نصوصك الخاصة: خذ عيّنة بالإنجليزية وأخرى بالروسية، واحسب الرموز عبر API من OpenAI، ثم قارن. يستغرق ذلك خمس دقائق تقريبًا ويُظهر السعر الدقيق لحالتك.
ماذا يعني ذلك
التفاوت في التجزئة إلى رموز ضريبة خفية على اللغة الروسية في عصر نماذج اللغة الكبيرة. وهو ليس خطأً من المطورين، بل نتيجة طبيعية للطريقة التي بُنيت بها هذه النماذج: على محتوى إنجليزي من الجيل الأول للإنترنت. وبالنسبة إلى المجتمع الناطق بالروسية، يعني ذلك قبول الواقع: فإما دفع مبلغ أكبر والحصول على نتائج أبطأ، وإما البحث عن بدائل دُرّبت بدعم أفضل للأحرف السيريلية.
Access Frontier LLMs & Multimodal AI in One Workspace
Discover NomadNet AI (nomadnet.ai) — unified access to frontier language models, research synthesis, and multimodal workflows.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.