Pingouin: كيف تبني خط معالجة إحصائيًا للتحليل الاستكشافي للبيانات
Pingouin مكتبة Python للتحليل الإحصائي. بها يمكن بناء خط معالجة متكامل للتحليل الاستكشافي للبيانات (EDA) يفحص الخصائص الأساسية للبيانات: اعتدالية التوزيع والارتباطات والقيم الشاذة. ويتيح ذلك الكشف عن الأنماط في مرحلة مبكرة من العمل مع البيانات.
معالج بواسطة الذكاء الاصطناعي من KDnuggets؛ بتحرير Hamidun News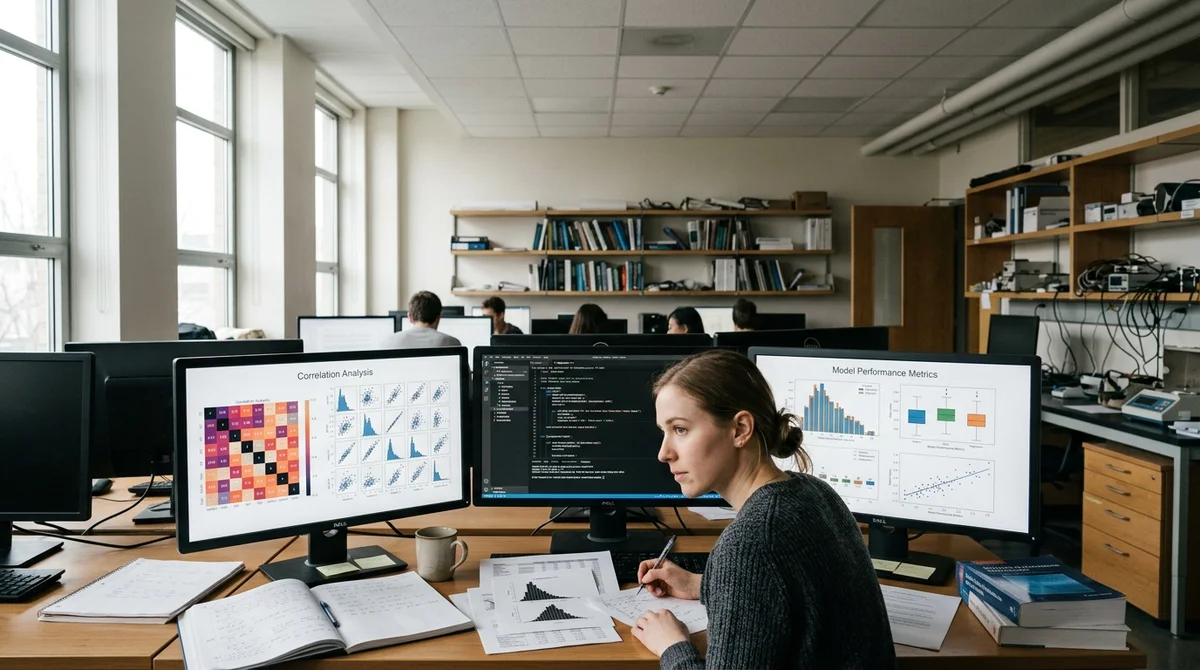
يبدأ معظم المحللين وعلماء البيانات استكشاف البيانات بالتصوير البصري: يرسمون المخططات، وينظرون في التوزيعات، ويحسبون الإحصاءات الأساسية. هذه بداية جيدة، لكنها غالبًا لا تكفي. Pingouin مكتبة Python تحوّل التحليل الاستكشافي للبيانات (EDA) إلى عملية إحصائية منهجية.
لماذا يُعد التحليل الإحصائي الاستكشافي أمرًا حاسمًا
يجيب التصوير البصري عن أسئلة «ماذا نرى؟» و«كيف تبدو البيانات؟». أما بناء نموذج موثوق فيتطلب إجابات أعمق:
- هل المتغيرات موزعة توزيعًا طبيعيًا؟
- هل توجد ارتباطات معنوية بين الخصائص؟
- أي المتغيرات يستحق الانتقاء للنموذج؟
- أين تختبئ القيم الشاذة والحالات غير الاعتيادية؟
- أي الافتراضات الإحصائية تم انتهاكها؟
من دون هذه الإجابات سيكون النموذج هشًّا. ففي مرحلة EDA يكون من الأسهل إعادة بناء الخصائص أو تصفية البيانات من إعادة تدريب النموذج لاحقًا.
ما الذي تستطيع Pingouin فعله
تحتوي المكتبة على دوال جاهزة للاختبارات الإحصائية الأساسية. فبدلًا من تذكّر الصيغ أو كتابة كتل طويلة بمكتبتي pandas وscipy، تستدعي دالة واحدة. أبرز الإمكانات:
- اختبارات الاعتدالية (Shapiro-Wilk وKolmogorov-Smirnov وAnderson-Darling) — تفحص اعتدالية التوزيع
- تحليل الارتباط — تحسب معاملات Pearson وSpearman وKendall مع قيمة p-value
- اختبارات تجانس التباين (Levene وBartlett) — تقارن تشتت القيم داخل المجموعات
- اكتشاف القيم الشاذة — بطرق IQR وZ-score وMahalanobis
- ANOVA والاختبارات اللاحقة (post-hoc) — تحلل الفروق بين المجموعات
- حجم الأثر (Cohen's d وeta-squared) — الأهمية العملية للنتائج
خط معالجة EDA نموذجي مع Pingouin
يتألف خط المعالجة من مراحل فحص متتابعة:
التحميل والتنظيف الأساسي. تقرأ البيانات، وتزيل التكرارات، وتعالج القيم المفقودة بالطريقة المعتادة.
فحص التوزيعات. لكل متغير رقمي تستدعي `pg.normality()`. إذا كانت قيمة p-value أكبر من 0.05 فالمتغير طبيعي التوزيع. وإذا لم تكن كذلك، فلا بد من تحويل (log أو sqrt أو Box-Cox).
تحليل الارتباط. تحسب مصفوفة الارتباط بواسطة `pg.corr()` وتحدد العلاقات المعنوية (p < 0.05). وتشير الارتباطات المرتفعة (> 0.9) إلى وجود تعدد خطي (multicollinearity).
اكتشاف القيم الشاذة. تطبّق عدة طرق (IQR وZ-score) وتقارن النتائج. يمكن حذف القيم الشاذة، أو فصلها لمعالجتها على حدة، أو التعامل معها بالتحويل.
فحص افتراضات النموذج. إذا كنت تخطط لانحدار خطي، فتحقق من تجانس التباين (homoscedasticity، أي تجانس تباين الأخطاء)، وغياب التعدد الخطي، وخطية العلاقات.
التوثيق. دوّن المتغيرات التي تنتهك الافتراضات، وما استبعدته منها ولماذا. سيفيدك ذلك عند تفسير النتائج.
«التحليل الاستكشافي الجيد حوار مع البيانات، وليس مونولوجًا من المخططات الجميلة.»
ماذا يعني ذلك
تُسهّل أدوات دقيقة مثل Pingouin الوصول إلى التحليل الإحصائي. فلم تعد بحاجة إلى تذكّر أسماء الاختبارات أو البحث عن الاختبار الصحيح في توثيق scipy؛ فالحل جاهز في بضعة أسطر. وهذا مفيد بوجه خاص في المراحل المبكرة من المشروع، حين تحتاج إلى أن تفهم سريعًا طبيعة البيانات التي تتعامل معها وما خطوات الإعداد التي ستلزم.
Executive AI Consulting, Custom Agents & Team Workshops
Work directly with Zhemal Khamidun at hamidun.com — enterprise AI architecture, production RAG & multi-agent systems, and executive training.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.