Databricks وAWS SageMaker: مسار عمل لضبط نماذج LLM بأمان
نشرت AWS وDatabricks نهجًا لضبط نماذج LLM (fine-tuning) عبر دمج Unity Catalog مع SageMaker AI. يشمل مسار العمل وصولًا آمنًا إلى البيانات الخاضعة للحوكمة، ومعالجة مسبقة (preprocessing) عبر EMR Serverless، وضبط نموذج Ministral-3-3B، ثم تسجيل المخرجات (artifacts) في الكتالوج من جديد، مع الحفاظ الكامل على الحوكمة وتتبّع مسار البيانات (data lineage).
معالج بواسطة الذكاء الاصطناعي من AWS Machine Learning Blog؛ بتحرير Hamidun News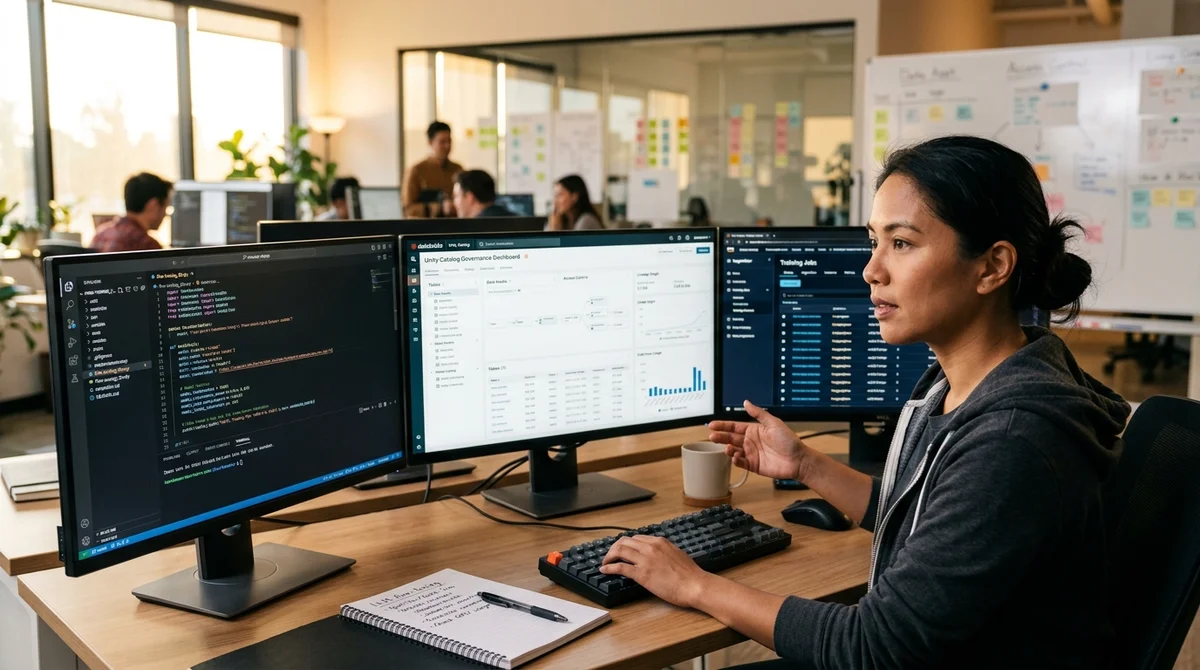
عرضت AWS وDatabricks طريقة لبناء مسار ضبط (fine-tuning) لنماذج LLM يعالج مشكلتين في آن واحد: الحفاظ على التحكم في البيانات والنماذج عبر كتالوج مركزي، دون التضحية بالوظائف أو بسرعة التطوير.
بنية مسار العمل
يدمج الحل ثلاثة مكونات. يتولى Databricks Unity Catalog مهمة الحوكمة والوصول: جدول واحد يحدد من يحق له استخدام أي بيانات. ويجهّز Amazon EMR Serverless البيانات للتدريب، بينما ينفّذ SageMaker AI عملية ضبط النموذج نفسها. وبعد التدريب، تُسجَّل المخرجات (أوزان النموذج والمقاييس) في Unity Catalog من جديد.
يتيح هذا النهج لفريق يضم مهندسي بيانات ومهندسي ML وعلماء بيانات العمل في مساحة واحدة موحّدة، دون الحاجة إلى نسخ البيانات بين الخدمات أو إعداد طبقات وصول منفصلة لكل أداة.
المراحل الرئيسية
- الحوكمة عند المدخل: يحدد Unity Catalog سياسات الوصول إلى البيانات المصدرية، أي الجداول المرئية والحقول المُخفاة (masked)
- المعالجة المسبقة (Preprocessing): يحوّل EMR Serverless البيانات الخام إلى صيغة صالحة لتدريب LLM
- الضبط (Fine-tuning): يضبط SageMaker AI نموذج Ministral-3-3B-Instruct (من Mistral) باستخدام البيانات المجهّزة
- تتبّع المسار (Lineage tracking): تبقى السلسلة كاملة، من الجداول المصدرية حتى النموذج النهائي، قابلة للتتبّع لأغراض التدقيق والامتثال (compliance)
- تسجيل المخرجات: يعود النموذج المدرَّب ومقاييسه إلى Unity Catalog بوصفهما أصولًا مُدارة
لماذا الآن؟
تواجه شركات كثيرة أحد سيناريوهين. إما أن تكون البيانات والنماذج موزعة بين خدمات مختلفة دون رؤية واضحة: من يستخدم ماذا، ومن أين تأتي البيانات، ومن عدّلها. وإما أن تحاول الشركات ترتيب الأمور عبر أنظمة مراقبة ووصول خاصة بها، وهو ما يتطلب أشهرًا من التطوير والصيانة.
«بدلًا من بناء الحوكمة من الصفر، نقدّم لكم تكاملًا جاهزًا تتحدث فيه
جميع المكونات اللغة نفسها»
يُنهي حل AWS وDatabricks هذه المفاضلة. فالحوكمة وتتبّع المسار (lineage) مدمجان في البنية منذ البداية، وليسا مضافين فوقها لاحقًا.
ماذا يعني ذلك
بالنسبة إلى المؤسسات الكبيرة والمؤسسات المالية، يعني هذا أنه بات بالإمكان اعتماد ضبط نماذج LLM دون خطر فقدان السيطرة على البيانات. أما بالنسبة إلى الفرق الهندسية، فلم تعد هناك حاجة إلى كتابة أنظمة تتبّع خاصة بها. ويسدّ التكامل الفجوة بين متطلبات الأمان وسرعة تطوير أنظمة ML.
- 26 أكتوبر 2026Claude Opus 5.5 يتصدر Code2Video-AA بـ 1536 نقطة Elo متقدمًا على GPT-6 Astra بفارق 109 نقاط
- 26 أكتوبر 2026تسريع إطلاق المنتج بمعدل 4.5 مرة وتوفير 87% من الموازنة: 3 بنى للذكاء الاصطناعي الآمن بموجب القانون الروسي 152-FZ
- 25 أكتوبر 2026منصة Artificial Analysis تطلق AA-PersonalityBench: تقييم 36 نموذجاً عبر 30 سمة و900 سؤال
- 24 أكتوبر 2026Nvidia تجري محادثات للاستحواذ على Reflection AI، الشركة الناشئة التي تبلغ قيمتها 8 مليارات دولار
أسئلة وأجوبة حول الخبر
لماذا الآن؟
تواجه شركات كثيرة أحد سيناريوهين. إما أن تكون البيانات والنماذج موزعة بين خدمات مختلفة دون رؤية واضحة: من يستخدم ماذا، ومن أين تأتي البيانات، ومن عدّلها. وإما أن تحاول الشركات ترتيب الأمور عبر أنظمة مراقبة ووصول خاصة بها، وهو ما يتطلب أشهرًا من التطوير والصيانة. «بدلًا من بناء الحوكمة من الصفر، نقدّم لكم تكاملًا جاهزًا تتحدث فيه جميع المكونات اللغة نفسها» يُنهي حل AWS وDatabricks هذه المفاضلة. فالحوكمة وتتبّع المسار (lineage) مدمجان في البنية منذ البداية، وليسا مضافين فوقها لاحقًا.
ما أبرز التفاصيل حول بنية مسار العمل؟
يدمج الحل ثلاثة مكونات. يتولى Databricks Unity Catalog مهمة الحوكمة والوصول: جدول واحد يحدد من يحق له استخدام أي بيانات. ويجهّز Amazon EMR Serverless البيانات للتدريب، بينما ينفّذ SageMaker AI عملية ضبط النموذج نفسها. وبعد التدريب، تُسجَّل المخرجات (أوزان النموذج والمقاييس) في Unity Catalog من جديد. يتيح هذا النهج لفريق يضم مهندسي بيانات ومهندسي ML وعلماء بيانات العمل في مساحة واحدة موحّدة، دون الحاجة إلى نسخ البيانات بين الخدمات أو إعداد طبقات وصول منفصلة لكل أداة.
ما أبرز التفاصيل حول المراحل الرئيسية؟
الحوكمة عند المدخل: يحدد Unity Catalog سياسات الوصول إلى البيانات المصدرية، أي الجداول المرئية والحقول المُخفاة (masked) المعالجة المسبقة (Preprocessing): يحوّل EMR Serverless البيانات الخام إلى صيغة صالحة لتدريب LLM الضبط (Fine-tuning): يضبط SageMaker AI نموذج Ministral-3-3B-Instruct (من Mistral) باستخدام البيانات المجهّزة تتبّع المسار (Lineage tracking): تبقى السلسلة كاملة، من الجداول المصدرية حتى النموذج النهائي، قابلة للتتبّع لأغراض التدقيق والامتثال (compliance) تسجيل المخرجات: يعود النموذج المدرَّب ومقاييسه إلى Unity Catalog بوصفهما أصولًا مُدارة
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.