كيف يساعد BERTopic مع نموذج لغوي كبير محلي شركة Rostelecom في تحليل كميات ضخمة من النصوص
قدّم مطوّر NLP في Rostelecom خط معالجة قائماً على BERTopic لأتمتة تحليل الكميات الكبيرة من النصوص أتمتةً كاملة، من مراجعات العملاء وطلبات الدعم الفني إلى التعليقات ومنشورات وسائل التواصل الاجتماعي. وأبرز تحسين فيه هو نموذج لغوي محلي مدمج يولّد أسماء مفهومة للموضوعات دون إرسال البيانات إلى السحابة، ما يحافظ على سرّيتها. وعملياً، تختصر هذه الطريقة العمل اليدوي من عدة أسابيع إلى بضع ساعات.
معالج بواسطة الذكاء الاصطناعي من Habr AI؛ بتحرير Hamidun News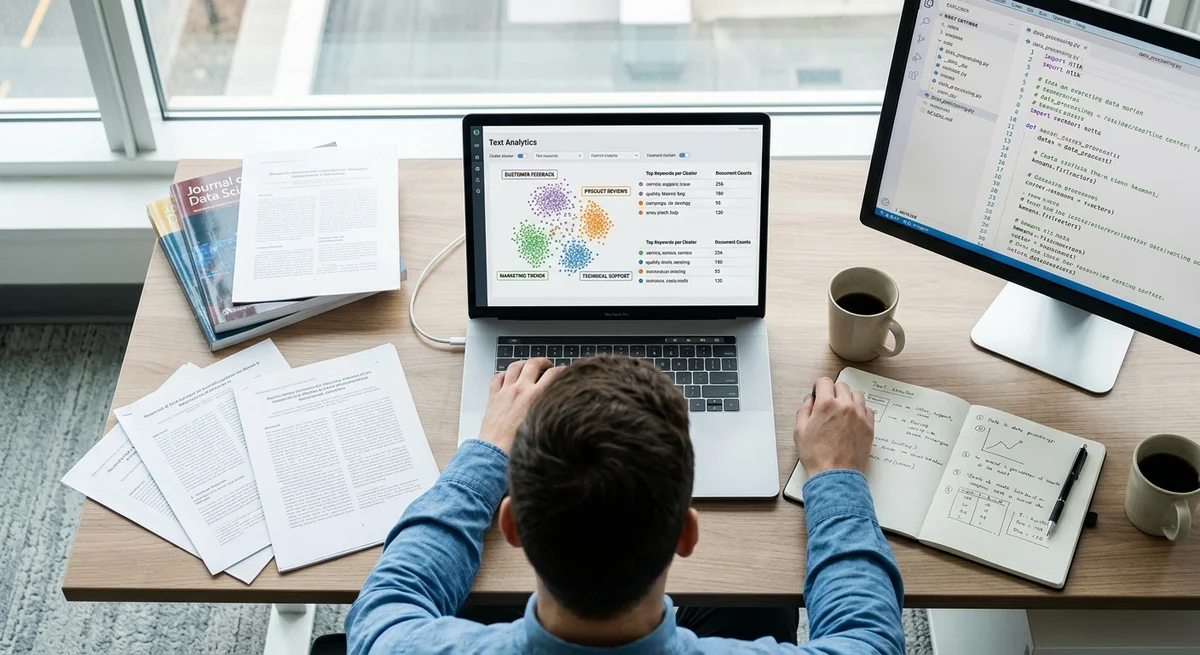
تُعدّ أتمتة تحليل النصوص من أكثر مهام NLP استنزافاً للجهد وأقلّها تقديراً. فحين تتلقى شركة عشرات الآلاف من المراجعات وطلبات الدعم والتعليقات يومياً، يصبح التصنيف اليدوي مستحيلاً، بل عديم الجدوى أيضاً من منظور العائد على الاستثمار (ROI). وقد اقترح أنطون، مهندس NLP في Rostelecom، حلاً لذلك: خط معالجة (pipeline) قائماً على BERTopic مع نموذج لغوي كبير (LLM) محلي مدمج للحصول على أسماء مفهومة للموضوعات.
لماذا نحتاج إلى أتمتة تحليل النصوص
تمثّل الكميات الكبيرة من النصوص منجم ذهب من البيانات غير المنظمة لأي شركة. ففي المراجعات تكمن شكاوى من أخطاء برمجية ونواقص محددة، وفي طلبات الدعم تظهر مشكلات منهجية ونقاط ضعف، وفي تعليقات وسائل التواصل الاجتماعي تختبئ أفكار لميزات ومنتجات جديدة. غير أن فريقاً من المحللين، ولو كان صغيراً، لا يستطيع فرز كل ذلك يدوياً في يوم أو حتى في أسبوع.
النهج التقليدي هو قراءة كل نص يدوياً وفهم مضمونه وتوزيعه على فئات. وعندما يبلغ الحجم 10 000 نص فأكثر، يصبح هذا النهج غير مجدٍ اقتصادياً، ومرهقاً للمختص، وبطيئاً. يضاف إلى ذلك عنصر الذاتية: فقد يصنّف أحد المحللين الشكوى ضمن فئة «مشكلات الشبكة»، ويصنّفها ثانٍ ضمن «جودة الخدمة»، وثالث ضمن «أخرى». وهكذا يضيع الاتساق وتصبح الاستنتاجات غير موثوقة.
كيف يحلّ BERTopic مشكلة التجميع
BERTopic إطار عمل يجمع عدة تقنيات للتعلم الآلي من أجل اكتشاف الموضوعات في النصوص تلقائياً. وتجري العملية على النحو التالي:
- التضمينات (BERT): يُحوَّل كل نص إلى متجه من الأرقام (تضمين)، بحيث تقع النصوص المتشابهة دلالياً قرب بعضها في فضاء متعدد الأبعاد. وبالنسبة إلى النص الروسي يمكن استخدام ruBERT أو نماذج أخرى.
- التجميع (HDBSCAN): تعثر هذه الخوارزمية السريعة على التجمعات الطبيعية للنصوص في هذا الفضاء، دون أن تتطلب معرفة عدد الموضوعات مسبقاً.
- التفسير: يولّد BERTopic اسماً لكل مجموعة استناداً إلى TF-IDF، أي إلى أهم الكلمات في المجموعة.
ما النتيجة؟ من فوضى 50 000 نص تنشأ، على سبيل المثال، 15 موضوعاً واضحاً وطبيعياً: «مشكلات الإنترنت»، و«استفسارات الفوترة»، و«أخطاء في تطبيق الهاتف المحمول»، و«طلبات الحصول على الامتيازات» وهكذا.
لكن هناك عيباً. فالتفسير القياسي في BERTopic كثيراً ما ينتج أسماء غريبة مثل «مشترك_خدمة_رقم» أو «خلل_عطل_خطأ» يصعب شرحها للأعمال. وهنا يأتي دور النموذج اللغوي.
دمج نموذج لغوي كبير محلي للتفسير
بدلاً من الانتقاء الآلي للكلمات من المجموعة، يقرأ نموذج لغوي محلي (مثل Mistral 7B أو Llama 2) أهم كلمات المجموعة وأهم مستنداتها، ثم يولّد وصفاً كاملاً بالروسية، مثل: «يشكو العملاء من بطء الإنترنت في المناطق الريفية، لا سيما في عطلات نهاية الأسبوع».
«دمج نموذج لغوي محلي يحمي سرّية البيانات: فجميع البيانات الجارية تبقى داخل الشركة، دون إرسالها إلى
OpenAI أو Claude API أو غيرها من الخدمات السحابية. وهذا أمر حاسم للشركات التي تتعامل مع معلومات حساسة»، يؤكد أنطون.
علاوة على ذلك، يعمل النموذج المحلي أسرع من طلبات API، ولا يعتمد إطلاقاً على الحصص والحدود وتكلفة الرموز (tokens) المعالَجة. ويعمل خط المعالجة دون اتصال بالإنترنت، ما يقلّل زمن الاستجابة (latency) ويزيد موثوقية النظام.
النتيجة العملية وقابلية التوسع
يتيح خط المعالجة في Rostelecom إنجاز ما كان يستغرق عدة أسابيع من العمل اليدوي في بضع ساعات:
1. تحميل مجموعة النصوص في BERTopic (قد تبلغ آلاف أو عشرات الآلاف من السجلات) 2. الحصول على مجموعات جاهزة مع أوصاف للموضوعات يولّدها النموذج اللغوي بلغة مفهومة للأعمال 3. تصدير النتائج إلى Excel أو CSV أو قاعدة بيانات ليواصل المحللون ومديرو المنتجات العمل عليها
كما يمكن إعادة استخدام خط المعالجة: هل وصلت دفعة جديدة إلى الدعم الفني؟ يُعاد تدريب خط المعالجة في دقائق، ويقدّم من جديد نتيجة منظمة.
ماذا يعني ذلك لقطاع NLP
تخرج أدوات NLP بنشاط من المختبرات والأوراق العلمية إلى بيئات الإنتاج (production) الفعلية. فحين يستطيع مهندس واحد في يوم واحد بناء خط معالجة متكامل الوظائف كان يتطلب سابقاً من أسبوعين إلى ثلاثة أسابيع من العمل اليدوي وخبرة فريق كامل، فهذا يعني أن NLP أصبح أداة عملية، لا تجربة علمية متاحة لكبرى شركات تقنية المعلومات وحدها.
Access Frontier LLMs & Multimodal AI in One Workspace
Discover NomadNet AI (nomadnet.ai) — unified access to frontier language models, research synthesis, and multimodal workflows.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.