Habr AI يستعرض بنية الكاميرا الافتراضية لمقاطع Shorts وReels مع تتبّع الوجه
نشر Habr AI تحليلًا مفصّلًا لكاميرا افتراضية مخصصة لمقاطع Shorts وReels. فبدلًا من القص التلقائي البسيط، بنى المؤلف خط معالجة production يضم سلسلة من كاشفات الوجه، وتتبّعًا للوجه، وترشيحًا لمنع الحركات المتشنجة (anti-jerk)، ونموذجًا فيزيائيًا لحركة الكاميرا. ونتيجة ذلك لا يتصرف الإطار العمودي كأداة قص مرتجفة، بل كمصوّر يتمتع بقصور ذاتي ووضع احتياطي (fallback). كما يتضمن النظام انتقالًا ناعمًا بأسلوب Ken Burns عند اختفاء الوجه من الإطار.
معالج بواسطة الذكاء الاصطناعي من Habr AI؛ بتحرير Hamidun News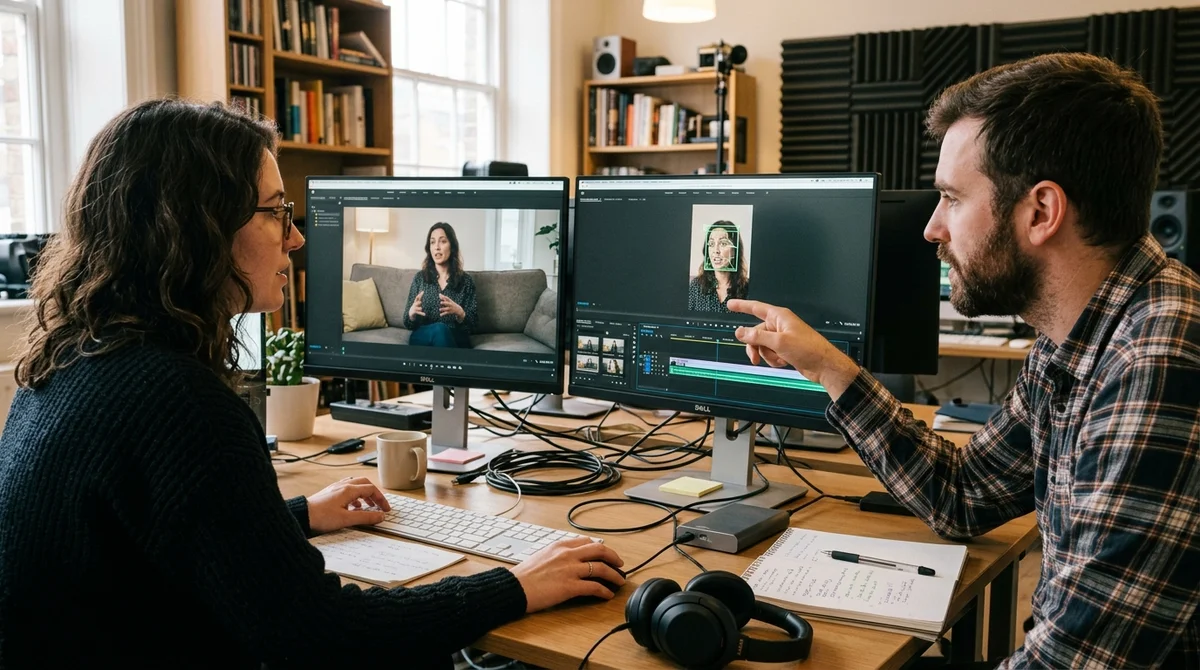
نشر Habr AI تحليلًا مفصّلًا لكاميرا افتراضية للفيديو العمودي، تحوّل المقطع الأفقي العادي إلى Shorts أو Reels دون قص تلقائي متشنج. ووصف المؤلف خط معالجة production تتبع فيه الكاميرا الوجه داخل الإطار لا عبر مربع إحاطة واحد، بل بوصفها منظومة ديناميكية مستقلة.
لماذا يفشل القص التلقائي
على الورق تبدو المهمة بسيطة: نأخذ الإطار الأصلي بنسبة 16:9، ونقتطع منه نافذة بنسبة 9:16، ونُبقي الشخص في المنتصف. لكن هذا النهج ينهار سريعًا في الفيديو الحقيقي. فقد يتحرك الوجه يسارًا أو يمينًا، وقد يظهر شخص ثانٍ في الإطار، وقد يصدر الكاشف نتائج مشوشة تارة، ويفقد الهدف تارة أخرى عند التفات الرأس أو عند وجود انعكاس ضوئي أو حركة يد. والنتيجة أن المقطع العمودي يبدو كأنه يعمل بتركيز تلقائي قديم: الصورة تقفز بعصبية وتخطئ باستمرار في التكوين.
يقترح المؤلف النظر إلى المسألة لا بوصفها قصًا تلقائيًا، بل بوصفها كاميرا افتراضية لها قصورها الذاتي الخاص، وحدّ أقصى للسرعة، وزمن تأخر في الاستجابة، ومنطق احتياطي (fallback). ولذلك لا يكفي أن يكتفي النظام بـ«اتباع مركز المربع». عليه أن يعمل عبر الزمن، وأن يتحمل البيانات غير الدقيقة، وألا يرتبك عند فقدان الوجه لفترات قصيرة، وأن يحافظ على حركة منطقية حتى في المشاهد التي لا توجد فيها وجوه إطلاقًا. وهذا أمر حاسم في المقاطع الطويلة.
«الكاميرا ليست إحداثية، بل منظومة ديناميكية».
كيف يعمل خط المعالجة
يقوم الحل على سلسلة كشف وجوه من ثلاثة مستويات: MediaPipe → YuNet → Haar Cascade. الكاشف الأول هو الخيار العملي الأساسي، والثاني يعمل كواجهة خلفية احتياطية بصيغة ONNX عبر OpenCV، أما الثالث فيبقى خط الدفاع الأخير عندما لا يتوفر أي خيار آخر أو يعطي نتائج سيئة.
تُخرج هذه السلسلة بيانات بصيغة موحدة: مركز الوجه، وحجمه، ومستوى الثقة (confidence)، ومربع الإحاطة (bounding box). وبفضل ذلك لا يعتمد بقية النظام على كاشف بعينه، ويستطيع العمل باستقرار حتى في الوضع المتدهور.
فوق الكشف يأتي تتبّع بسيط لكنه عملي: يقارن النظام مركز الوجه في الإطار السابق بالمرشحين في الإطار الحالي، ويختار أقرب كائن. وإذا اختفى الوجه لوقت قصير، تُفعَّل فترة سماح (grace period) تواصل خلالها الكاميرا الوثوق بآخر موضع معروف لوقت وجيز، كي لا تتحرك بشكل مفاجئ بسبب خطأ لحظي واحد. بعد ذلك يُنقّى الإشارة على خطوتين إضافيتين، ويُضاف وضع احتياطي مستقل للمشاهد التي لا تحتوي على وجوه.
- Anti-jerk يقطع القفزات الكبيرة جدًا في الإحداثيات بين الإطارات
- Low-pass filter يخفّف الضجيج المتبقي والاهتزازات الدقيقة
- Ken Burns fallback يتولى المشهد إذا فُقد الوجه أو لم يكن موجودًا أصلًا
- استيفاء المسار يحوّل التحليل الجاري بمعدل 8 FPS إلى حركة سلسة بمعدل 30 أو 60 FPS في الناتج النهائي
وفي المرحلة الأخيرة لا يكتفي النظام بتخزين حالات منفصلة للكاميرا، بل يبني مسارًا متصلًا. ثم يؤخذ لكل إطار المركز ومستوى التقريب (zoom)، ويُحسب ROI، وتُقتطع المنطقة المطلوبة وتُكبَّر أو تُصغَّر إلى الصيغة العمودية النهائية. وبهذا يبقى خط المعالجة معقولًا من حيث الكلفة الحسابية: يمكن إجراء التحليل على نسخة مصغّرة من الفيديو، ثم يُجرى القص النهائي على النسخة الأصلية، دون فقدان سلاسة الحركة في الإخراج النهائي.
كيف تتحول الكاميرا إلى مصوّر
أكثر الأجزاء إثارة هو نموذج الحركة. فبدلًا من القفز الفوري إلى النقطة المستهدفة، توصف الكاميرا بأنها مذبذب مخمَّد (damped oscillator): لها «كتلة» وصلابة وتخميد، وحدود للتسارع والسرعة القصوى. يمنح هذا التصميم قصورًا ذاتيًا ويجعل الحركة معقولة ومقنعة. وإذا بدأ الشخص يتحرك بسرعة أكبر، يمكن إضافة predictive lead كي تنظر الكاميرا إلى الأمام قليلًا بدل أن تلاحق الهدف فقط.
ومن المفارقة أن تأخرًا اصطناعيًا صغيرًا، أي human lag، يحسّن النتيجة أيضًا: فالاستجابة الدقيقة تمامًا تبدو في الغالب أقل طبيعية من استجابة متباطئة قليلًا.
وفوق الفيزياء يضع المؤلف قواعد التكوين. فالكاميرا قادرة على إزاحة الوجه نحو خطوط الأثلاث، ورفع نقطة الاهتمام قرب مستوى العينين، وتجاهل الحركات الدقيقة داخل المنطقة الميتة (dead zone)، والإبقاء على هامش آمن حول الوجه (face margin) كي لا تُقطع الأذنان أو الشعر أو حركات اليدين عند أطراف الإطار. وللمشاهد من نوع talking-head وضع مستقل لوجه واحد (single-face) بسرعة أكثر تحفظًا وتثبيت أقوى، أما للمقاطع التي لا وجوه فيها فيوجد انتقال ناعم إلى Ken Burns مع تحريك بانورامي وتقريب، بدل مركز «متجمد».
ماذا يعني ذلك
يُظهر هذا التحليل بوضوح الاتجاه الذي تسير نحوه أدوات المونتاج بالذكاء الاصطناعي. فالجودة هنا لا تنبع من نموذج «سحري» واحد، بل من تجميع هندسي: كاشفات احتياطية، وتتبّع، وترشيح، وفيزياء حركة، وتكوين، تعمل معًا. وبالنسبة لصنّاع المحتوى والفرق التي تقصّ المقاطع الطويلة بكميات كبيرة إلى Shorts وReels، لم يعد هذا قصًا تلقائيًا للعب، بل قالبًا عمليًا لكاميرا production يمكن تكراره وتكييفه مع أنماط تصوير مختلفة.
Access Frontier LLMs & Multimodal AI in One Workspace
Discover NomadNet AI (nomadnet.ai) — unified access to frontier language models, research synthesis, and multimodal workflows.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.