NVIDIA تعرض Nemotron OCR v2: نموذج متعدد اللغات للتعرف الضوئي على الحروف مدرَّب على 12.2 مليون مستند اصطناعي
كشفت NVIDIA تفاصيل Nemotron OCR v2، وهو نموذج متعدد اللغات للتعرف الضوئي على الحروف (OCR) دُرّب في معظمه على 12.2 مليون مستند اصطناعي. لم تراهن الشركة على بنية جديدة، بل على البيانات الضخمة: فالنظام يقرأ الإنجليزية والروسية واليابانية والكورية والصينية بمحرك واحد، ويعالج على A100 ما يصل إلى 34.7 صفحة في الثانية. وأضافت الشركة إلى بيانات التدريب نحو 680 ألف صورة حقيقية.
معالج بواسطة الذكاء الاصطناعي من Hugging Face Blog؛ بتحرير Hamidun News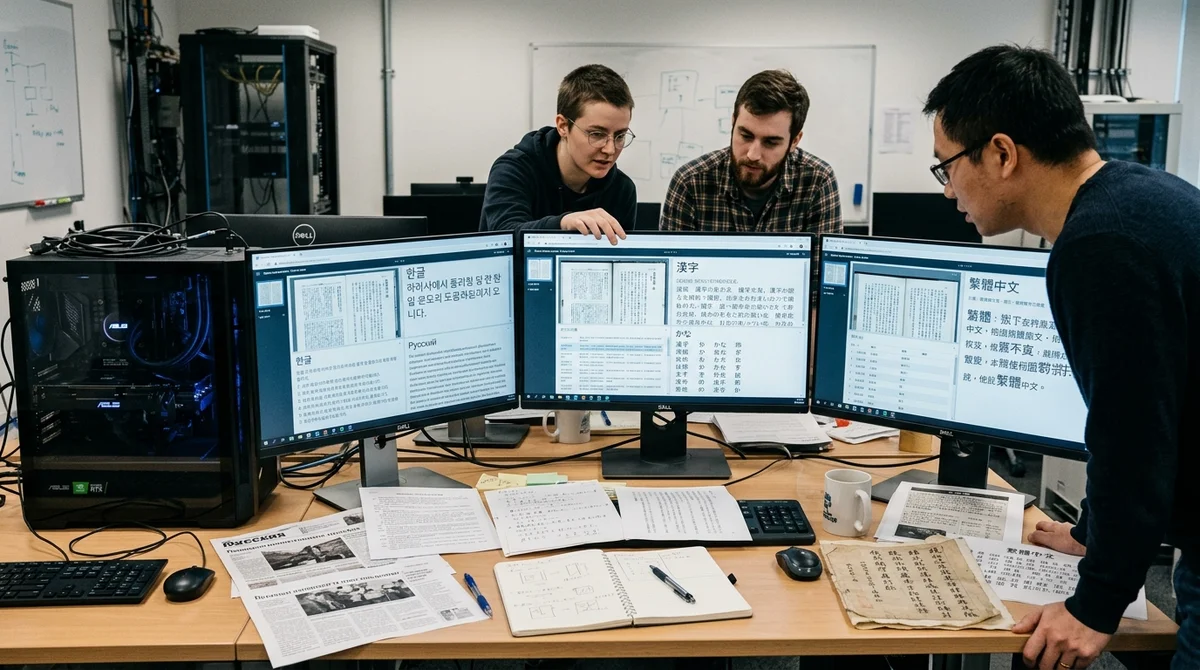
عرضت NVIDIA كيف بنت Nemotron OCR v2، وهو نظام متعدد اللغات للتعرف الضوئي على الحروف، لم تأتِ القفزة الرئيسية فيه من حيل معمارية ذكية، بل من البيانات الاصطناعية بحجم كبير. جمعت الشركة مجموعة بيانات من 12.26 مليون مستند مولَّد اصطناعيًا، ودرّبت عليها نموذجًا يقرأ عدة لغات بمحرك واحد ويصل إلى 34.7 صفحة في الثانية على بطاقة A100 واحدة.
التركيز على البيانات
كان الإصدار السابق Nemotron OCR v1 يعمل بثقة مع الإنجليزية، لكنه كان يخفق في اللغات الأخرى. وأظهر اختبار SynthDoG أن قيم Normalized Edit Distance للغات اليابانية والكورية والروسية والصينية كانت مرتفعة جدًا، إذ بدت النتيجة في بعض المواضع بعيدة عن النص الأصلي. حتى إن الفريق وسّع مجموعة الرموز من 855 إلى 14 244 لتغطية السيريلية وأنظمة الكتابة الصينية واليابانية والكورية (CJK)، لكن المكسب كان محدودًا. فقد كان النموذج قادرًا من الناحية الشكلية على إخراج الرموز المطلوبة، لكنه لم يكد يراها أثناء التدريب.
«العنق الضيق كان البيانات، لا البنية».
كان هذا بالضبط نقطة التحول في المشروع. فالتوسيم اليدوي لملايين المستندات بمربعات إحاطة على مستوى الكلمات والأسطر والفقرات سيكلّف كثيرًا، أما جمع ملفات PDF من الويب فيعطي طبقة نصية مشوشة وكثيرًا من الأخطاء. لذلك سلكت NVIDIA طريقًا آخر: توليد المستندات برمجيًا مع معرفة الإحداثيات والنسخ النصية وترتيب القراءة لكل جزء بدقة مسبقًا.
كيف بُني المتن
استخدمت NVIDIA في النصوص mOSCAR، وهو متن ويب كبير متعدد اللغات يضم 163 مجموعة لغوية فرعية. وهذا مكّنها من استخدام عبارات أكثر واقعية بتوزيع طبيعي للكلمات والرموز، بدل قوائم المفردات أو النصوص المترجمة آليًا.
واعتمدت الشركة محرك العرض SynthDoG من مشروع Donut وأعادت تطويره بشكل كبير. ولا تقتصر المخرجات على صور صفحات، بل تشمل توسيمًا هرميًا كاملًا على مستوى الكلمات والأسطر والفقرات، إضافة إلى رسم بياني للعلاقات يحدد ترتيب القراءة. وأُضيفت إلى خط المعالجة عدة عناصر مهمة لتقريب البيانات الاصطناعية من المستندات الحقيقية:
- قوالب تخطيط متعددة: أعمدة وجداول ونص عمودي وفهارس وشرائح وصفحات بنمط Word
- توسيم لا يقتصر على مربعات الإحاطة، بل يشمل هرمية العناصر والروابط بين الأسطر
- الانتقال إلى التعرف على مستوى الأسطر في اليابانية والكورية والصينية، حيث كثيرًا ما تكون حدود الكلمات غامضة
- مجموعة كبيرة من الخطوط المفتوحة، من 165 إلى 1 258 خطًا لكل لغة، بما فيها عائلات Google Fonts وNoto
- تعزيزات بيانات قوية: ظلال وحدود وضجيج وتمويه وتشويه وتغيير في السطوع والخلفيات
تضم مجموعة البيانات النهائية 12 258 146 مثالًا موزعة على ست فئات لغوية: الإنجليزية واليابانية والكورية والروسية والصينية المبسطة والصينية التقليدية. ويعمل النموذج متعدد اللغات نفسه كحزمة واحدة للإنجليزية والروسية واليابانية والكورية والصينية، دون خطوة منفصلة لتحديد اللغة. ومنطق التوسع بسيط أيضًا: إذا توفر لأي لغة جديدة متن نصي وخطوط مناسبة، يمكن توسيع خط المعالجة أكثر دون توسيم يدوي ودون إعادة كتابة البنية.
السرعة والمقايضات
لم يُدرَّب Nemotron OCR v2 على البيانات الاصطناعية فقط، بل أيضًا على نحو 680 ألف صورة حقيقية. وتتكون البنية من ثلاثة أجزاء: كاشف نصوص مبني على RegNetX-8GF، ومتعرّف قائم على Transformer، ووحدة علائقية (relational) تفهم أي الأسطر والكتل مترابطة فيما بينها. والفكرة الأساسية أن العمود الفقري الالتفافي الثقيل يمرّر الصفحة مرة واحدة فقط، ثم تُعاد الاستفادة من سماته في بقية المكونات. وبهذا لا يهدر النظام حسابات إضافية على كل مرحلة من مراحل خط المعالجة على حدة.
على الاختبار الاصطناعي تبدو المكاسب قوية جدًا. ففي الروسية انخفض NED من 0.564 في Nemotron OCR v1 إلى 0.043 في v2، وفي اليابانية من 0.723 إلى 0.046، وفي الكورية من 0.923 إلى 0.047، وفي الصينية المبسطة من 0.784 إلى 0.035. وبحسب بيانات NVIDIA، تفوقت النسخة الموحدة متعددة اللغات على هذه المجموعة حتى على النسخ اللغوية المتخصصة من PaddleOCR. لكن الصورة أكثر تعقيدًا على اختبار OmniDocBench الواقعي: يحقق Nemotron OCR v2 سرعة 34.7 صفحة في الثانية مقابل 1.2 لدى PaddleOCR v5، أي تفوقًا في السرعة بأكثر من 28 ضعفًا، غير أنه يتأخر في الدقة عن أفضل المنافسين في بعض المجموعات الفرعية. ويختار المنتج هنا بوضوح موازنة تميل إلى سرعة المعالجة لا إلى أقصى جودة بأي ثمن.
ماذا يعني ذلك
يمثل Nemotron OCR v2 إشارة جيدة لسوق الذكاء الاصطناعي الموجّه للمستندات: فالبيانات الاصطناعية لم تعد مجرد تأثير تجريبي، بل أصبحت وسيلة عملية لإطلاق نماذج OCR متعددة اللغات بسرعة وتوسيعها إلى أنظمة كتابة جديدة. وللشركات يعني ذلك طريقًا أقل كلفة للتعرف على المستندات، خصوصًا حيث تكون السرعة والشمولية والتحكم في التوسيم أهم من تحقيق رقم قياسي مطلق في كل اختبار.
Access Frontier LLMs & Multimodal AI in One Workspace
Discover NomadNet AI (nomadnet.ai) — unified access to frontier language models, research synthesis, and multimodal workflows.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.