أمازون تعرض بحثًا بلغة طبيعية في أرشيفات الفيديو الضخمة عبر Nova
عرضت أمازون بنية عملية للبحث في أرشيفات الفيديو الضخمة دون وسم يدوي ودون الاعتماد على كلمات مفتاحية صارمة. يقسّم Nova المقاطع إلى أجزاء مدة كل منها 15 ثانية، ويبني لها تمثيلات متجهية متعددة الوسائط، ثم يخزّنها في OpenSearch مع الوسوم. وعلى مجموعة تضم نحو 792 ألف فيديو، استجاب البحث الدلالي خلال 76 مللي ثانية، بينما استغرق البحث الهجين نحو 106 مللي ثانية. يجمع الحل بين Amazon Nova Multimodal Embeddings وAmazon OpenSearch Service، ويتيح البحث بالنص الطبيعي، والعثور على فيديوهات مشابهة، والبحث الهجين الذي يدمج الدلالة والكلمات المفتاحية. وتقدّر AWS تكلفة السنة الأولى بنحو 23.6–27.3 ألف دولار بحسب نموذج الدفع في OpenSearch، وتشكّل تكلفة توليد التمثيلات المتجهية الجزء الأكبر منها.
معالج بواسطة الذكاء الاصطناعي من AWS Machine Learning Blog؛ بتحرير Hamidun News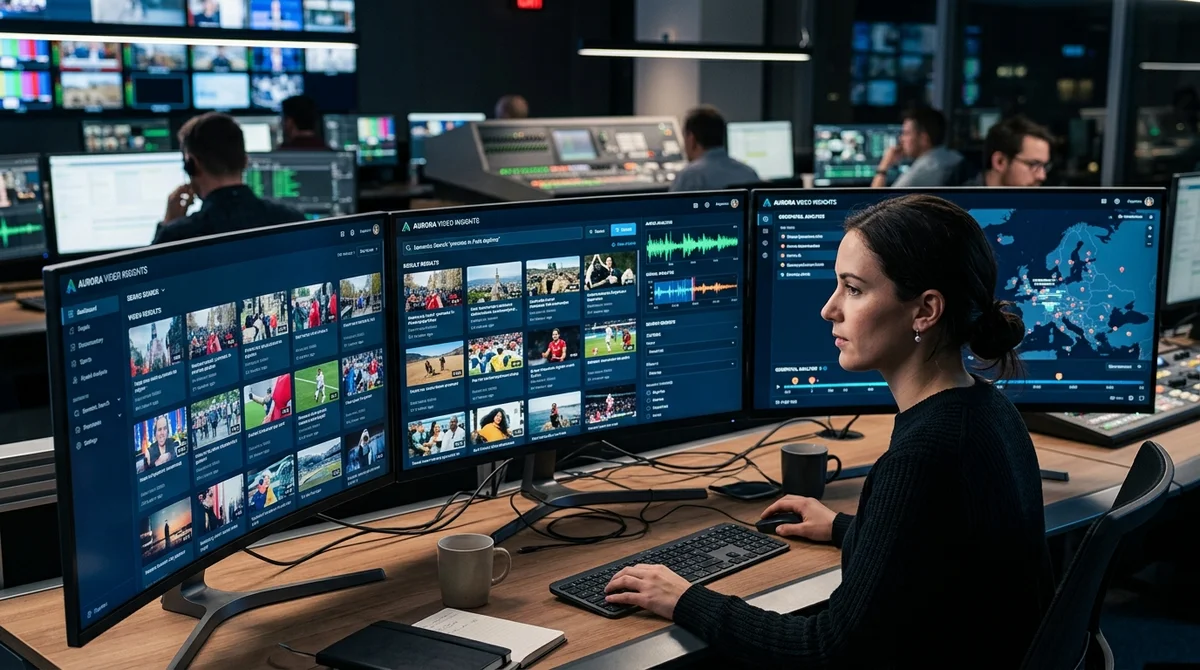
عرضت أمازون طريقة لبناء بحث في أرشيفات الفيديو الضخمة دون وسم يدوي ودون ارتباط صارم بالكلمات المفتاحية. فبدل الوسم وفق سيناريو محدد مسبقًا، يبني النظام تمثيلات متجهية (Embeddings) متعددة الوسائط للصوت والصورة، ثم يبحث عن المقاطع بحسب المعنى عبر OpenSearch.
كيف يعمل البحث
يقوم الحل على الجمع بين Amazon Nova Multimodal Embeddings وAmazon OpenSearch Service. تُرفع مقاطع الفيديو إلى S3، ثم تقسّمها واجهة Nova البرمجية غير المتزامنة تلقائيًا إلى أجزاء مدة كل منها 15 ثانية، وتبني لها متجهات بأبعاد 1024 في وضع AUDIO_VIDEO_COMBINED. وهذا مهم: فالنموذج لا يأخذ الصورة وحدها في الحسبان، بل الصوت أيضًا. لذلك لا يفهم البحث كلمات منفردة في التعليق النصي، بل سياق المشهد نفسه: من يتحدث، وما الذي يجري في الإطار، وما الأجواء العامة للمقطع.
وتقترح AWS بشكل منفصل تمرير المقاطع عبر Nova Pro أو Nova 2 Lite لتوليد 10–15 وسمًا وصفيًا وفق تصنيف (Taxonomy) محدد. ونتيجة لذلك يحتفظ النظام بفهرسين: متجهي للبحث الدلالي، ونصي للبحث بالكلمات المفتاحية. ويتيح هذا التصميم ألا يُضطر المستخدم إلى الاختيار بين البحث «الذكي» والتصفية بحسب البيانات الوصفية، إذ يمكن الجمع بين النهجين في واجهة واحدة. وعمليًا، يمكن تصفّح الأرشيف نفسه باستعلامات من قبيل «رجل يمشي على الشاطئ عند الغروب»، وكذلك عبر مرشحات نصية صارمة.
- البحث بالنص في الفيديو: يتحول الاستعلام بلغة طبيعية إلى تمثيل متجهي ويُقارن بمقاطع الفيديو.
- البحث عن فيديوهات مشابهة: يأخذ النظام متجه مقطع معروف ويعثر على أجزاء قريبة منه في المحتوى.
- البحث الهجين: تُدمج نتائج k-NN وBM25، بأوزان افتراضية تبلغ 70% للدلالة و30% للنص.
الحجم والتكلفة
لم تختبر AWS هذه البنية على مجموعة تجريبية من بضعة ملفات، بل على مجموعة تضم نحو 792 ألف فيديو من مجموعتي البيانات Multimedia Commons وMEVA. ويبلغ إجمالي المحتوى نحو 8 480 ساعة، أي 30.5 مليون ثانية. واستغرقت المعالجة الكاملة 41 ساعة على أربعة نُسخ من النوع c7i.48xlarge مع 600 عامل متوازٍ. وفي المقابل، يفرض Bedrock حدًا قدره 30 مهمة غير متزامنة متزامنة لكل حساب، ولذلك يعتمد المثال على قائمة انتظار للمهام مع استعلام دوري عن الحالة وتحميل مقاطع جديدة كلما تحرّرت خانات.
والصورة المالية واضحة إلى حد كبير. تقدّر AWS تكلفة السنة الأولى لنظام كهذا بنحو 23.6–27.3 ألف دولار بحسب نموذج الدفع المختار في OpenSearch. ومن هذا المبلغ يذهب نحو 18.1 ألف دولار إلى التحميل لمرة واحدة وتوليد التمثيلات المتجهية، والباقي إلى تشغيل طبقة البحث على مدار العام. وبند الإنفاق الرئيسي ليس الحوسبة على EC2، بل التمثيلات المتجهية نفسها، لأن Nova يُحاسَب بحسب مدة الفيديو. وفيما يلي التوزيع:
- نحو 17 096 دولارًا — توليد التمثيلات المتجهية متعددة الوسائط في Amazon Bedrock
- نحو 571 دولارًا — الوسم التلقائي عبر Nova Pro
- نحو 421 دولارًا — الحوسبة على EC2 للمعالجة الدفعية
- من 5 544 إلى 9 240 دولارًا سنويًا — التخزين والبحث في OpenSearch بحسب نموذج الدفع
وتوضح AWS أيضًا سبب اختيار متجهات بأبعاد 1024 بدل 3072 في المثال: فتكلفة التوليد لا تتغير، لكن التخزين يصبح أرخص بنحو ثلاثة أضعاف مع خسارة طفيفة في الدقة. أما على جانب البحث، فالأرقام تبدو بالفعل بمستوى الإنتاج: يستجيب k-NN الدلالي خلال نحو 76 مللي ثانية، وBM25 خلال 30 مللي ثانية، والوضع الهجين خلال 106 مللي ثانية. وتشغل الفهارس مجتمعةً نحو 29.8 غيغابايت للمجموعة كاملة، فحتى الأرشيف الكبير لا يتطلب بنية تحتية استثنائية.
ملاحظات عملية
تكمن أهمية هذه المادة لا في كونها إعلانًا عن نموذج جديد، بل في كونها قالبًا هندسيًا جاهزًا. فـAWS تعرض عمليًا كيف يمكن الانتقال من الوسم اليدوي للفيديو إلى AI data lake، حيث يُبنى البحث حول التمثيلات المتجهية لا حول الأوصاف البشرية. وقد يغطي ذلك عدة مهام دفعة واحدة لدى فرق الإعلام وشركات الترفيه: اكتشاف النسخ المكررة، والتنقل في الأرشيف، والاختيار السريع للقطات b-roll، وبناء أدوات داخلية للمحررين والمنتجين وأمناء الأرشيف.
لكن هناك قيودًا أيضًا. فالتشغيل يتطلب Bedrock في المنطقة us-east-1، وOpenSearch بالإصدار 2.11 أو أحدث، وS3، وصلاحيات IAM مضبوطة. وتعتمد السرعة والتكلفة مباشرة على مدة المقاطع: ففي الاختبار استغرقت معالجة فيديو مدته 45 ثانية نحو 70 ثانية. وإذا كانت البيانات الوصفية لديك جيدة، تنصح AWS بزيادة حصة البحث النصي بدرجة أكبر، وصولًا إلى 50/50. أما إذا استمرت المكتبة في النمو، فيمكن نقل منطق المعالجة إلى AWS Batch وتوسيع النطاق على مراحل.
ماذا يعني ذلك
تُظهر أمازون أن البحث متعدد الوسائط في الفيديو لم يعد لعبة بحثية، بل أصبح نمطًا بنيويًا واضحًا. وتشكّل هذه فرصة لفرق الإعلام كي تتخلى عن الوسوم اليدوية وتبحث أخيرًا في الأرشيف بالطريقة التي يصوغ بها الناس استعلاماتهم فعلًا: بلغتهم اليومية.
Access Frontier LLMs & Multimodal AI in One Workspace
Discover NomadNet AI (nomadnet.ai) — unified access to frontier language models, research synthesis, and multimodal workflows.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.