ربط Whisper وGemma 3 بالتعلّم التبايني لإضافة إدخال صوتي منخفض التكلفة إلى نماذج اللغة الكبيرة
تبيّن أن إضافة الصوت إلى نموذج لغوي كبير بتكلفة منخفضة أصعب مما تَعِد به الأوراق البحثية. ربط الكاتب Whisper Medium بـ Gemma 3 4B عبر مُسقِط MLP، وجرّب teacher forcing وLoRA والتكميم ومجموعة من أساليب التنظيم، لكن التقدم الفعلي لم يحدث إلا مع InfoNCE التبايني. نتيجة أول تشغيل ناجح هي WER بنسبة 35%: النموذج لا يزال بعيدًا عن أنظمة ASR الإنتاجية، لكنه بات يتعرّف على الكلام، وأخطاؤه منطقية صوتيًا.
معالج بواسطة الذكاء الاصطناعي من Habr AI؛ بتحرير Hamidun News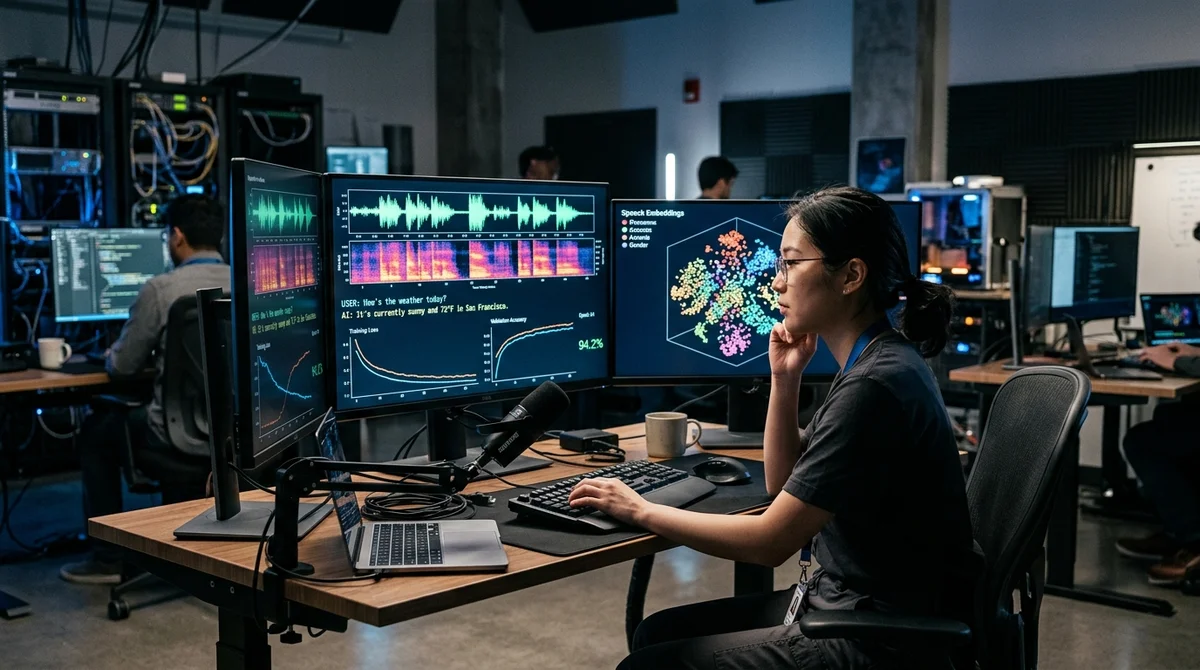
لم تكن إضافة الإدخال الصوتي إلى نموذج لغوي كبير بتكلفة منخفضة بالسهولة التي توحي بها كثير من الأعمال البحثية في مجال الوسائط المتعددة. حاول صاحب التجربة ربط مُشفّر الصوت Whisper بنموذج اللغة Gemma 3 عبر مُسقِط مدمج، وبعد سلسلة من الإخفاقات وصل إلى إعداد يعمل بالتعلّم التبايني.
كيف بُني النظام
كانت الفكرة بسيطة: بدلًا من تدريب نظام متعدد الوسائط مكلف من الصفر، يُؤخذ مُشفّر صوتي جاهز ونموذج لغوي كبير جاهز، ويُربط بينهما بـ«مترجم» بين فضاءَي التضمينات. اختير Whisper Medium مُشفّرًا لأن تمثيلاته الداخلية أنسب للتعرّف على الكلام من بدائل التعلّم الذاتي الإشراف. أما على جانب النص فاستُخدم Gemma 3 4B، وتولّى دور الجسر مُسقِط MLP من طبقتين يضغط المتجهات الصوتية ويحوّلها إلى فضاء تضمينات النموذج اللغوي.
ولكي لا يتدرّب النموذج على الإنجليزية الصافية المسجّلة في الاستوديو فقط، جُمعت بيانات التدريب من عدة مجموعات بيانات وخُلطت ديناميكيًا. أتاح ذلك تعريض النظام منذ البداية لكلام متنوّع في الجودة واللغة وطريقة النطق. ويؤكد المقال أن هذا الخلط ليس لتحسين الأرقام الإحصائية، بل لمنع النظام من التعوّد منذ الحقب الأولى على بيئة صوتية واحدة ولغة واحدة. وإلا فإن أي انحراف — ضوضاء أو وقفة أو مقطع بالروسية — كان سيُفسد التعرّف فورًا.
- LibriSpeech train.360 أساسًا للمدوّنة
- LibriSpeech train.100 إنجليزية نظيفة إضافية
- Russian LibriSpeech للكلام الروسي
- DisfluencySpeech بما فيه من وقفات وزلات لسان وتلعثم
لماذا كان كل شيء ينهار
كان الرهان الأول على الوصفة الأكثر بداهة: teacher forcing وخسارة cross-entropy المعتادة على النص المكتوب. كان يُمرَّر إلى النموذج اللغوي التعليمات والمتجهات الصوتية والنص الصحيح، وتُحسب الخسارة على رموز الإجابة فقط. عمليًا، كاد النظام لا «يسمع» التسجيل: كان النموذج يُخرج مقاطع غير مترابطة، وقد يعلق WER عند نحو 300%. وحتى بعد إضافة LoRA اتضح أن المشكلة أعمق: فالمُسقِط لم يكن يوصل الإشارة الصوتية إلى الموضع الذي يعرف فيه النموذج اللغوي كيف يقرأها. فقد بقي لدى Gemma prior قوي جدًا على الهندسة المألوفة لرموز النص.
بعد ذلك بدأت سلسلة من الإصلاحات الموضعية. أضاف الكاتب مرحلة صفرية تتعلّم فيها Gemma أولًا مجرد نسخ النص بحسب التعليمات، لأن النسخة المستخدمة لم تكن مضبوطة على التعليمات (instruction-tuned). ثم جاءت تجارب التكميم والتنظيم: كان من المفترض أن تُبقي commitment loss مخرجات المُسقِط قرب تضمينات معروفة، وأن يقرّب SWD توزيعات المتجهات الصوتية والنصية، وأن تُجبر entropy loss النظام على استخدام عدد أكبر من الرموز الكودية، وأن يمنع VICReg انهيار الإحداثيات المنفردة. وساعدت تصوّرات t-SNE على رؤية علّتين رئيسيتين: انهيار التمثيلات، والفجوة الهندسية بين الفضاءين الصوتي والنصي.
لكن كل إعداد جديد عالج عَرَضًا واحدًا فقط. حسّن SWD شكل التوزيع دون أن يحسّن المضمون. ووسّعت entropy loss استخدام الرموز الكودية، لكنها فعلت ذلك عشوائيًا. ورفع VICReg التباين، غير أن المتجهات تباعدت بشكل فوضوي. وظلّ النظام يجد مرة بعد مرة طريقًا ملتويًا تبدو فيه المقاييس أفضل محليًا دون أن يظهر تعرّف حقيقي. وكان هذا هو الدرس الرئيسي لمرحلة التنظيم: حين تكون الإشارة الأساسية ضعيفة، يُحسّن النموذج الرياضيات لا المعنى.
ما الذي نجح في النهاية
كان التحوّل الحاسم في التخلي عن فكرة أن المواءمة يمكن انتزاعها بعقوبات غير مباشرة وحدها. جعل الكاتب التعلّم التبايني الإشارة الرئيسية، وانتقل إلى InfoNCE المتماثل: يجب أن يكون المتجه الصوتي أقرب إلى نصّه المكتوب منه إلى سائر النصوص في الدفعة، والعكس صحيح. وعلى خلاف أساليب التنظيم السابقة، لا تفرض هذه الخسارة إحصاءات عامة، بل علاقات زوجية محددة.
ومع دفعة كبيرة، عمل ذلك بشكل أفضل بوضوح: صار منحنى الخسارة ينخفض بسلاسة ودون قفزات حادة، وانخفض WER إلى 35%. لا تزال هذه النتيجة دون مستوى أنظمة ASR التجارية، لكنها لم تعد ضجيجًا عشوائيًا. ففي السجلات بدأ النموذج يخطئ بطريقة معقولة صوتيًا: صار يلتقط جرس الكلمات، ويخلط بينها أقرب إلى شخص ضعيف السمع منه إلى مولّد نصوص معطوب. وفي المرحلة الأولى، هذا أهم من الرقم المطلق لـ WER: فقد توقف النظام عن محاكاة الإجابة وبدأ فعلًا في استخدام الصوت. وهذا ما يعدّه الكاتب العلامة الرئيسية على التقدم.
«لكن الأهم أنه صار يسمع».
ماذا يعني ذلك
تُظهر هذه الحالة بوضوح أن إضافة وسيطة صوتية منخفضة التكلفة إلى نماذج اللغة الكبيرة المحلية ممكنة، لكن ليس عبر مُسقِط MLP «سحري» كما في الأوراق البحثية. فالربط البسيط بين مُشفّر جاهز ونموذج لغوي كبير لا يبدأ بالعمل إلا حين تظهر بينهما إشارة مواءمة قوية. وهذا استنتاج مهم للمطوّرين: إذا أردت إضافة الصوت إلى نموذجك الخاص دون تدريب مكلف من الصفر، فقد تكون المرحلة التبايينة أساسًا لازمًا لا خيارًا.
Access Frontier LLMs & Multimodal AI in One Workspace
Discover NomadNet AI (nomadnet.ai) — unified access to frontier language models, research synthesis, and multimodal workflows.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.