Google تطلق Gemini Embedding 2 لتقنية RAG متعددة الوسائط تشمل الفيديو والصوت وملفات PDF
حدّثت Google عائلة نماذج التضمين (Embeddings) وأطلقت Gemini Embedding 2، وهو نموذج لا يقتصر على النص، بل يعمل أيضًا مع الصور والفيديو والصوت وملفات PDF. وهذا تحوّل مهم لأنظمة RAG: فقد أصبح بالإمكان البحث في صيغ مختلفة داخل فضاء متجهي واحد، لكن الحصول على إجابة مفيدة من LLM يظل بحاجة إلى بنية صحيحة تتضمن أوصافًا نصية منفصلة للملفات التي يعثر عليها البحث.
معالج بواسطة الذكاء الاصطناعي من Habr AI؛ بتحرير Hamidun News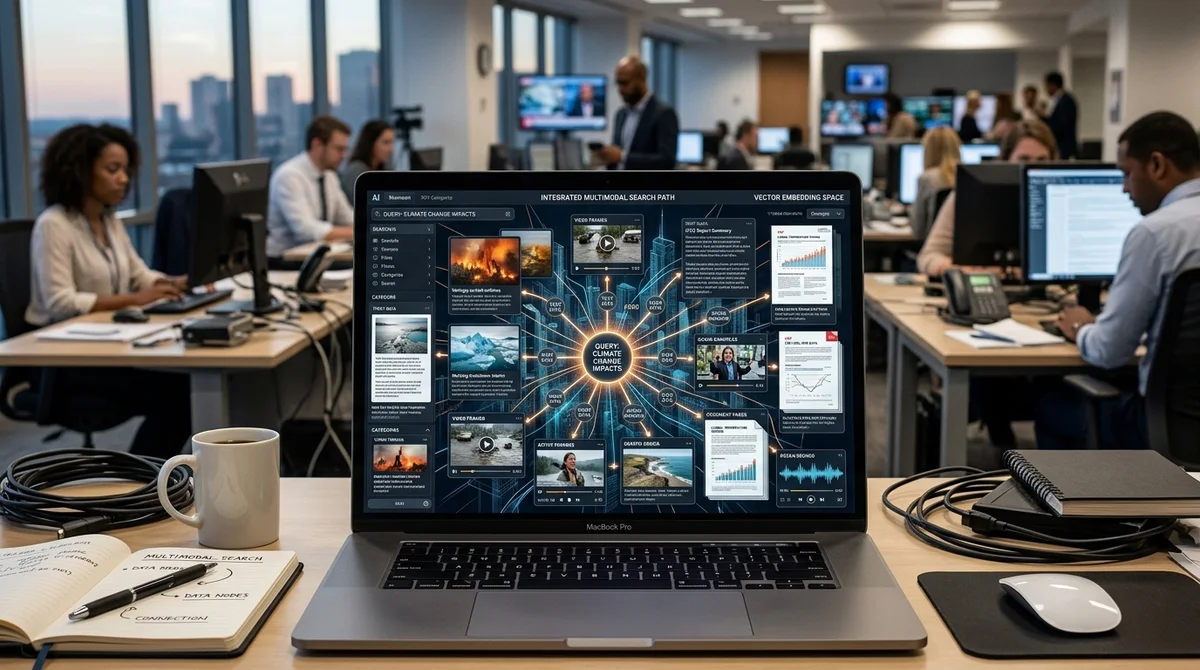
أطلقت Google نموذج Gemini Embedding 2، وهو نموذج تضمين يحوّل إلى فضاء متجهي واحد النصوص والصور والصوت والفيديو وملفات PDF. وبالنسبة إلى RAG متعدد الوسائط، تمثل هذه خطوة مهمة: فالاستعلام الواحد بات قادرًا على العثور على مقالة في قاعدة المعرفة وعلى المقطع المطلوب من فيديو تدريبي في الوقت نفسه.
ما الذي تغيّر
كان البحث في أنواع المحتوى المختلطة يعتمد سابقًا على سلسلة طويلة من التحويلات. كان لا بد من تقسيم الفيديو إلى إطارات، وتفريغ الصوت نصيًا، ووصف الصور عبر نموذج رؤية (vision)، ثم إعادة تجميع كل ذلك في نص، وبعدها فقط إرساله إلى نموذج التضمين. كان هذا الأسلوب يعمل، لكنه يفقد جزءًا من التفاصيل في كل مرحلة. فإذا أخطأ التعرف على الكلام، أو جاء وصف الإطار عامًّا أكثر من اللازم، تراجعت جودة البحث فورًا، واضطر المطوّر إلى صيانة خط معالجة (pipeline) معقّد يتألف من عدة خدمات.
مع Gemini Embedding 2 يزول جزء من هذا التعقيد. فالنموذج يستطيع استقبال الملفات الأصلية مباشرة وبناء تمثيلات للصيغ المختلفة في فضاء موحّد. وهذا يعني أن استعلامًا نصيًا مثل «كيف أضبط التفويض» قد يتطابق مع الوثائق الفنية، وكذلك مع مقطع فيديو ذي صلة أو صورة لواجهة المستخدم أو دليل تعليمات بصيغة PDF. وبالنسبة إلى الفرق التي تحتفظ بمعارفها في صيغ متفرقة، فإن هذا يرفع أحد أبرز القيود في RAG التقليدي.
كيف تبني النظام
غير أن نموذج التضمين وحده لا يجعل RAG متعدد الوسائط مفيدًا تلقائيًا. فالنموذج اللغوي الكبير لا يستطيع ببساطة «قراءة» ملف MP4 أو صورة بالطريقة التي يقرأ بها السياق النصي. لذلك تُبنى البنية العملية على مسارين: الأول مسؤول عن البحث عبر التضمينات الأصلية، والثاني عن إعداد وصف نصي للعنصر الذي جرى العثور عليه، ثم يُمرَّر هذا الوصف إلى LLM لتوليد الإجابة. وهذا الجمع بين المسارين هو ما يحوّل العرض التجريبي الجذاب إلى منتج يعمل فعليًا.
- فهرسة الملفات الأصلية مباشرة، دون تحويلات غير ضرورية
- الاحتفاظ بالأوصاف النصية والنصوص المفرَّغة والبيانات الوصفية إلى جانبها
- البحث في فضاء متجهي واحد لجميع أنواع المحتوى
- تمرير تمثيل الملف النصي وسياقه إلى LLM، لا الملف نفسه
وعلى مستوى التطبيق العملي، ينسجم هذا جيدًا مع حزمة RAG المعتادة: Python لخط المعالجة، وGemini API للتضمينات ولتوليد الأوصاف، وSupabase أو أي قاعدة بيانات متجهية أخرى لتخزين الفهارس. ويتيح هذا النهج البحث في آن واحد في قاعدة المعرفة ولقطات الشاشة والعروض التقديمية ومقاطع الفيديو الداخلية، دون أن يضطر المستخدم إلى التفكير في الصيغة التي تحتفظ بالإجابة المطلوبة. وعلى مستوى المنتج، لم يعد هذا بحثًا في المستندات فحسب، بل نقطة وصول موحّدة إلى معارف الشركة.
أين تكمن نقاط الاختناق
لم يختفِ القيد الرئيسي: فالعنصر الوسائطي الذي يعثر عليه النظام لا يزال بحاجة إلى شرح للنموذج وللإنسان معًا. فإذا أعاد النظام مقطع فيديو ولم يعرف في أي جزء منه توجد الإجابة، فسيحصل المستخدم مع ذلك على نتيجة ضعيفة. ولهذا لم تعد جودة RAG متعدد الوسائط تعتمد على التضمينات وحدها، بل أيضًا على مدى إتقان التقسيم (segmentation) والتوصيف وربط الطبقة النصية بالملف الأصلي.
استعلام «كيف أضبط التفويض» قد يعيد مقالة، ومعها المقطع المطلوب من الفيديو.
ومن هنا تنشأ متطلبات هندسية أيضًا: يجب التخطيط لتقسيم الفيديو والصوت إلى مقاطع (chunking)، وتحديث الأوصاف عند استبدال الملفات، وتخزين الأختام الزمنية (timecodes)، فضلًا عن ضبط التكاليف. فالبحث الأصلي متعدد الوسائط يقلّل فقدان المعلومات، لكنه لا يلغي الحاجة إلى بيانات جيدة. وإذا كانت الأوصاف ضعيفة، فلن يتمكن LLM من تركيب إجابة بثقة حتى لو أصاب البحث الهدف بدقة. ولذلك تتجلى القيمة الأساسية لـ Gemini Embedding 2 حيث يكون الفريق مستعدًا لبناء فهرس متكامل، لا مجرد رفع الملفات وانتظار المعجزة.
ماذا يعني ذلك
بالنسبة إلى قواعد المعرفة المؤسسية والدعم الفني وتأهيل الموظفين الجدد ومنصات التعليم، يمثل هذا تحوّلًا ملحوظًا. فـ Google تقرّب RAG من سيناريو تصبح فيه النصوص والمرئيات والفيديو مصادر متكافئة للإجابة. ولن يكون الفائز من يملك ملفات أكثر، بل من يربط البحث متعدد الوسائط بطبقة نصية واضحة مخصصة لـ LLM على النحو الصحيح.
- 6 نوفمبر 2026مدوّن يستخدم Claude Code لإضافة أصوات روسية إلى GTA V بتكلفة $60: 250 ألف جملة
- 6 نوفمبر 2026ثانية الفيديو بالذكاء الاصطناعي في المقطع النهائي تكلّف $0,186 لا $0,10 كما في قائمة الأسعار
- 6 نوفمبر 2026QVikhr-3-4B على خادم VPS بـ1,5 ألف ₽ ودون GPU صنّفت 20 طلبًا من أصل 20 تصنيفًا صحيحًا
- 6 نوفمبر 2026إضافة Keystone تعلّم Claude Code نشر بوابة LLM: 8 مهارات ومفاتيح خارج المحادثة
أسئلة وأجوبة حول الخبر
ما أبرز التفاصيل حول ما الذي تغيّر؟
كان البحث في أنواع المحتوى المختلطة يعتمد سابقًا على سلسلة طويلة من التحويلات. كان لا بد من تقسيم الفيديو إلى إطارات، وتفريغ الصوت نصيًا، ووصف الصور عبر نموذج رؤية (vision)، ثم إعادة تجميع كل ذلك في نص، وبعدها فقط إرساله إلى نموذج التضمين. كان هذا الأسلوب يعمل، لكنه يفقد جزءًا من التفاصيل في كل مرحلة. فإذا أخطأ التعرف على الكلام، أو جاء وصف الإطار عامًّا أكثر من اللازم، تراجعت جودة البحث فورًا، واضطر المطوّر إلى صيانة خط معالجة (pipeline) معقّد يتألف من عدة خدمات. مع Gemini Embedding 2 يزول جزء من هذا التعقيد.
ما أبرز التفاصيل حول كيف تبني النظام؟
غير أن نموذج التضمين وحده لا يجعل RAG متعدد الوسائط مفيدًا تلقائيًا. فالنموذج اللغوي الكبير لا يستطيع ببساطة «قراءة» ملف MP4 أو صورة بالطريقة التي يقرأ بها السياق النصي. لذلك تُبنى البنية العملية على مسارين: الأول مسؤول عن البحث عبر التضمينات الأصلية، والثاني عن إعداد وصف نصي للعنصر الذي جرى العثور عليه، ثم يُمرَّر هذا الوصف إلى LLM لتوليد الإجابة. وهذا الجمع بين المسارين هو ما يحوّل العرض التجريبي الجذاب إلى منتج يعمل فعليًا.
ما أبرز التفاصيل حول أين تكمن نقاط الاختناق؟
لم يختفِ القيد الرئيسي: فالعنصر الوسائطي الذي يعثر عليه النظام لا يزال بحاجة إلى شرح للنموذج وللإنسان معًا. فإذا أعاد النظام مقطع فيديو ولم يعرف في أي جزء منه توجد الإجابة، فسيحصل المستخدم مع ذلك على نتيجة ضعيفة. ولهذا لم تعد جودة RAG متعدد الوسائط تعتمد على التضمينات وحدها، بل أيضًا على مدى إتقان التقسيم (segmentation) والتوصيف وربط الطبقة النصية بالملف الأصلي. استعلام «كيف أضبط التفويض» قد يعيد مقالة، ومعها المقطع المطلوب من الفيديو.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.