Google تطلق WAXAL: مجموعة بيانات صوتية مفتوحة للغات الأفريقية
فتحت Google مجموعة WAXAL، وهي مجموعة بيانات صوتية للغات الأفريقية يُفترض أن تسرّع تطوير تقنيات التعرف على الكلام وتوليفه في فئة اللغات منخفضة الموارد. وفي جزء التعرف على الكلام، جُمع كلام طبيعي عبر وصف الصور، أما في جزء توليف الكلام فاعتُمدت تسجيلات أنقى بُنيت على نصوص متوازنة. وتشير Google أيضًا إلى أن المشروع يتوسع بالفعل، وأنه يشمل عشرات اللغات، وأنه سيُستكمل بمزيد من البيانات لاحقًا.
معالج بواسطة الذكاء الاصطناعي من MarkTechPost؛ بتحرير Hamidun News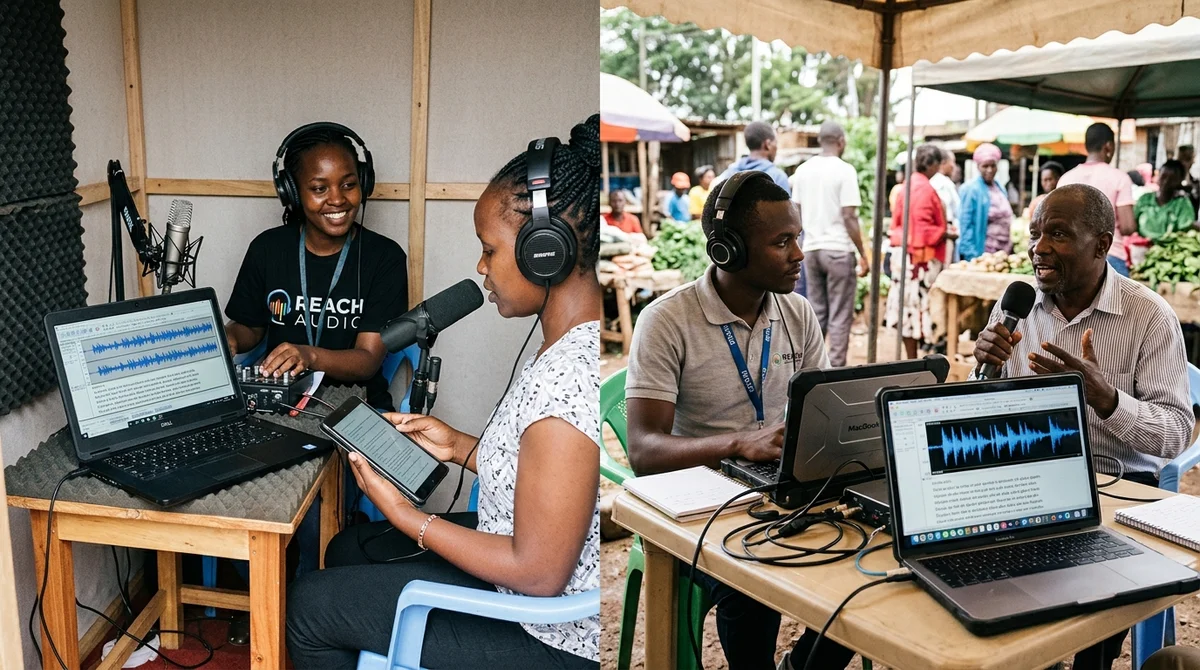
فتحت Google مجموعة WAXAL، وهي مدونة صوتية كبيرة للغات الأفريقية، أُنشئت لتكون قاعدة لأنظمة التعرف على الكلام وتوليفه. يستهدف المشروع سوقًا تتطور فيها التقنيات الصوتية بوتيرة أبطأ بكثير بسبب النقص المزمن في البيانات المفتوحة عالية الجودة.
لماذا يهم ذلك
لم تعد المشكلة الرئيسية في الذكاء الاصطناعي الصوتي منذ زمن في النماذج نفسها، بل في توزيع البيانات. فالإنجليزية والإسبانية والصينية تتوافر لها مدونات ضخمة مفتوحة وتجارية، ولذلك تتقدم أنظمة التعرف على الكلام وتوليف الصوت فيها بسرعة. أما في كثير من اللغات الأفريقية فالوضع معاكس: كلام موسوم قليل، وتسجيلات عالية الجودة قليلة، وتراخيص مفتوحة قليلة. ولهذا لا يزال الناطقون بلغات يتحدثها ملايين الأشخاص يحصلون على جودة أسوأ في الإملاء الصوتي والترجمة النصية التلقائية والمساعدات الصوتية والتعليق الصوتي للواجهات. وتحاول WAXAL سد هذه الفجوة في البنية التحتية تحديدًا.
ومن اللافت أن المشروع يبدو حيًّا لا أرشيفًا ثابتًا. ففي الوصف التقني يتحدث الفريق عن 24 لغة ومجموعة أولية لمهام التعرف على الكلام وتوليفه. أما في مدونة الإصدار التي نشرتها Google بتاريخ 6 مارس 2026 فتظهر دفعة أولى موسّعة: 27 لغة، وأكثر من 1 846 ساعة من البيانات للتعرف على الكلام، وأكثر من 565 ساعة لتوليفه. أي أن Google لم تنشر مجموعة بيانات واحدة فحسب، بل يبدو أنها تبني قاعدة مفتوحة طويلة الأمد للغات التي تبقى عادةً خارج المنصات الكبرى للذكاء الاصطناعي.
كيف صُمّمت WAXAL
قُسّمت WAXAL إلى جزأين مستقلين، لأن التعرف على الكلام وتوليف الصوت يتطلبان بيانات بمواصفات مختلفة. فالأول يحتاج إلى متحدثين متنوعين وبيئة طبيعية وكلام عفوي كي يعمل النموذج بصورة أفضل في الظروف الواقعية. أما الثاني فيحتاج إلى صوت أنقى ونصوص متوازنة صوتيًّا وتسجيل خاضع للتحكم، وإلا يصعب الحصول على صوت طبيعي ومستقر. وبهذا المعنى لا تبدو WAXAL «مجلدًا صوتيًّا» عامًّا، بل مجموعة بيانات مدروسة لفئتين مختلفتين من المهام.
- في جزء التعرف على الكلام، طُلب من المشاركين وصف الصور بلغتهم الأم بدلًا من قراءة نصوص جاهزة.
- تكتب Google أن هذه المحفّزات غطّت أكثر من 50 موضوعًا، وأنها استخرجت الكلام الحيّ على نحو أفضل، بما يشمل الفروق النغمية والتبديل بين اللغات.
- في جزء توليف الكلام استُخدمت نصوص متوازنة صوتيًّا وظروف تسجيل أكثر خضوعًا للتحكم.
- نُشرت مجموعة البيانات بترخيص مفتوح CC-BY-4.0 ليكون استخدامها ممكنًا في الأبحاث والمنتجات التطبيقية.
من جمع البيانات
الجزء الأساسي في المشروع ليس الحجم وحده، بل طريقة الجمع أيضًا. فلم تعمل Google بمفردها، بل مع جامعات أفريقية ومنظمات محلية، من بينها Makerere University وUniversity of Ghana وDigital Umuganda وAfrican Institute for Mathematical Sciences Senegal وMedia Trust وLoud and Clear Communications. وتكمن أهمية هذا النموذج في أن الفرق المحلية أدرى بالعادات الكلامية، وبمزج اللغات، واللهجات الإقليمية في النطق، والسياقات التي يتحدث فيها الناس فعلًا، لا التي يقرؤون فيها نصًّا في صمت المختبر.
«أُنشئت المدونة بيد المجتمع ولأجل المجتمع الذي يحتاج إليها».
وتفاصيل الإنتاج لافتة أيضًا. ففي جزء TTS أعدّ المشاركون نصوصًا بحجم يتراوح بين 10 و20 ألف كلمة، وعملوا في أزواج: يقرأ أحدهما ويسجّل الآخر ويتحقق من الجودة. وللحصول على صوت أنقى، صنعت بعض الفرق بنفسها صناديق تسجيل استوديوية. وتشدد Google على أن WAXAL يجب أن يفيد لا المقاييس الأكاديمية فحسب، بل السيناريوهات الواقعية أيضًا: الواجهات الصوتية المحلية، والإملاء الآلي، والتفريغ النصي التلقائي، والتعليق الصوتي للخدمات، وأنظمة المحادثة التي ينبغي أن تفهم الكلام الحيّ لا النص المقروء بإتقان فحسب.
وفي موازاة ذلك، بدأ يتشكل حول المدونة نظام تطبيقي وبحثي. إذ تذكر Google أعمالًا لجمع بيانات لأشخاص يعانون اضطرابات في الكلام، ومدونة كبيرة منفصلة لخمس لغات غانية، ومقاييس أداء لنماذج مثل Whisper وXLS-R وMMS وW2v-BERT على اللغات الأفريقية. وهذه إشارة جيدة: فـWAXAL مفيدة لا كأرشيف فحسب، بل كنقطة ارتكاز مشتركة يمكن عليها مقارنة النماذج وكشف نقاط الضعف وإيصال المنتجات الصوتية إلى جودة عملية أسرع.
ماذا يعني ذلك
تخفّض WAXAL عتبة الدخول أمام الشركات الناشئة والباحثين والفرق المحلية الراغبة في بناء ذكاء اصطناعي صوتي لا يقتصر على اللغات العالمية. وإذا نمت مثل هذه المدونات المفتوحة وتحدّثت بانتظام، فستتاح للغات الأفريقية فرصة لتلحق بسرعة أكبر ببقية السوق من حيث جودة التعرف على الكلام وتوليفه وإتاحة الخدمات الرقمية.
- 2 نوفمبر 2026وكيل LLM يبني مخفِّض سرعة في КОМПАС-3D، لكنه يحصل على 50 من 100 في جدول المواصفات
- 2 نوفمبر 2026كارباثي يبني كتالوج HackerTube من 6 454 مقطع فيديو في ساعتين بمساعدة Claude Code
- 2 نوفمبر 2026اختبرنا 929 عملية أتمتة في «Alpina»: كيف يجب أن يبدو التدريب المؤسسي على الذكاء الاصطناعي في عام 2026
- 2 نوفمبر 2026استجوبتُ 6 نماذج ذكاء اصطناعي عن نفسي بعيون مسؤول المشتريات: Amazon والباطنية و«Telo Hudelo» و5 ثغرات أغلقناها في يوم واحد
أسئلة وأجوبة حول الخبر
ما أبرز التفاصيل حول لماذا يهم ذلك؟
لم تعد المشكلة الرئيسية في الذكاء الاصطناعي الصوتي منذ زمن في النماذج نفسها، بل في توزيع البيانات. فالإنجليزية والإسبانية والصينية تتوافر لها مدونات ضخمة مفتوحة وتجارية، ولذلك تتقدم أنظمة التعرف على الكلام وتوليف الصوت فيها بسرعة. أما في كثير من اللغات الأفريقية فالوضع معاكس: كلام موسوم قليل، وتسجيلات عالية الجودة قليلة، وتراخيص مفتوحة قليلة. ولهذا لا يزال الناطقون بلغات يتحدثها ملايين الأشخاص يحصلون على جودة أسوأ في الإملاء الصوتي والترجمة النصية التلقائية والمساعدات الصوتية والتعليق الصوتي للواجهات.
ما أبرز التفاصيل حول كيف صُمّمت WAXAL؟
قُسّمت WAXAL إلى جزأين مستقلين، لأن التعرف على الكلام وتوليف الصوت يتطلبان بيانات بمواصفات مختلفة. فالأول يحتاج إلى متحدثين متنوعين وبيئة طبيعية وكلام عفوي كي يعمل النموذج بصورة أفضل في الظروف الواقعية. أما الثاني فيحتاج إلى صوت أنقى ونصوص متوازنة صوتيًّا وتسجيل خاضع للتحكم، وإلا يصعب الحصول على صوت طبيعي ومستقر. وبهذا المعنى لا تبدو WAXAL «مجلدًا صوتيًّا» عامًّا، بل مجموعة بيانات مدروسة لفئتين مختلفتين من المهام. في جزء التعرف على الكلام، طُلب من المشاركين وصف الصور بلغتهم الأم بدلًا من قراءة نصوص جاهزة.
ما أبرز التفاصيل حول من جمع البيانات؟
الجزء الأساسي في المشروع ليس الحجم وحده، بل طريقة الجمع أيضًا. فلم تعمل Google بمفردها، بل مع جامعات أفريقية ومنظمات محلية، من بينها Makerere University وUniversity of Ghana وDigital Umuganda وAfrican Institute for Mathematical Sciences Senegal وMedia Trust وLoud and Clear Communications. وتكمن أهمية هذا النموذج في أن الفرق المحلية أدرى بالعادات الكلامية، وبمزج اللغات، واللهجات الإقليمية في النطق، والسياقات التي يتحدث فيها الناس فعلًا، لا التي يقرؤون فيها نصًّا في صمت المختبر.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.