هارفارد: الذكاء الاصطناعي أدق من الأطباء في الفرز الطارئ للمرضى بقسم الاستقبال
قارنت هارفارد ومركز Beth Israel Deaconess الطبي نموذج OpenAI o1 بالأطباء على حالات حقيقية من قسم الاستقبال. وفي مرحلة الفرز الأولي، قدّم النموذج تشخيصًا دقيقًا أو قريبًا من الصحيح في 67% من الحالات، مقابل 50–55% لدى الأطباء. لكن الأمر لا يتعلق باستبدال الطبيب حتى الآن. فقد قيّمت الدراسة الاستدلال السريري النصي فقط، ولم تشمل الفحص الكامل للمريض ولا التواصل معه ولا القرارات التي تُتخذ بجوار السرير.
معالج بواسطة الذكاء الاصطناعي من Guardian؛ بتحرير Hamidun News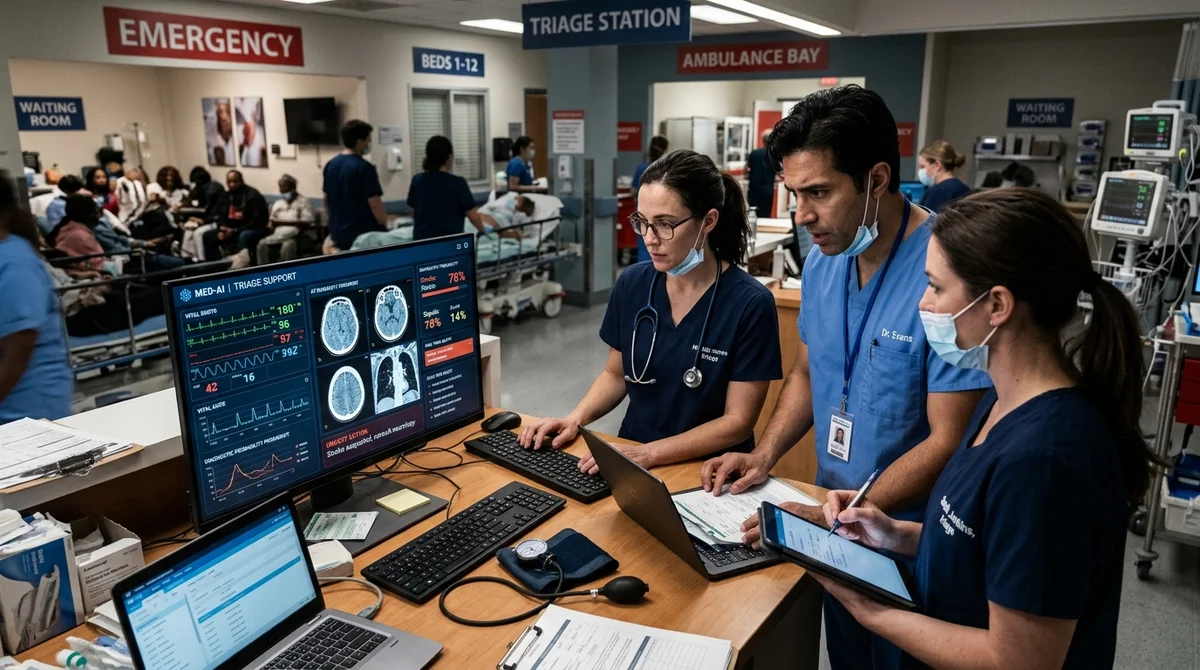
أعلن فريق من كلية الطب بجامعة هارفارد ومركز Beth Israel Deaconess الطبي أن نموذج الاستدلال OpenAI o1 أظهر دقة أعلى من الأطباء في عدد من مهام التشخيص الطارئ. وجاءت النتيجة الأبرز في مرحلة الفرز الأولي بقسم الاستقبال، حيث تكون البيانات شحيحة والقرار مطلوبًا بسرعة.
كيف جرت المقارنة
نُشرت الدراسة في 30 أبريل 2026 في مجلة Science، وتُعدّ من أكبر المحاولات لمقارنة الذكاء الاصطناعي لا بالاختبارات الامتحانية، بل بالعمل السريري الفعلي. وأخضع الباحثون النموذج لست تجارب، تراوحت بين حالات تشخيصية معقدة والاستدلال الاحتمالي ومهام اختيار المسار العلاجي اللاحق.
والجزء الأساسي من العمل هو 76 حالة حقيقية من قسم الاستقبال في مستشفى ببوسطن. وتلقّى النموذج والأطباء السجلات نفسها من الملف الطبي الإلكتروني، وطُلب منهم اقتراح التشخيصات الأكثر احتمالًا والخطوات التالية.
ومن المهم أن البيانات لم تُنقَّح تقريبًا قبل الاختبار. فقد استخدم الباحثون النص نفسه، المشوَّش وغير المكتمل، الذي يراه الطبيب في الدقائق الأولى: المؤشرات الحيوية، والعمر، ووصفًا موجزًا للشكاوى من الممرضة، وملاحظات متفرقة من التاريخ المرضي.
جرى التقييم على ثلاث مراحل: لحظة الفرز، وعند أول تواصل مع الطبيب، وعند اتخاذ قرار الإدخال إلى جناح المستشفى أو العناية المركزة. ولم يكن المقيّمون يعلمون من قدّم الإجابة، الإنسان أم النموذج.
أين تفوّق الذكاء الاصطناعي
ظهر التفوق الأوضح للنموذج تحديدًا حيث تكون معلومات الطبيب أقل ما يمكن. ففي الفرز المبكر، قدّم OpenAI o1 تشخيصًا دقيقًا أو قريبًا جدًا من الصحيح في 67% من الحالات. أما الأطباء فتراوحت نسبتهم على المجموعة نفسها من المرضى بين 50 و55%.
ومع توفّر مزيد من البيانات، ارتفعت دقة الذكاء الاصطناعي إلى 82%، وارتفعت لدى البشر إلى 70–79%. وفي هذه المرحلة لم يعد الفارق ذا دلالة إحصائية، لكن الاتجاه العام بقي كما هو. وفي مهام خطة التعامل مع الحالة، بما في ذلك اختيار الفحوص والمضادات الحيوية ومناقشة أهداف العلاج، تفوّق النموذج كذلك بوضوح.
- 67% — تشخيص دقيق أو قريب من الصحيح لدى الذكاء الاصطناعي في الفرز الأولي
- 50–55% — نتيجة الأطباء في المرحلة نفسها
- 82% — دقة الذكاء الاصطناعي بعد وصول بيانات إضافية
- 89% — تقييم النموذج في مهام تكتيكات إدارة الحالة، مقابل 34% لدى الأطباء
وساق المؤلفون مثالًا لافتًا. ففي إحدى الحالات وصل مريض يعاني من جلطة في الرئة وتدهور في حالته. افترض الأطباء أن العلاج القياسي بمضادات التخثر لم يُجْدِ. أما النموذج فربط الصورة السريرية بإصابة المريض بالذئبة في تاريخه المرضي، وافترض أن مصدر المشكلة التهاب رئوي ناتج عن هذه الخلفية. وتأكدت هذه الفرضية لاحقًا. ويشير الباحثون بشكل منفصل إلى أن النموذج عمل بثقة خاصة مع الحالات النادرة والمعقدة.
لماذا لا يعني هذا استبدال الأطباء
لا تعني هذه النتائج أنه يمكن تحويل قسم الاستقبال إلى الطيار الآلي. فقد اختبرت الدراسة قبل كل شيء الجزء النصي من الاستدلال السريري: قراءة الملف الطبي، وبناء التشخيص التفريقي، واقتراح الخطوة التالية. ولم يفحص الذكاء الاصطناعي المريض، ولم يرَ تعبير الألم على وجهه، ولم يصغِ إلى تنفسه، ولم يقيّم مشيته، ولم يتعامل مع صور الأشعة وتخطيط القلب كما يفعل الطبيب بجوار السرير.
وذكّر خبراء من خارج الدراسة بأن الأمر أقرب إلى «رأي ثانٍ أعمى» مبني على النص، لا إلى إدارة كاملة للمريض في الوقت الفعلي.
«نحن نشهد تحولًا تقنيًا عميقًا حقًا سيغيّر الطب»، قال أرجون مانراي،
أحد المشاركين في إعداد الدراسة.
لكن المؤلفين أنفسهم يشدّدون في الوقت ذاته على القيود. فحتى لو كان النموذج يصيب التشخيص الرئيسي بوتيرة أعلى، فقد يقترح فحوصات أو تدخلات غير ضرورية قد تضرّ بالمريض. كما لا يوجد حتى الآن نظام واضح للمسؤولية: من يتحمّل مسؤولية الخطأ إذا وثق الطبيب بتوصية الخوارزمية؟
ولهذا يتحدث الباحثون لا عن استبدال الطبيب، بل عن صيغة جديدة للعمل المشترك، يؤدي فيها الذكاء الاصطناعي دور المحلل السريع ومصدر الرأي الثاني، بينما يبقى القرار النهائي بيد الإنسان.
ماذا يعني ذلك
بالنسبة إلى الطب، هذه إشارة إلى أن النماذج اللغوية الكبيرة تخرج من مرحلة العروض التوضيحية وتقترب من الاختبار السريري الحقيقي. والسيناريو الأقرب ليس «طبيبًا آليًا» مستقلًا بلا بشر، بل أنظمة تراجع السجلات الإلكترونية في الخلفية، وتنبّه إلى احتمالات تشخيصية فاتت الأطباء، وتساعد في ترتيب الأولويات بسرعة أكبر في قسم الاستقبال.
والمرحلة التالية باتت واضحة: ليست معايير اختبار جديدة، بل تجارب سريرية استباقية لا تنظر إلى دقة الإجابة فحسب، بل أيضًا إلى السلامة والتكلفة وتأثير ذلك على نتائج العلاج.
- 28 أكتوبر 2026Wired تختبر 6 وكلاء ذكاء اصطناعي خلال يوم: Dots في الصدارة وGemini Spark يفشل في طلب الغداء
- 28 أكتوبر 2026Anthropic تحوّل Claude Code إلى منصة: Claude Mods تقلب طبقة تشغيل الوكيل رأساً على عقب
- 28 أكتوبر 2026Liquid AI تطلق LFM2.5-24B-A2B: وكيل ذكي بمعاملات نشطة لا تتجاوز 2B
- 28 أكتوبر 2026OpenAI تطلق Decisions API: قرارات الوكلاء أسرع بما يصل إلى 10 مرات
أسئلة وأجوبة حول الخبر
ما أبرز التفاصيل حول كيف جرت المقارنة؟
نُشرت الدراسة في 30 أبريل 2026 في مجلة Science، وتُعدّ من أكبر المحاولات لمقارنة الذكاء الاصطناعي لا بالاختبارات الامتحانية، بل بالعمل السريري الفعلي. وأخضع الباحثون النموذج لست تجارب، تراوحت بين حالات تشخيصية معقدة والاستدلال الاحتمالي ومهام اختيار المسار العلاجي اللاحق. والجزء الأساسي من العمل هو 76 حالة حقيقية من قسم الاستقبال في مستشفى ببوسطن. وتلقّى النموذج والأطباء السجلات نفسها من الملف الطبي الإلكتروني، وطُلب منهم اقتراح التشخيصات الأكثر احتمالًا والخطوات التالية. ومن المهم أن البيانات لم تُنقَّح تقريبًا قبل الاختبار. فقد استخدم الباحثون النص نفسه، المشوَّش وغير الم
ما أبرز التفاصيل حول أين تفوّق الذكاء الاصطناعي؟
ظهر التفوق الأوضح للنموذج تحديدًا حيث تكون معلومات الطبيب أقل ما يمكن. ففي الفرز المبكر، قدّم OpenAI o1 تشخيصًا دقيقًا أو قريبًا جدًا من الصحيح في 67% من الحالات. أما الأطباء فتراوحت نسبتهم على المجموعة نفسها من المرضى بين 50 و55%. ومع توفّر مزيد من البيانات، ارتفعت دقة الذكاء الاصطناعي إلى 82%، وارتفعت لدى البشر إلى 70–79%. وفي هذه المرحلة لم يعد الفارق ذا دلالة إحصائية، لكن الاتجاه العام بقي كما هو. وفي مهام خطة التعامل مع الحالة، بما في ذلك اختيار الفحوص والمضادات الحيوية ومناقشة أهداف العلاج، تفوّق النموذج كذلك بوضوح. 67% — تشخيص دقيق أو قريب من الصحيح لدى الذكاء الاصطن
ما أبرز التفاصيل حول لماذا لا يعني هذا استبدال الأطباء؟
لا تعني هذه النتائج أنه يمكن تحويل قسم الاستقبال إلى الطيار الآلي. فقد اختبرت الدراسة قبل كل شيء الجزء النصي من الاستدلال السريري: قراءة الملف الطبي، وبناء التشخيص التفريقي، واقتراح الخطوة التالية. ولم يفحص الذكاء الاصطناعي المريض، ولم يرَ تعبير الألم على وجهه، ولم يصغِ إلى تنفسه، ولم يقيّم مشيته، ولم يتعامل مع صور الأشعة وتخطيط القلب كما يفعل الطبيب بجوار السرير. وذكّر خبراء من خارج الدراسة بأن الأمر أقرب إلى «رأي ثانٍ أعمى» مبني على النص، لا إلى إدارة كاملة للمريض في الوقت الفعلي. «نحن نشهد تحولًا تقنيًا عميقًا حقًا سيغيّر الطب»، قال أرجون مانراي، أحد المشاركين في إعداد ا
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.