OTUS: لماذا تهلوس النماذج اللغوية وما الإجراءات التي تقلّل مخاطر الأخطاء
هلوسات LLM ليست خللًا نادرًا، بل قيد منهجي في الذكاء الاصطناعي التوليدي. توضح OTUS لماذا تخلط النماذج الحقائق بثقة، وتختلق المصادر، وترتكب أخطاء في الشيفرة البرمجية والدعم والتحليلات، ولماذا لا يحلّ الضبط الدقيق (fine-tuning) المشكلة بالكامل. والخلاصة العملية بسيطة: تحتاج كل السيناريوهات الحرجة إلى retrieval والتحقق من الصحة وحالات اختبار ومراقبة وإشراف بشري ضمن حلقة العمل (human-in-the-loop).
معالج بواسطة الذكاء الاصطناعي من Habr AI؛ بتحرير Hamidun News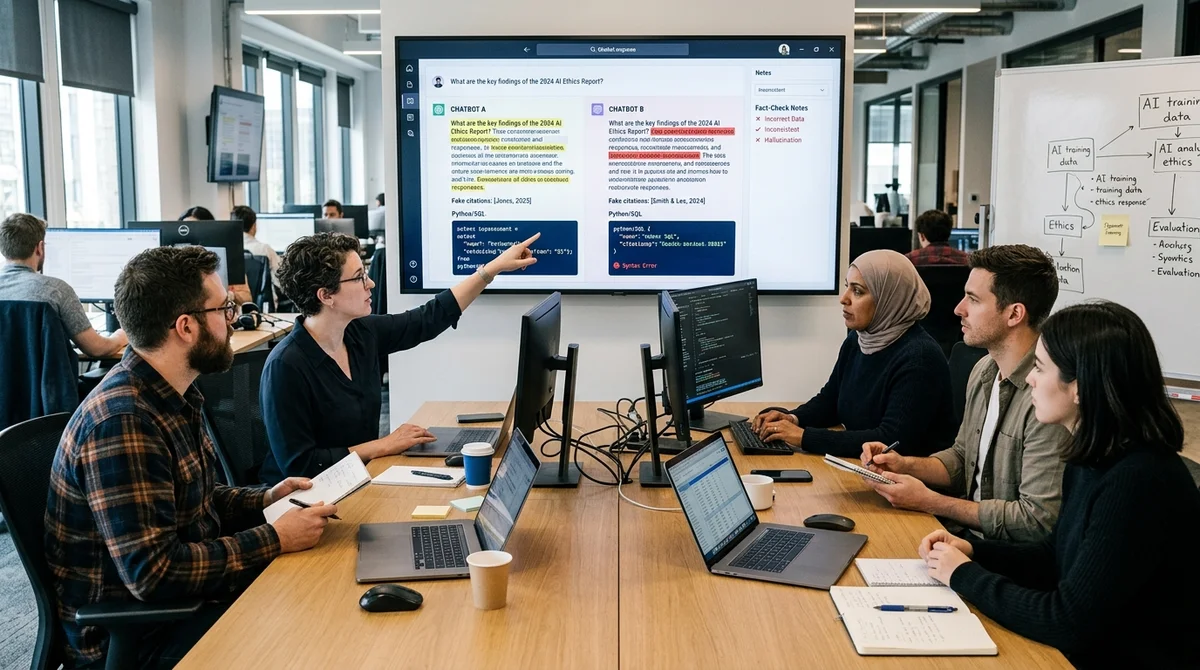
هلوسات النماذج اللغوية ليست عطلًا نادرًا، بل خاصية أساسية في الذكاء الاصطناعي التوليدي: فقد يبدو النظام واثقًا حتى حيث لا تتوافر لديه أي حقائق. وبالنسبة إلى الفرق التي تدمج LLM في المنتجات أو الدعم أو التحليلات أو العمليات الداخلية، لا يعني ذلك مجرد عدم دقة، بل مخاطرة تشغيلية محددة.
من أين يأتي الخطأ
لا تتحقق النماذج اللغوية من الحقيقة كما يفعل الإنسان أو محرك البحث. مهمتها أن تتنبأ بالاستمرار الأكثر احتمالًا للنص استنادًا إلى مجموعة ضخمة من البيانات والروابط الإحصائية بين الكلمات. وإذا نقص السياق في الطلب، أو كانت صياغته ملتبسة، أو قلّت الأمثلة الموثوقة في بيانات التدريب، يظل النموذج يسعى إلى تقديم إجابة متماسكة. ومن هنا ينشأ ما يراه المستخدمون كذبًا: النص يبدو منطقيًا، والنبرة واثقة، أما الحقائق فقد تكون مختلَقة أو مخلوطة ببعضها.
وتتفاقم المشكلة في السيناريوهات التي يُنتظر فيها من النموذج روابط دقيقة أو أرقام أو صياغات قانونية أو توصيات طبية أو شيفرة برمجية. ففي هذه المهام قد لا يكتفي LLM بخلط المصدر، بل يستكمل التفاصيل الناقصة وفق قالب جاهز: يختلق دراسة، أو يستشهد بقانون غير موجود، أو يذكر إصدارًا خاطئًا من API، أو يقترح مقطعًا برمجيًا يبدو سليمًا لكنه غير آمن. وكلما بدت الإجابة معقولة في ظاهرها، زاد احتمال أن يمرّ الخطأ إلى مراحل لاحقة من العملية دون فحص.
لماذا لا يكفي الضبط الدقيق
فكرة «لنُعد تدريب النموذج فقط ونتخلص من الهلوسات» تنجح جزئيًا فقط. فالضبط الدقيق يساعد فعلًا في تحسين سلوك النموذج في مجال محدد، والالتزام بصيغة الإجابة، وتقليل الانزلاق إلى الخيال الواضح. لكنه لا يحوّل النموذج إلى نظام لا يعرف سوى الحقائق الموثَّقة، ولا يضمن أن يتوقف عند نقص البيانات. فالنموذج لا يزال يُحسَّن لإنتاج نص مقنع، لا لصحة كل عبارة.
وحتى النماذج الكبيرة المضبوطة جيدًا تواصل الخطأ في الحالات النادرة والأحداث الحديثة والموضوعات شديدة التخصص وسلاسل الاستدلال الطويلة. وكلما زادت الخطوات بين السؤال والجواب، زادت فرص ظهور افتراض غير دقيق في إحدى الحلقات. ولذلك لا تُحل المشكلة بضبط درجة الحرارة (temperature) وحدها، ولا بمجموعة بيانات جديدة واحدة، ولا بموجّه سحري. المطلوب بنية لا يكون فيها النموذج المصدر الوحيد للحقيقة، ولا يتخذ فيها قرارات حرجة دون سند خارجي.
كيف نقلّل المخاطر
النهج العملي ليس انتظار سلوك مثالي من LLM، بل بناء طبقات حماية حوله. وكلما ارتفعت كلفة الخطأ على الأعمال، وجب أن يتضمن خط المعالجة (pipeline) مزيدًا من الفحوص والقيود والقواعد الصريحة للامتناع عن الإجابة. وهذا يغيّر منطق التبنّي: بدل السؤال «كيف نجعل النموذج لا يخطئ أبدًا» يظهر سؤال آخر: كيف نمنع الخطأ من أن يتحول إلى حادثة. وهذه مسألة تصميم نظام، لا سحر نموذج.
- ربط retrieval وإلزام النموذج بالإجابة فقط استنادًا إلى المستندات التي عُثر عليها
- اشتراط الإحالة إلى مقاطع محددة من البيانات، لا إلى مصادر مجرّدة
- الفصل بين التوليد والتحقق: خطوة تكتب الإجابة وأخرى تتحقق من الحقائق والصيغة
- تضييق نطاق المهمة حتى لا يرتجل النموذج خارج مجاله
- إضافة إشراف بشري ضمن الحلقة (human-in-the-loop) للسيناريوهات القانونية والمالية والطبية وسيناريوهات الإنتاج (production)
وتكتسب المراقبة والاختبار أهمية خاصة. يحتاج الفريق إلى مجموعات من حالات الفحص، ومقاييس بحسب أنواع الأخطاء، وسجل للحالات التي امتنع فيها النموذج عن الإجابة أو قدّم نتيجة خاطئة. ومن المفيد مقارنة سلوك LLM بقواعد حتمية تقليدية، لمعرفة أين تسرّع الأتمتة العمل فعلًا وأين تخلق مخاطر خفية. وإذا كان النظام يكتب شيفرة أو يتواصل مع العملاء أو يستخلص استنتاجات من البيانات، فيجب تحليل أخطائه بالمنهجية نفسها التي تُتبع مع الأخطاء البرمجية في أي منتج عادي.
ماذا يعني ذلك
الهلوسات ليست استثناءً مزعجًا، بل قيد ملازم لهذه الفئة من التقنيات. لذلك لن يربح الفرق التي تثق دون تمحيص بإجابة تبدو ذكية، بل التي تصمّم LLM بوصفه مكوّنًا احتماليًا، مع فحوص وحدود استخدام واضحة وكلفة معروفة للخطأ.
أسئلة وأجوبة حول الخبر
ما أبرز التفاصيل حول من أين يأتي الخطأ؟
لا تتحقق النماذج اللغوية من الحقيقة كما يفعل الإنسان أو محرك البحث. مهمتها أن تتنبأ بالاستمرار الأكثر احتمالًا للنص استنادًا إلى مجموعة ضخمة من البيانات والروابط الإحصائية بين الكلمات. وإذا نقص السياق في الطلب، أو كانت صياغته ملتبسة، أو قلّت الأمثلة الموثوقة في بيانات التدريب، يظل النموذج يسعى إلى تقديم إجابة متماسكة. ومن هنا ينشأ ما يراه المستخدمون كذبًا: النص يبدو منطقيًا، والنبرة واثقة، أما الحقائق فقد تكون مختلَقة أو مخلوطة ببعضها. وتتفاقم المشكلة في السيناريوهات التي يُنتظر فيها من النموذج روابط دقيقة أو أرقام أو صياغات قانونية أو توصيات طبية أو شيفرة برمجية. ففي هذه ا
ما أبرز التفاصيل حول لماذا لا يكفي الضبط الدقيق؟
فكرة «لنُعد تدريب النموذج فقط ونتخلص من الهلوسات» تنجح جزئيًا فقط. فالضبط الدقيق يساعد فعلًا في تحسين سلوك النموذج في مجال محدد، والالتزام بصيغة الإجابة، وتقليل الانزلاق إلى الخيال الواضح. لكنه لا يحوّل النموذج إلى نظام لا يعرف سوى الحقائق الموثَّقة، ولا يضمن أن يتوقف عند نقص البيانات. فالنموذج لا يزال يُحسَّن لإنتاج نص مقنع، لا لصحة كل عبارة. وحتى النماذج الكبيرة المضبوطة جيدًا تواصل الخطأ في الحالات النادرة والأحداث الحديثة والموضوعات شديدة التخصص وسلاسل الاستدلال الطويلة. وكلما زادت الخطوات بين السؤال والجواب، زادت فرص ظهور افتراض غير دقيق في إحدى الحلقات. ولذلك لا تُحل
ما أبرز التفاصيل حول كيف نقلّل المخاطر؟
النهج العملي ليس انتظار سلوك مثالي من LLM، بل بناء طبقات حماية حوله. وكلما ارتفعت كلفة الخطأ على الأعمال، وجب أن يتضمن خط المعالجة (pipeline) مزيدًا من الفحوص والقيود والقواعد الصريحة للامتناع عن الإجابة. وهذا يغيّر منطق التبنّي: بدل السؤال «كيف نجعل النموذج لا يخطئ أبدًا» يظهر سؤال آخر: كيف نمنع الخطأ من أن يتحول إلى حادثة. وهذه مسألة تصميم نظام، لا سحر نموذج. ربط retrieval وإلزام النموذج بالإجابة فقط استنادًا إلى المستندات التي عُثر عليها اشتراط الإحالة إلى مقاطع محددة من البيانات، لا إلى مصادر مجرّدة الفصل بين التوليد والتحقق: خطوة تكتب الإجابة وأخرى تتحقق من الحقائق وال
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.