MIT تعلّم الذكاء الاصطناعي التوليدي إكمال الأجسام المخفية انطلاقًا من الإشارات اللاسلكية
حسّن MIT «الرؤية» اللاسلكية للروبوتات: يكمل نموذج توليدي الأجزاء المخفية من الأجسام اعتمادًا على انعكاسات إشارات mmWave القريبة من Wi-Fi. ويتفوق نظام Wave-Former على الأساليب السابقة بدقة أعلى بنحو 20%، بينما يستطيع نظام RISE إعادة بناء غرفة كاملة بالاعتماد على رادار ثابت واحد وحركة شخص داخلها. قد تفيد هذه التقنية في المستودعات والمنازل الذكية، وفي السيناريوهات التي لا يُحبَّذ فيها استخدام الكاميرات بسبب الخصوصية.
معالج بواسطة الذكاء الاصطناعي من MIT News؛ بتحرير Hamidun News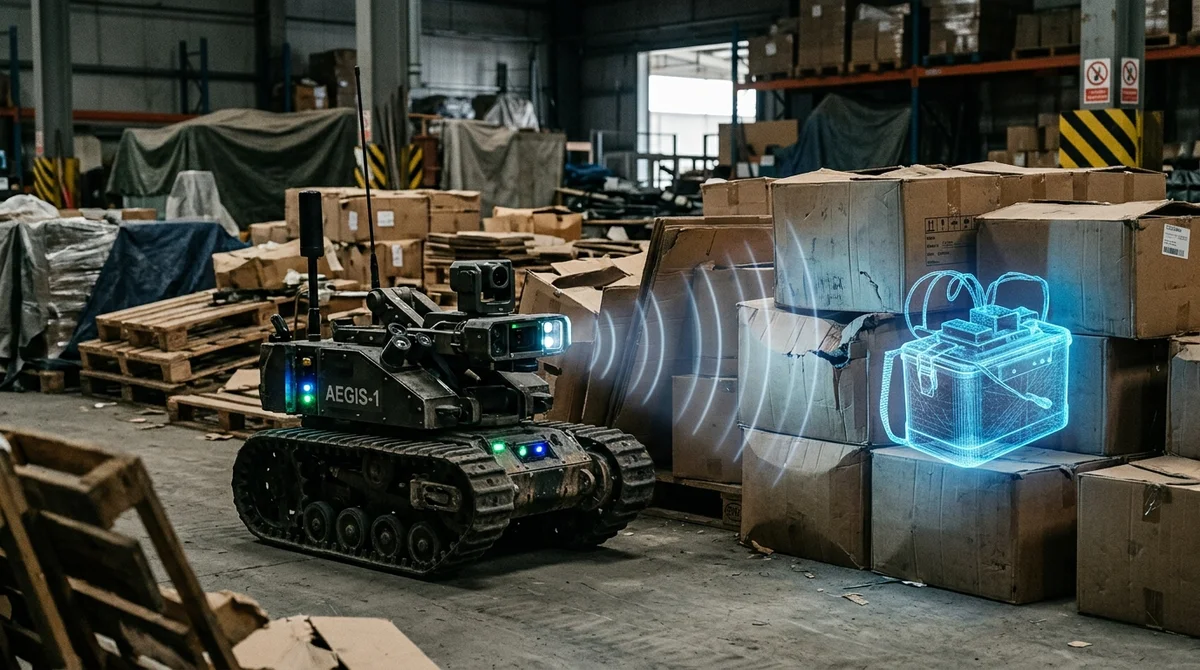
حسّن باحثو MIT نظام «رؤية» لاسلكيًا يتعرّف على الأجسام المخفية خلف الحواجز عبر انعكاسات إشارات النطاق المليمتري. ويقوم نموذج توليدي الآن بإكمال الأجزاء الناقصة من الشكل، ما يساعد الروبوتات على فهم أدق لما يوجد خلف الكرتون أو البلاستيك أو الألواح الجبسية أو القماش.
كيف يعمل النظام
كانت الإصدارات السابقة من هذه الأنظمة قادرة بالفعل على استخدام إشارات mmWave لبناء نموذج ثلاثي الأبعاد تقريبي لجسم مخبّأ خلف عائق. وكانت المشكلة في فيزياء الانعكاس: غالبًا ما تنحرف الموجات في اتجاه واحد بدلًا من أن ترتد إلى المستشعر. ولذلك كان النظام عادةً «يرى» الجزء العلوي من الجسم فقط، بينما تبقى الأسطح الجانبية والسفلية مناطق فارغة. وهذا أمر حاسم للروبوت: فإذا أُعيد بناء الشكل بدقة غير كافية، يصعب على الذراع الروبوتية تحديد كيفية الإمساك بالجسم بأمان ووضعيته في الفراغ.
ولتجاوز هذا القيد، أضاف فريق MIT نموذجًا توليديًا يتلقى إعادة بناء ناقصة ويكمل منها شكلًا معقولًا متكاملًا. لكن بيانات mmWave الحقيقية لم تكن كافية للتدريب، فلجأ الباحثون إلى حل التفافي: أخذوا مجموعات بيانات حاسوبية كبيرة من الصور وكيّفوها مع خصائص الانعكاسات اللاسلكية، بما فيها الانعكاس المرآتي والضجيج. وعلى هذه القاعدة الاصطناعية دربوا نظام Wave-Former. يقترح النظام أولًا أسطحًا محتملة للجسم بناءً على الانعكاسات، ثم يكمل النموذج الفجوات، وبعد ذلك تُصقَل الهندسة للوصول إلى إعادة بناء ثلاثية الأبعاد كاملة.
الدقة والمشاهد
في الاختبارات، أعاد Wave-Former بناء أشكال نحو 70 جسمًا من الأغراض اليومية، من العلب والصناديق إلى الفواكه وأدوات المطبخ. وقد أُخفيت الأجسام خلف الكرتون والخشب والألواح الجبسية والبلاستيك والقماش، أو وُضعت تحت هذه المواد. ووفق بيانات MIT، حقق النظام الجديد إعادة بناء أدق بنحو 20 في المئة مقارنة بأفضل الأساليب السابقة.
عمليًا، هذه خطوة مهمة: فالنظام لا يكتفي برصد وجود جسم ما، بل يقترب من فهم شكله الفعلي وحجمه وحدوده.
«نستخدم الذكاء الاصطناعي لإطلاق إمكانات الرؤية اللاسلكية أخيرًا»، يقول
قائد العمل فادل أديب.
ولم يتوقف الفريق عند هذا الحد، إذ بنى نظامًا ثانيًا هو RISE، لا يعيد بناء جسم منفرد بل غرفة كاملة. ويكفيه لذلك رادار ثابت واحد وحركة شخص داخل الغرفة. فحين يمشي الشخص، ينعكس جزء من الإشارة عنه، ثم عن الجدران والأثاث، ثم يعود إلى المستشعر. وعادةً تُعدّ هذه الانعكاسات الثانوية ضجيجًا وتُهمَل، لكن MIT درّب النموذج على استخلاص تخطيط المشهد منها. وفي تجارب شملت أكثر من 100 مسار لحركة الأشخاص، كان RISE في المتوسط أدق بنحو الضعف من الأساليب الحالية.
أين قد تفيد هذه التقنية
القيمة العملية هنا لا تكمن في الدقة فقط، بل في طريقة الاستخدام أيضًا. فتحليل المشهد لا يتطلب روبوتًا متحركًا مزوّدًا بمستشعر يتنقل في أرجاء المكان ويمسحه من نقاط مختلفة. ويكفي رادار واحد ثابت. كما أن الطريقة لا تعتمد على الكاميرات التقليدية، ما يجعلها أنسب للسيناريوهات التي تكتسب فيها خصوصية الأشخاص في المشهد أهمية.
- فحص محتويات الصناديق والعبوات قبل الشحن
- البحث عن أغراض تحجبها أشياء أخرى في مستودع أو في المنزل
- إعادة بناء تخطيط الغرفة بمستشعر ثابت واحد
- تحديد موضع الشخص لجعل حركة الروبوت أكثر أمانًا
- السيناريوهات التي لا يُحبَّذ فيها استخدام الكاميرات بسبب الخصوصية
وإذا أصبحت التقنية أكثر تفصيلًا وثباتًا، فستتاح لها فرصة الخروج من حدود المختبر. ويقول فريق MIT صراحةً إن الخطوة التالية هي نماذج أساسية أكبر للإشارات اللاسلكية، على غرار ما تفعله GPT وClaude وGemini مع النصوص والصور. وقد يحوّل هذا النهج الاستشعار اللاسلكي من أداة بحثية ضيقة إلى طبقة إدراك شاملة للروبوتات والمساحات الذكية.
ماذا يعني ذلك
يُظهر MIT تحولًا لافتًا: فبدلًا من استخلاص أقصى ما يمكن من كل انعكاس يدويًا، يُسند الباحثون إلى نموذج توليدي مهمة تخمين الهندسة المفقودة انطلاقًا من بيانات جزئية. وإذا أمكن توسيع هذا النهج، فستتمكن الروبوتات من «الرؤية» خلف الحواجز بثقة أكبر في الحالات التي تكون فيها الكاميرا العادية عديمة الفائدة أو غير مرغوب فيها.
Access Frontier LLMs & Multimodal AI in One Workspace
Discover NomadNet AI (nomadnet.ai) — unified access to frontier language models, research synthesis, and multimodal workflows.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.