سبيربنك يستعرض كيف تحوّل RAG وLLM داخل بيئة التطوير السيناريوهات اليدوية إلى اختبارات آلية
استعرض سبيربنك نموذجًا أوليًا لبيئات JetBrains IDE يولّد اختبارات آلية انطلاقًا من السيناريوهات اليدوية، باستخدام LLM مع RAG. يبحث النظام عن الخطوات والاختبارات ذات الصلة داخل المشروع نفسه، ويحافظ على أسلوب الشيفرة، ويتحقق من النتيجة عبر PSI. داخل الشركة، لم تتطلب 68% من الاختبارات المولَّدة سوى تعديلات طفيفة، وبلغ رضا المستخدمين نحو 80%.
معالج بواسطة الذكاء الاصطناعي من Habr AI؛ بتحرير Hamidun News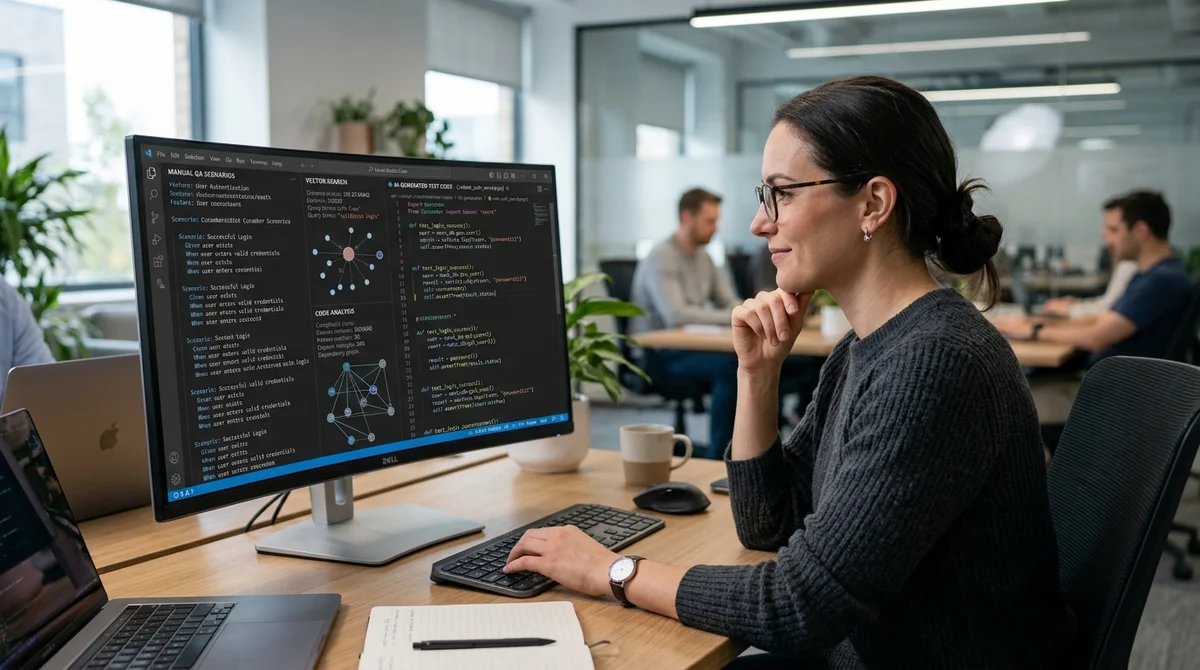
استعرض سبيربنك طريقة لتقليص إحدى أكثر المهام روتينية في ضمان الجودة (QA): تحويل السيناريوهات اليدوية إلى اختبارات آلية مباشرة داخل بيئة التطوير (IDE). يقوم الحل على الجمع بين LLM وRAG؛ فهو لا يكتفي بكتابة الشيفرة، بل يبحث أولًا عن أمثلة ذات صلة في المشروع نفسه، حتى يحافظ على أسلوبه واصطلاحاته وبنيته المعمارية.
لماذا لا ينجح الأمر المباشر (prompt)؟
تفشل فكرة «إرسال الاختبار اليدوي إلى النموذج والحصول على شيفرة جاهزة» عند التطبيق العملي بسبب التفاصيل. يستطيع LLM فعلًا تجميع اختبار Java يعمل، لكنه على الأرجح لن ينفّذه بالطريقة المعتمدة في الفريق المعني: سينسى Allure، وسيخالف نظام التسمية، ويضع عنوان URL وجسم الطلب في غير موضعهما، وسيضيف فحوصات زائدة، أو لن يستخدم الأدوات الداخلية مثل الدالة المشتركة للتحقق من الحالة. وفي أتمتة الاختبارات لا يُعد هذا أمرًا شكليًا، بل فقدانًا فعليًا للتوافق مع المشروع.
والمشكلة أعمق من جودة الـ prompt. فالاختبارات الآلية تعيش داخل إطار عمل خاص بها، وترتبط بالبنية المعمارية وبـ CI وPage Object ومفاتيح TMS واصطلاحات التعليقات التوضيحية (annotations). وإذا حاولنا تمرير المشروع كاملًا إلى النموذج، فسرعان ما نصطدم بحدود نافذة السياق وارتفاع زمن الاستجابة وكلفة الطلبات. وحتى بعد ذلك تبقى الهلوسات وتخطّي الخطوات والنتائج غير المستقرة، التي يضطر المطوّر إلى تصحيحها يدويًا.
كيف يعمل RAG
بدلًا من few-shot ثابت بأمثلة تُنتقى يدويًا، طوّر فريق سبيربنك إضافة لبيئات JetBrains IDE. تفحص الإضافة المشروع عبر بنية PSI لا بوصفه نصًا خامًا، ولذلك ترى الأصناف والدوال والتعليقات التوضيحية واستدعاءات الدوال. وعلى هذا الأساس يجمع النظام خطوات Allure والاختبارات الآلية القائمة ومفاتيح TMS الخاصة بها وشيفرتها مع أوصاف نصية موجزة. بعد ذلك تُحوَّل هذه الأوصاف إلى embeddings وتُحفظ مع البيانات الوصفية في قاعدة معرفة محلية أو مخزن متجهات.
عندما يصل سيناريو يدوي جديد، يمر النظام بعدة مراحل:
- يستخرج الإجراء والنتيجة المتوقعة لكل خطوة؛
- يبني عدة صيغ دلالية للاستعلام للبحث عن خطوات مشابهة؛
- يطلب من LLM وصفًا موجزًا للاختبار كله بغرض العثور على اختبار آلي قريب منه في المعنى؛
- يُدرج الأمثلة التي عثر عليها في الـ prompt تلقائيًا بدلًا من few-shot اليدوي؛
- يتحقق من النتيجة بطلب ثانٍ إلى النموذج وعبر PSI داخل بيئة التطوير.
يتيح هذا النهج الحصول على شيفرة تبدو كأن كاتبها أحد أفراد الفريق نفسه، لا نموذج خارجي بلا سياق. وتشدد المقالة تحديدًا على أن البحث الدلالي ليس غايته مجاراة موضة RAG، بل هدف عملي: جلب الخطوات والأدوات والأنماط التي أثبتت جدواها داخل المشروع إلى عملية التوليد.
RAG هو few-shot يعثر بنفسه على الأمثلة المناسبة.
نتائج النموذج الأولي
بحسب بيانات الفريق، حقق النموذج الأولي الداخلي أثرًا قابلًا للقياس. كان نحو 68% من الاختبارات المولَّدة بمستوى مقبول ولم يتطلب سوى تعديلات طفيفة، وبلغ رضا المستخدمين العام نحو 80%. وأظهرت الأداة أفضل أداء في سيناريوهات API البسيطة والمتشابهة، حيث تبرز الحاجة إلى إعادة إنتاج قالب شيفرة مستقر بسرعة من دون النسخ اليدوي من الاختبارات المجاورة.
ولاحظ مختصو الأتمتة كذلك انخفاضًا في العبء المعرفي: يقل الوقت المهدور على الروتين، ويزيد الوقت المخصص للسيناريوهات المعقدة والقرارات المعمارية. لكن لا وجود هنا لـ«طيار آلي» شامل. فما زال النموذج يميل إلى تبسيط الاختبارات المعقدة ذات الخطوات الكثيرة، ويحتاج في سيناريوهات UI إلى سياق أكبر، مثل معلومات عن عناصر الصفحة. كما لم تختفِ الهلوسات، ولذلك تبقى المراجعة النهائية إلزامية.
وفي الوقت نفسه يشير المؤلفون إلى أنهم لم يلحظوا قيودًا جدية تتعلق باللغات: فقد تحققت نتائج مماثلة لا على Java فحسب، بل على Python وGherkin أيضًا. وبتقديرهم، يمكن لهذه الأداة أن توفر على مختص الأتمتة أكثر من نصف الوقت المخصص لكتابة اختبارات روتينية جديدة.
ماذا يعني ذلك
تبدأ مرحلة أكثر إثارة للاهتمام في أدوات الذكاء الاصطناعي للتطوير: تنتقل القيمة من «توليد أي شيفرة» إلى «توليد شيفرة تندمج فورًا في مشروع حيّ». وتُظهر تجربة سبيربنك أن الفائز في ضمان الجودة لن يكون الفرق التي تكتفي بربط LLM ببيئة التطوير، بل تلك التي تحيط النموذج بقاعدة معرفتها الخاصة وبفحوصاتها وقواعدها الهندسية.
Access Frontier LLMs & Multimodal AI in One Workspace
Discover NomadNet AI (nomadnet.ai) — unified access to frontier language models, research synthesis, and multimodal workflows.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.