Qdrant وDRAG with KNEE: كيف نجعل RAG تكيفيًا دون إهدار الرموز
يعالج هذا النهج الخلل الرئيسي في RAG التقليدي: فإما سياق فارغ، وإما كتلة نصية زائدة تُحمَّل على الـ LLM. يبني نهج DRAG with KNEE، القائم على Qdrant وPython، تسلسلًا هرميًا للمستندات، ويبحث عن نقطة الانعطاف في منحنى الصلة، ثم يقتطع ذيل المقاطع غير ذات الصلة. الفكرة أن يحصل النموذج على القدر اللازم من السياق لكل استعلام بعينه، لا أقل ولا أكثر.
معالج بواسطة الذكاء الاصطناعي من Habr AI؛ بتحرير Hamidun News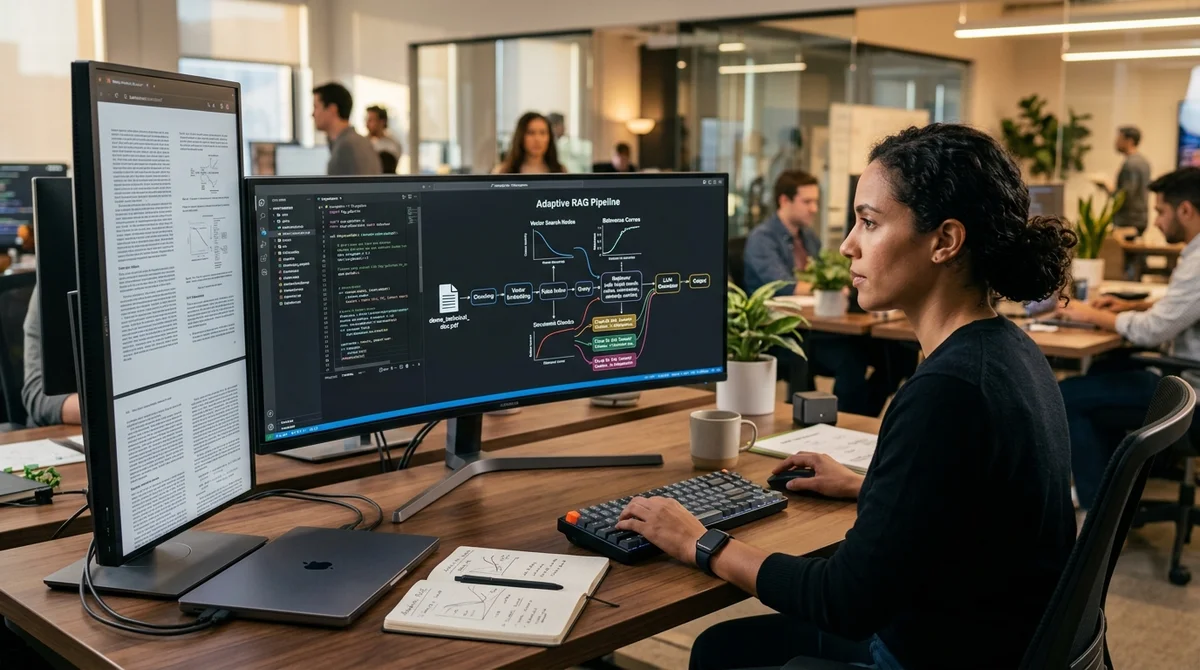
صدر تحليل عملي لكيفية جعل نظام RAG أقل استهلاكًا للموارد وأكثر دقة. يتمحور التحليل حول DRAG with KNEE، وهو نهج قائم على Qdrant وPython يحدّد حجم السياق ديناميكيًا بدلًا من الاعتماد على قيمة ثابتة لـ top_k.
لماذا يفشل top_k الثابت
واجه تقريبًا كل من بنى نظام RAG فوق ملفات PDF طويلة المشكلة نفسها. إذا أخذتَ عددًا قليلًا جدًا من المقاطع (chunks)، لا يرى النموذج السياق المهم فيبدأ باختلاق ما ينقصه. وإذا أخذتَ عددًا كبيرًا جدًا، يتسرب الضجيج إلى الـ prompt، وترتفع معه التكلفة وزمن الاستجابة، ويزداد خطر أن يتعلق الـ LLM بمقطع عشوائي. في هذا المخطط يحاول معامل top_k الواحد حلّ مهام شديدة التباين، وهو يفعل ذلك بشكل سيئ في الغالب.
يصف الكاتب هذا التنازل بأنه ضعف جوهري في RAG التقليدي. فالعدد الثابت من المستندات لا يراعي نوع الاستعلام، ولا بنية الملف الأصلي، ولا كثافة المعلومات المفيدة داخل المجموعة. قد تكفي مقطعان لسؤال عن معلومة قصيرة، لكنهما لا يكفيان لسؤال معقد عن مستند متعدد الصفحات. والنتيجة أن النظام إما يُقدِّم للنموذج سياقًا أقل مما يحتاج، أو يُغرقه بنص غير ذي صلة ويهدر ميزانية الرموز (tokens).
كيف يعمل DRAG
فكرة DRAG with KNEE ألا يكتفي النظام بالبحث عن مقاطع متشابهة، بل ينظر أولًا إلى المستندات بوصفها تسلسلًا هرميًا، ثم يقرر ديناميكيًا أين يتوقف الانتقاء. وبدلًا من حد صارم، يحلل الخوارزم توزيع الصلة ويبحث عن نقطة انعطاف، أي «الركبة» التي تتناقص بعدها فائدة المقاطع المضافة. وكل ما يقع في الذيل الطويل بعد هذه النقطة يمكن حذفه دون خسارة ملحوظة في المعنى.
عمليًا، يبدو ذلك كاستراتيجية أكثر تكيفًا لاستخراج السياق. فلا يلزم النظام بإرجاع العدد نفسه من المقاطع لكل استعلام: ثلاثة في حالة، وعشرة في أخرى، وفي ثالثة عدة مجموعات مترابطة من أجزاء مختلفة من المستند. وبذلك يتكيف RAG مع البنية الفعلية للمعرفة لا مع ثابت اختير مسبقًا.
- في البداية تُحدَّد المقاطع المرشحة بحسب التقارب المتجهي
- ثم تُجمَّع وتُرتَّب بحسب المستندات والمستويات
- بعد ذلك يبحث الخوارزم عن النقطة التي تبدأ عندها الفائدة بالانخفاض الحاد
- ولا يدخل في السياق النهائي سوى النواة ذات الصلة، دون ذيل الضجيج الطويل
يفيد هذا النهج بوجه خاص حين لا تكون المعرفة مخزّنة في قاعدة FAQ مرتبة، بل في تعليمات متفرقة وتقارير ولوائح وملفات PDF كبيرة. في مثل هذه المجموعات، لا تعني المسافات بين المقاطع الكثير بحد ذاتها ما لم يؤخذ في الحساب كيف ترتبط هذه المقاطع ببعضها وكم تتراجع قيمتها للإجابة بسرعة. وهنا يتحول التحليل الهندسي من زينة رياضية إلى مرشِّح عملي.
ما دور Qdrant هنا
من نقاط قوة المقال أنه لا ينجرف إلى النظرية المحضة. فالكاتب يوضح كيف يمكن بناء هذا الـ pipeline باستخدام Qdrant وPython، أي على حزمة تقنية مألوفة تُستخدم أصلًا في كثير من مشاريع RAG. يتولى Qdrant البحث المتجهي والتعامل مع المقاطع المرشحة، بينما يضيف منطق DRAG with KNEE فوقه طبقة تكيّف: لا يكفي العثور على المتشابه، بل يجب تحديد كم من المتشابه يلزم فعلًا تقديمه للنموذج في هذه اللحظة.
وهذه إشارة مهمة للفرق التي طبّقت الاسترجاع (retrieval) التقليدي واصطدمت بسقف جودة الإجابات أو بتكاليف الـ inference. فقد لا تكمن المشكلة في الـ embeddings ولا في الـ LLM نفسه، بل في طريقة تقطيع السياق وتقديمه. وباستبدال top_k الثابت بقطع ديناميكي عند نقطة الانعطاف، يمكن خفض الضجيج وتحسين الدقة في آن واحد دون إعادة بناء البنية بالكامل.
ماذا يعني ذلك
يبتعد RAG تدريجيًا عن الضبط الفج بمنطق «معامل واحد لكل الحالات». ويُظهر طرح DRAG with KNEE تحولًا بسيطًا لكنه مهم: المستوى التالي من الجودة لا يقتصر على بحث جيد، بل يشمل أيضًا القدرة على التوقف في الوقت المناسب، كي يحصل الـ LLM على سياق كافٍ للإجابة لا على تخمة نصية عشوائية.
أسئلة وأجوبة حول الخبر
ما أبرز التفاصيل حول لماذا يفشل top_k الثابت؟
واجه تقريبًا كل من بنى نظام RAG فوق ملفات PDF طويلة المشكلة نفسها. إذا أخذتَ عددًا قليلًا جدًا من المقاطع (chunks)، لا يرى النموذج السياق المهم فيبدأ باختلاق ما ينقصه. وإذا أخذتَ عددًا كبيرًا جدًا، يتسرب الضجيج إلى الـ prompt، وترتفع معه التكلفة وزمن الاستجابة، ويزداد خطر أن يتعلق الـ LLM بمقطع عشوائي. في هذا المخطط يحاول معامل top_k الواحد حلّ مهام شديدة التباين، وهو يفعل ذلك بشكل سيئ في الغالب. يصف الكاتب هذا التنازل بأنه ضعف جوهري في RAG التقليدي. فالعدد الثابت من المستندات لا يراعي نوع الاستعلام، ولا بنية الملف الأصلي، ولا كثافة المعلومات المفيدة داخل المجموعة. قد تكفي
ما أبرز التفاصيل حول كيف يعمل DRAG؟
فكرة DRAG with KNEE ألا يكتفي النظام بالبحث عن مقاطع متشابهة، بل ينظر أولًا إلى المستندات بوصفها تسلسلًا هرميًا، ثم يقرر ديناميكيًا أين يتوقف الانتقاء. وبدلًا من حد صارم، يحلل الخوارزم توزيع الصلة ويبحث عن نقطة انعطاف، أي «الركبة» التي تتناقص بعدها فائدة المقاطع المضافة. وكل ما يقع في الذيل الطويل بعد هذه النقطة يمكن حذفه دون خسارة ملحوظة في المعنى. عمليًا، يبدو ذلك كاستراتيجية أكثر تكيفًا لاستخراج السياق. فلا يلزم النظام بإرجاع العدد نفسه من المقاطع لكل استعلام: ثلاثة في حالة، وعشرة في أخرى، وفي ثالثة عدة مجموعات مترابطة من أجزاء مختلفة من المستند. وبذلك يتكيف RAG مع البني
ما أبرز التفاصيل حول ما دور Qdrant هنا؟
من نقاط قوة المقال أنه لا ينجرف إلى النظرية المحضة. فالكاتب يوضح كيف يمكن بناء هذا الـ pipeline باستخدام Qdrant وPython، أي على حزمة تقنية مألوفة تُستخدم أصلًا في كثير من مشاريع RAG. يتولى Qdrant البحث المتجهي والتعامل مع المقاطع المرشحة، بينما يضيف منطق DRAG with KNEE فوقه طبقة تكيّف: لا يكفي العثور على المتشابه، بل يجب تحديد كم من المتشابه يلزم فعلًا تقديمه للنموذج في هذه اللحظة. وهذه إشارة مهمة للفرق التي طبّقت الاسترجاع (retrieval) التقليدي واصطدمت بسقف جودة الإجابات أو بتكاليف الـ inference. فقد لا تكمن المشكلة في الـ embeddings ولا في الـ LLM نفسه، بل في طريقة تقطيع ا
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.