Habr AI يحلل كيف يقود منفذ مفتوح واحد في منصة LLM إلى المفاتيح والبنية التحتية
كشف تدقيق أمني لمنصة RAG كبيرة حقيقة مزعجة: أخطر الثغرات لا تكمن غالبًا في الأوامر النصية (prompts) أو LangChain أو ثغرات CVE غريبة، بل في البنية التحتية الأساسية. فقد قضى الباحثون أسبوعين في فحص هجمات SSRF والحقن وإلغاء التسلسل (deserialization)، لكنهم حصلوا على وصول حرج بطلب عادي إلى منفذ مفتوح. والخلاصة بسيطة: لا يمكن حماية خدمات الذكاء الاصطناعي على مستوى النموذج وحده، بل يلزم تحكم صارم في الشبكة والأسرار والخدمات الداخلية.
معالج بواسطة الذكاء الاصطناعي من Habr AI؛ بتحرير Hamidun News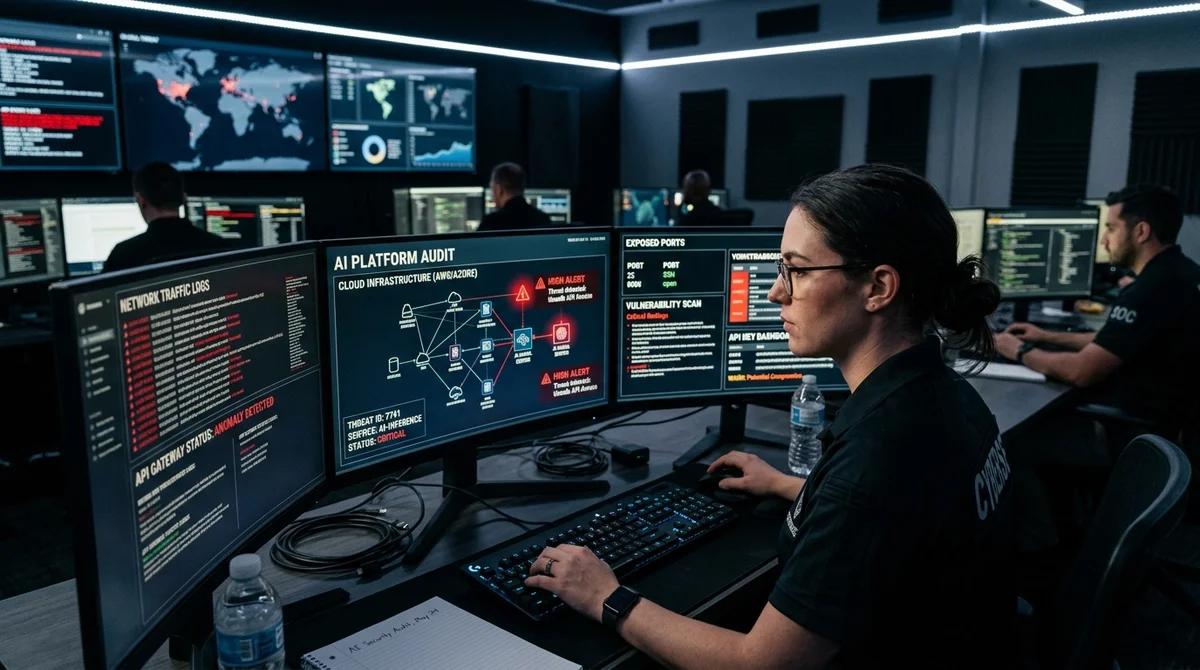
تكشف قصة من تدقيق منصة RAG كبيرة استنتاجًا مزعجًا لسوق الذكاء الاصطناعي: أغلى الحوادث كلفةً لا تبدأ غالبًا بهجوم «ذكي» على النموذج، بل بخطأ بسيط في البنية التحتية. فقد قضى الفريق أسبوعين في البحث عن ثغرات معقدة، لكنه حصل في النهاية على المفاتيح والخدمات الداخلية في دقائق معدودة.
كيف عُثر على الوصول
اختبر المدققون خدمة يستخدمها عشرات الآلاف من المستخدمين، وسلكوا في البداية المسار المتوقع لمنظومة LLM: فحصوا SSRF بالاقتران مع LangChain، وجرّبوا حقن الأوامر النصية (prompt injection)، وحللوا معالجة HTTP، وبحثوا عن ثغرات في إلغاء التسلسل. والمنطق واضح: فهذه هي الاتجاهات التي يُناقَش عادةً عند الحديث عن أمن أنظمة RAG والوكلاء (agents) وتطبيقات LLM. لكن أيًّا من السلاسل الطويلة لم يعطِ نتيجة عملية. أما الاكتشاف الحرج فلم يظهر في التطبيق، بل على مستوى بنية تحتية مغلقة بشكل سيئ.
«نفّذنا أمر curl واحدًا إلى منفذ مفتوح — وحصلنا على جميع المفاتيح خلال 5 دقائق».
تعبّر هذه العبارة جيدًا عن التناقض الرئيسي في المادة. ففي حين تخشى الصناعة هجمات غريبة على تنسيق النماذج، تبقى في بيئات الإنتاج الفعلية واجهات مفتوحة يمكن من خلالها الاطلاع على ملفات الإعدادات ومتغيرات البيئة الخدمية وعناوين URL الداخلية ورموز الوصول (tokens) إلى واجهات API الخارجية. وإذا كانت هذه الأسرار مخزَّنة بجوار المفاتيح العاملة، فإن اختراق خدمة واحدة يتحول بسرعة إلى اختراق المنصة بأكملها.
لماذا يحدث ذلك
نادرًا ما تعمل منصات LLM كخادم واحد بنموذج واحد. فهي عادةً مجموعة من الخدمات المصغّرة: بوابة API، ومنسّق للسلاسل، وقاعدة بيانات متجهية، ومخزن للملفات، وطوابير، ولوحات إدارة داخلية، ومزوّدو embeddings، والتسجيل (logging)، والمراقبة، والفوترة. وكل مكوّن جديد يضيف شبكة وأسرارًا وأدوارًا ونقاط تكامل. ونتيجة لذلك، قد يكون لدى الفريق واجهة مستخدم مضبوطة جيدًا ومصادقة أساسية، لكن المنافذ الداخلية أو لوحات التصحيح أو الحاويات ذات الصلاحيات الممتدة تكون معزولة بشكل ضعيف.
وتتفاقم المشكلة لأن شركات الذكاء الاصطناعي الناشئة كثيرًا ما تفكر في التهديدات على مستوى النموذج. فهي تناقش كثيرًا كسر القيود (jailbreak) وتسريب الأمر النصي للنظام (system prompt) والهلوسات وحماية سياق RAG، لكنها تؤجل ممارسات DevSecOps الكلاسيكية. ومع ذلك، فهذه الممارسات هي التي تحدد ما إذا كان بإمكان المهاجم الوصول إلى الأسرار أو البنية التحتية السحابية أو المفاتيح المدفوعة التي تبلغ قيمتها مئات الآلاف من الدولارات. فإذا كانت خدمة داخلية تستمع إلى الشبكة دون حاجة، وكانت الأسرار متاحة للعملية «تحسبًا»، فإن LLM لم يعد هنا المشكلة الرئيسية — بل يرفع فقط كلفة العواقب.
أين تكثر الأخطاء
تكمن فائدة المادة في أنها تعيد الحديث عن أمن خدمات الذكاء الاصطناعي إلى الأسئلة الأساسية للانضباط الهندسي. فحتى لو بُني التطبيق حول سلسلة معقدة من الاسترجاع (retrieval) والوكلاء وعدة نماذج، يبحث المهاجم دائمًا تقريبًا عن أرخص مسار. وكثيرًا ما يمر هذا المسار عبر أخطاء قديمة مألوفة لأي فريق عمل مع البنية التحتية السحابية والحاويات.
- منافذ وخدمات داخلية مفتوحة دون قوائم تحكم بالوصول (ACL) صارمة
- أسرار في متغيرات البيئة أو السجلات أو الإعدادات المتاحة للخدمات المجاورة
- صلاحيات زائدة للحاويات والمنفّذات (runners) وحسابات الخدمة
- غياب العزل بين طبقة RAG ولوحة الإدارة والبنية التحتية السحابية
- التركيز على prompt injection مع إهمال نظافة الشبكة
وهذا يعني للمنتج أنه لا يمكن اختزال التدقيق الأمني في اختبار الاختراق الهجومي (red teaming) للأوامر النصية. فالمطلوب جرد لجميع المكونات المحيطة بالنموذج: أي الخدمات مكشوفة للخارج، وأي المفاتيح متاحة لكل حاوية، وأين فُعّلت واجهات التصحيح، وكيف تُقيَّد حركة البيانات الصادرة والواردة، ومن يملك حق الوصول إلى السجلات ولقطات البيئة. وبدون ذلك، تبقى البنية التحتية عرضة للاختراق حتى مع حماية جيدة لطبقة التطبيق، ويتحول أي اختراق من خلل موضعي إلى حادث شامل يتضمن تسريب البيانات والميزانية والوصول إلى المزوّدين.
ماذا يعني ذلك
الخلاصة الرئيسية بسيطة: يجب حماية منتج الذكاء الاصطناعي لا بوصفه «سحرًا خاصًا قائمًا على LLM»، بل بوصفه منصة حرجة عادية تضم أسرارًا ثمينة ونطاق ضرر واسعًا. وإذا لم تكن البنية التحتية الأساسية مغلقة، فلن تنقذ أي نقاشات عن هجمات معقدة على النموذج — فباب مفتوح واحد سيكون أهم من بنية الذكاء الاصطناعي بأكملها.
أسئلة وأجوبة حول الخبر
ما أبرز التفاصيل حول كيف عُثر على الوصول؟
اختبر المدققون خدمة يستخدمها عشرات الآلاف من المستخدمين، وسلكوا في البداية المسار المتوقع لمنظومة LLM: فحصوا SSRF بالاقتران مع LangChain، وجرّبوا حقن الأوامر النصية (prompt injection)، وحللوا معالجة HTTP، وبحثوا عن ثغرات في إلغاء التسلسل. والمنطق واضح: فهذه هي الاتجاهات التي يُناقَش عادةً عند الحديث عن أمن أنظمة RAG والوكلاء (agents) وتطبيقات LLM. لكن أيًّا من السلاسل الطويلة لم يعطِ نتيجة عملية. أما الاكتشاف الحرج فلم يظهر في التطبيق، بل على مستوى بنية تحتية مغلقة بشكل سيئ. «نفّذنا أمر curl واحدًا إلى منفذ مفتوح — وحصلنا على جميع المفاتيح خلال 5 دقائق». تعبّر هذه العبارة ج
ما أبرز التفاصيل حول لماذا يحدث ذلك؟
نادرًا ما تعمل منصات LLM كخادم واحد بنموذج واحد. فهي عادةً مجموعة من الخدمات المصغّرة: بوابة API، ومنسّق للسلاسل، وقاعدة بيانات متجهية، ومخزن للملفات، وطوابير، ولوحات إدارة داخلية، ومزوّدو embeddings، والتسجيل (logging)، والمراقبة، والفوترة. وكل مكوّن جديد يضيف شبكة وأسرارًا وأدوارًا ونقاط تكامل. ونتيجة لذلك، قد يكون لدى الفريق واجهة مستخدم مضبوطة جيدًا ومصادقة أساسية، لكن المنافذ الداخلية أو لوحات التصحيح أو الحاويات ذات الصلاحيات الممتدة تكون معزولة بشكل ضعيف. وتتفاقم المشكلة لأن شركات الذكاء الاصطناعي الناشئة كثيرًا ما تفكر في التهديدات على مستوى النموذج. فهي تناقش كثيرً
ما أبرز التفاصيل حول أين تكثر الأخطاء؟
تكمن فائدة المادة في أنها تعيد الحديث عن أمن خدمات الذكاء الاصطناعي إلى الأسئلة الأساسية للانضباط الهندسي. فحتى لو بُني التطبيق حول سلسلة معقدة من الاسترجاع (retrieval) والوكلاء وعدة نماذج، يبحث المهاجم دائمًا تقريبًا عن أرخص مسار. وكثيرًا ما يمر هذا المسار عبر أخطاء قديمة مألوفة لأي فريق عمل مع البنية التحتية السحابية والحاويات. منافذ وخدمات داخلية مفتوحة دون قوائم تحكم بالوصول (ACL) صارمة أسرار في متغيرات البيئة أو السجلات أو الإعدادات المتاحة للخدمات المجاورة صلاحيات زائدة للحاويات والمنفّذات (runners) وحسابات الخدمة غياب العزل بين طبقة RAG ولوحة الإدارة والبنية التحتية
Build & Ship Production AI Apps with Vibe Coding
Join Zhemal Khamidun's hands-on Vibe Coding Intensive at hamidun.com/vibecoding — master Claude Code, Cursor, and autonomous agentic workflows.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.